
Datenstrategie im Mittelstand: Was sie ist, warum sie sich lohnt und wie Du startest
Was ist eine Datenstrategie? Einfach erklärt für Unternehmen im Mittelstand
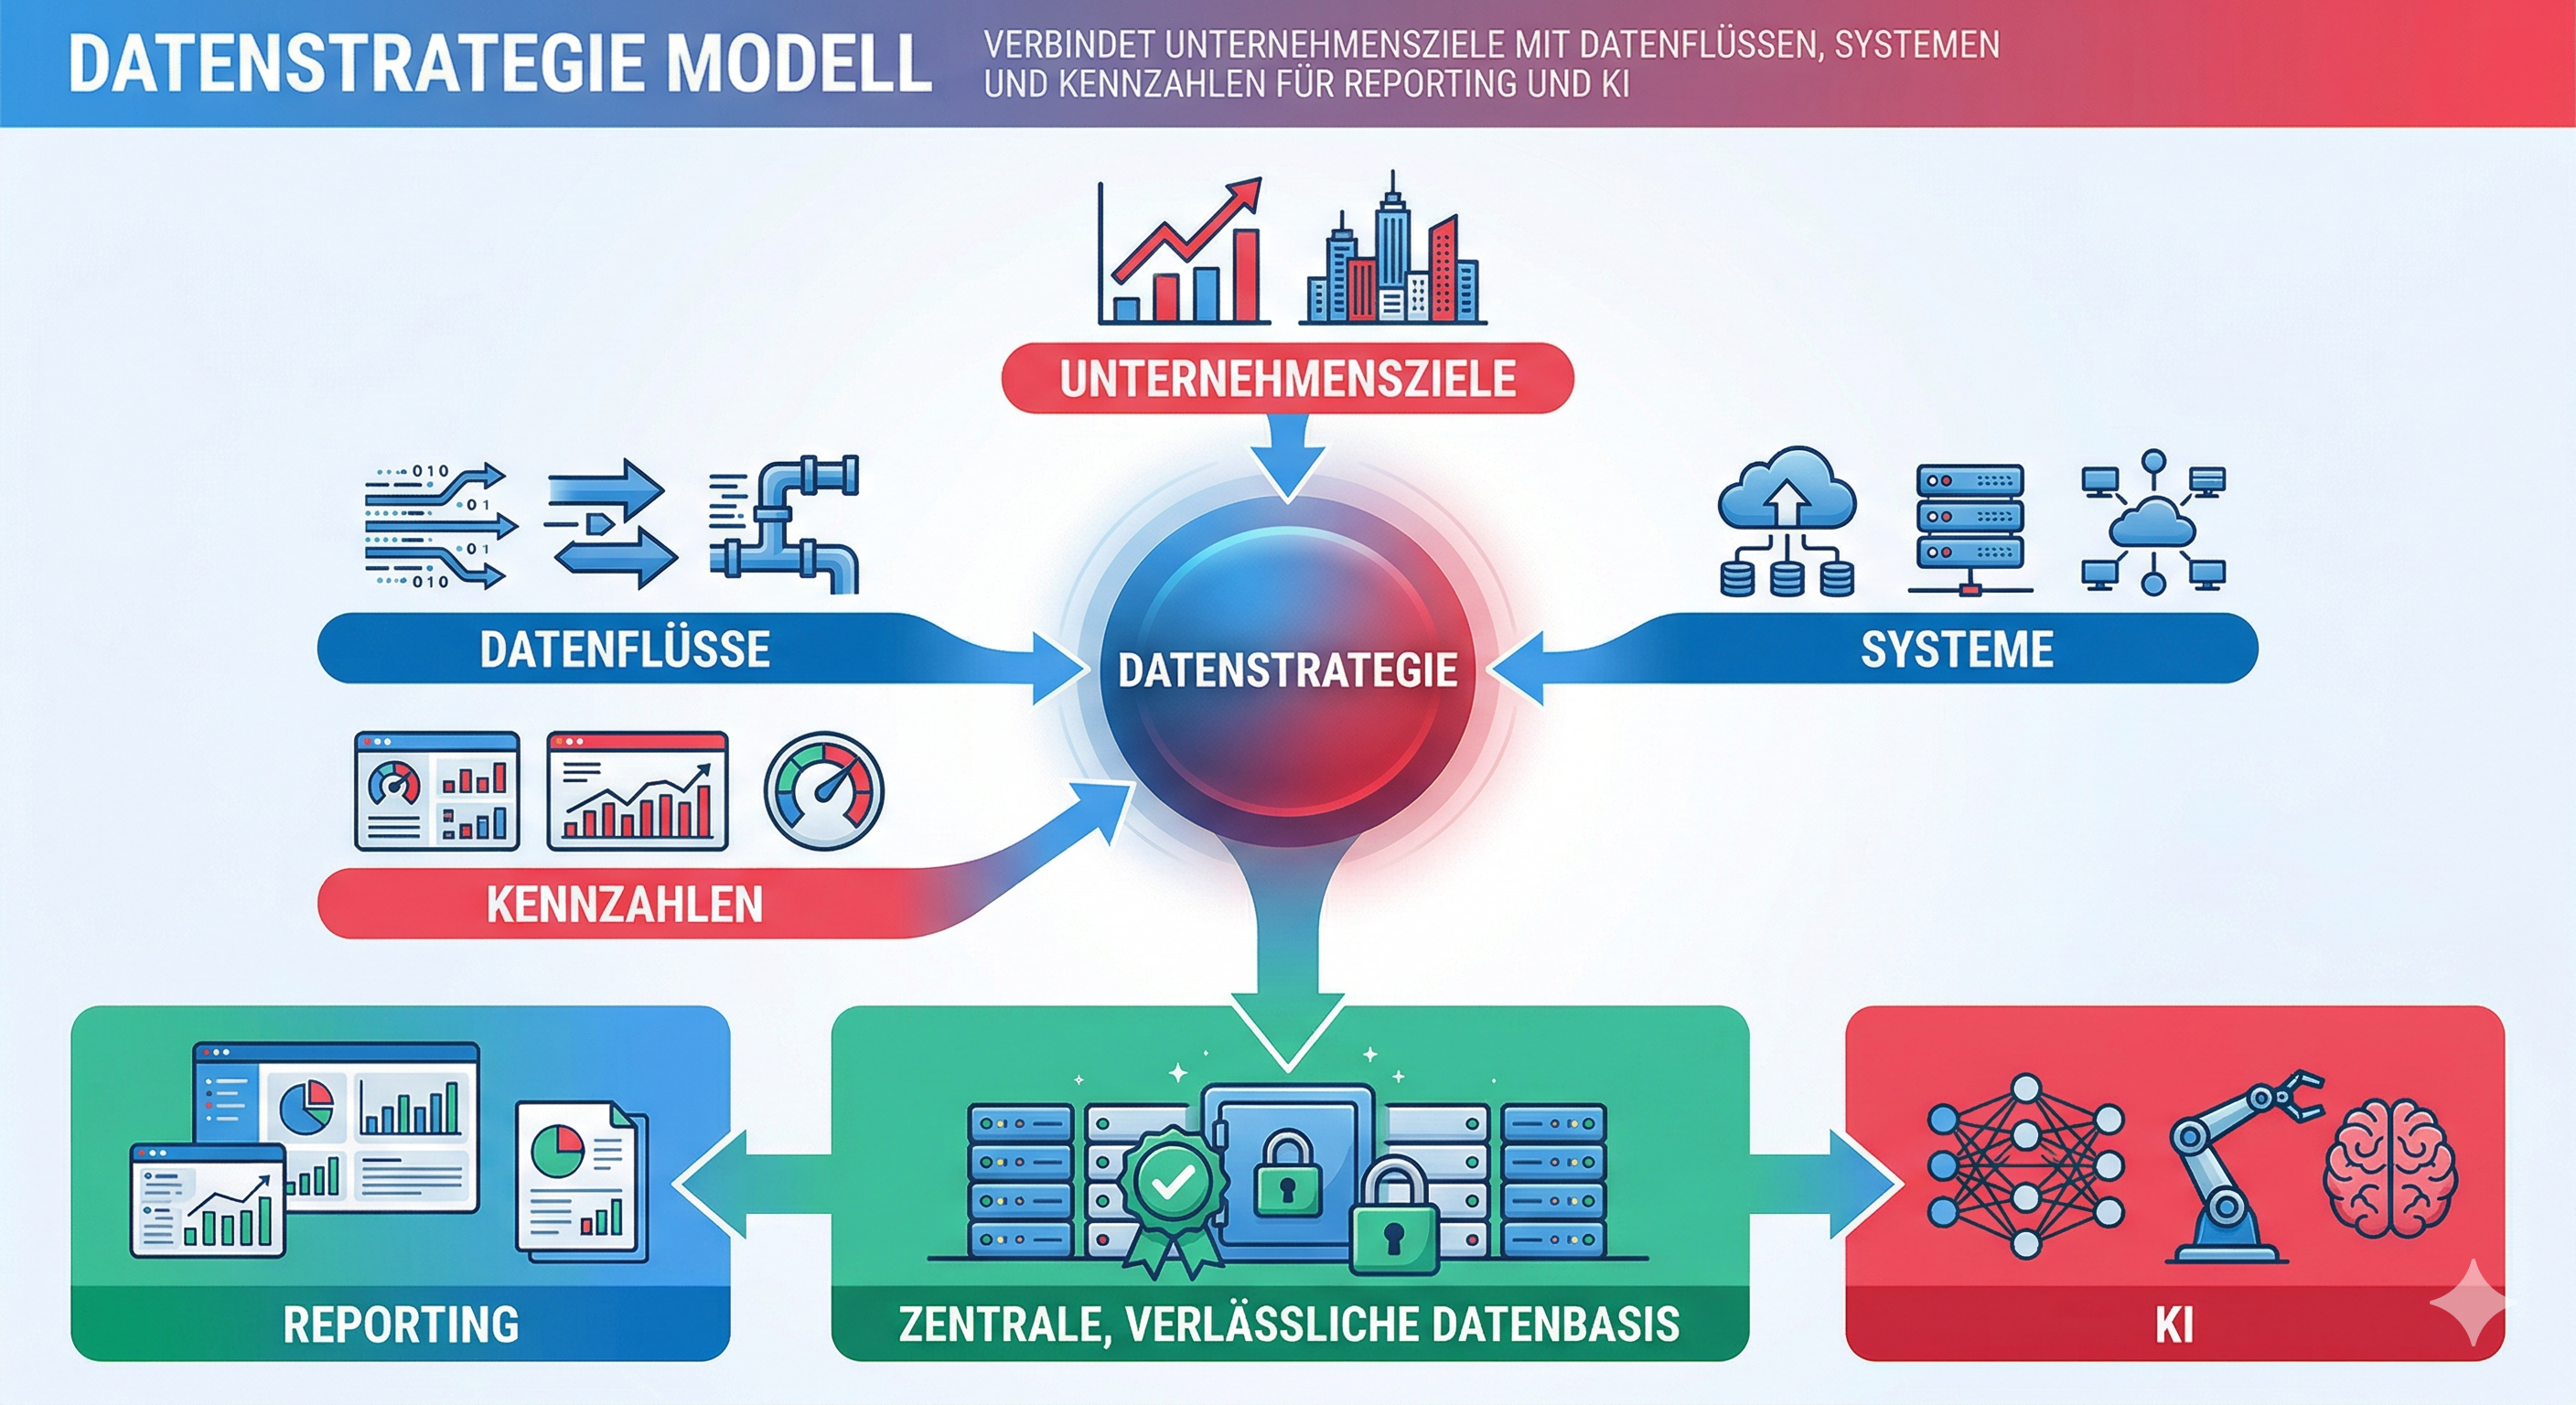
Eine Datenstrategie beschreibt, wie Dein Unternehmen Daten über den gesamten Lebenszyklus organisiert, schützt, verbessert und nutzbar macht – immer mit Blick auf konkrete Geschäftsziele, denn warum ist eine Datenstrategie unerlässlich? Sie legt fest, welche Daten Ihr braucht, wie Ihr sie einsammelt und verknüpft, wer wofür verantwortlich ist und wie daraus belastbare Reports, automatisierte Prozesse oder KI-Anwendungen entstehen.
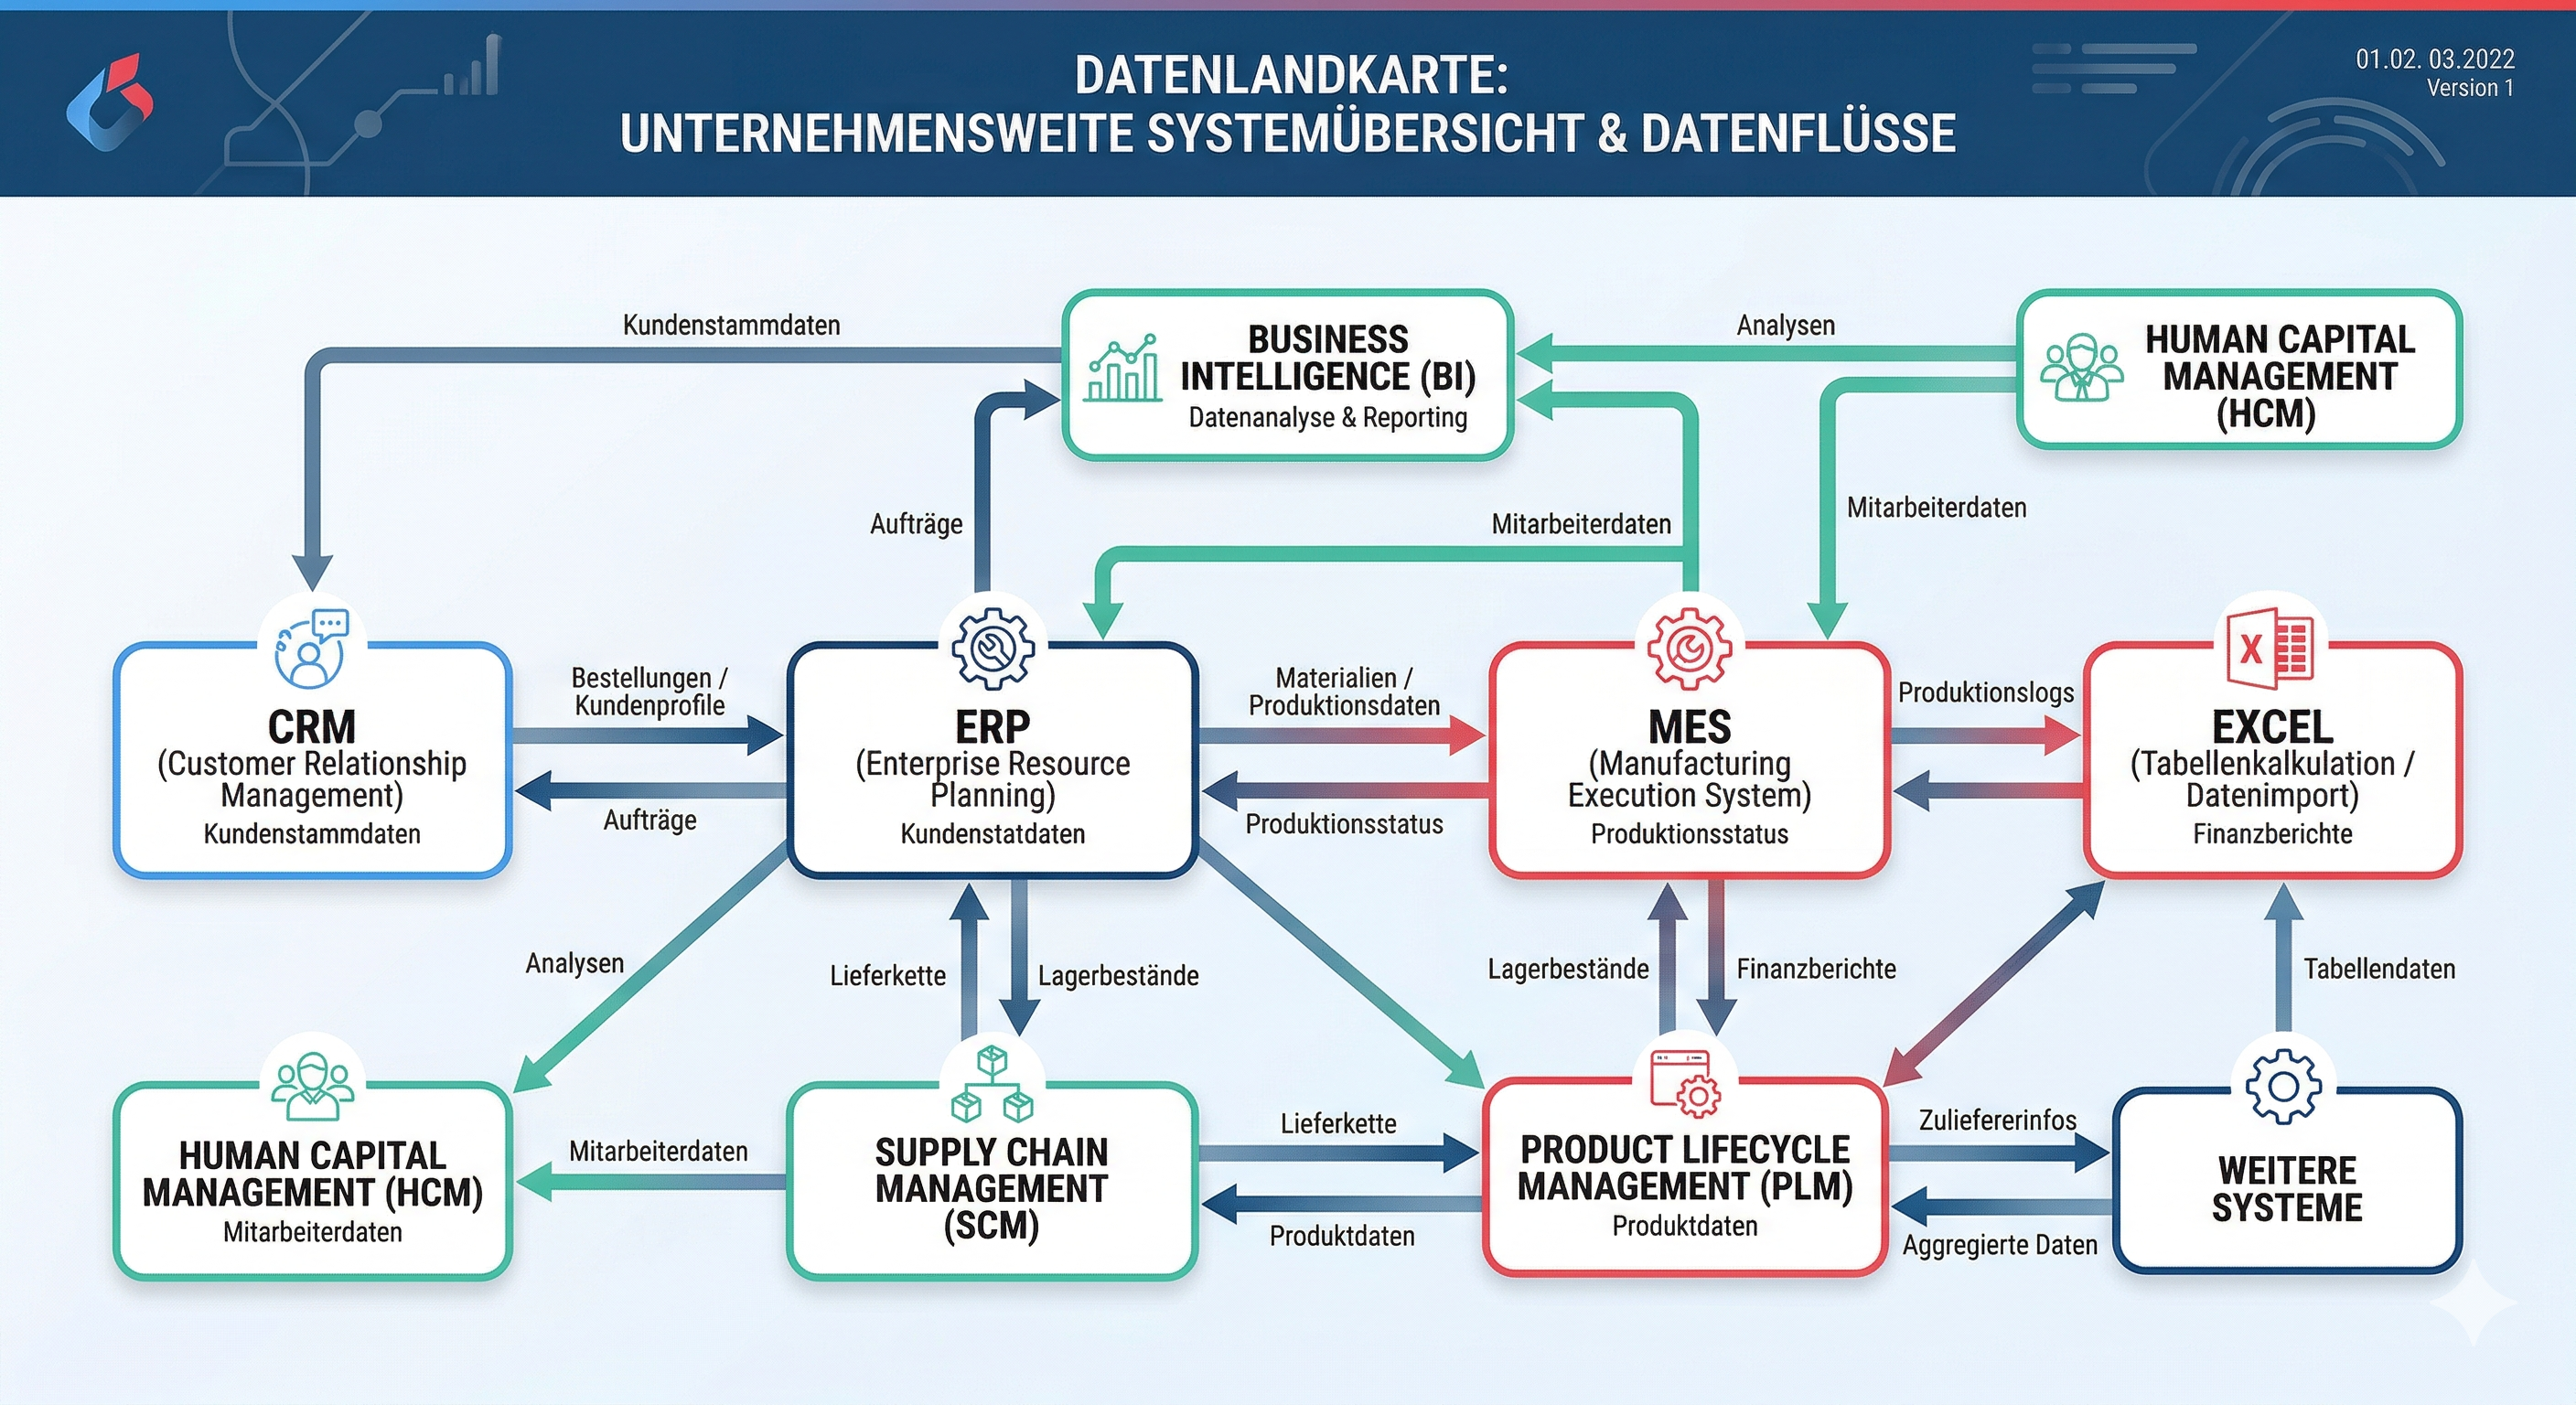
Für mittelständische Unternehmen mit ERP, MES, CRM, Excel-Landschaften und wachsendem Reportingdruck ist sie der rote Faden durch dieses Geflecht. Ohne diese Leitlinie wachsen Systeme und Datenmengen, aber der Nutzen bleibt begrenzt – genau das bestätigen aktuelle Studien und viele Projekt-Erfahrungen im Mittelstand.
Datenstrategie einfach erklärt: Definition und Abgrenzung zur IT-Strategie
Eine pragmatische Definition lautet: Eine Datenstrategie ist die verbindliche Leitlinie, wie Dein Unternehmen Daten nutzt, um geschäftliche Ziele zu erreichen – inklusive Rollen, Governance, Architekturprinzipien und Umsetzungs-Roadmap. Sie setzt damit den Rahmen, welche Datenfähigkeiten aufgebaut werden und in welcher Reihenfolge.
Im Unterschied zur IT-Strategie geht es nicht primär um Technologien, Infrastrukturen oder einzelne Tools. Die Datenstrategie beginnt bei Geschäftsfragen und Prozessen, etwa Liefertermintreue, Ausschussreduktion oder Cashflow-Steuerung, und leitet daraus ab, welche Daten, Strukturen und Verantwortlichkeiten nötig sind.
Warum Datenstrategie Chefsache ist und eng zur Unternehmensstrategie gehört
Ob Du neue Märkte erschließen, Produktionskapazitäten besser auslasten oder Service-Geschäft ausbauen willst: Daten liefern die Grundlage für Planung, Steuerung und Priorisierung. Eine Datenstrategie ist deshalb kein IT-Unterprojekt, sondern direkt mit den Geschäftszielen des Unternehmens verknüpft.
Wenn die Geschäftsführung hier nicht klar Position bezieht, entstehen viele isolierte BI- oder KI-Initiativen ohne gemeinsamen Rahmen. Das führt zu konkurrierenden Kennzahlen, parallelen Dateninseln und einer IT, die operativ hinterherläuft, statt strategisch zu steuern.
Typische Missverständnisse: Datenstrategie ist mehr als Tools, Dashboards und KI
In vielen Unternehmen wird „Datenstrategie“ mit der Auswahl eines BI-Tools oder dem Aufbau eines Data Lakes verwechselt. Das Ergebnis sind zusätzliche Systeme, aber keine geklärten Verantwortlichkeiten, kein einheitliches KPI-Verständnis und keine klare Roadmap.
Ein anderes Missverständnis ist der Start mit „KI-Projekten“, bevor Datenbasis, Datenqualität und Governance geregelt sind. Dann entstehen Pilot-Projekte, die beeindruckend aussehen, aber nicht in den Alltag überführt werden können, weil die zugrundeliegenden Datenströme nicht stabil sind.
Warum ist eine Datenstrategie wichtig – gerade für Unternehmen im Mittelstand?
Vom Bauchgefühl zur belastbaren Entscheidungsbasis
Mittelständische Unternehmen sind oft stark von Erfahrung und Intuition der Führungskräfte geprägt, was die Implementierung einer Datenstrategie erschwert. Das ist ein Vorteil, solange Märkte stabil sind und Daten nur zur Bestätigung dienen. Mit wachsender Komplexität – mehr Standorte, Produktvarianten, Regulatorik – reicht Bauchgefühl allein jedoch nicht mehr; eine Datenstrategie bietet eine Roadmap zur besseren Entscheidungsfindung.
Eine Datenstrategie hilft Dir, Entscheidungen systematisch auf belastbare Zahlen zu stützen. Sie sorgt dafür, dass Umsatz, Marge, OEE, OTIF oder Lagerreichweiten nicht erst nach Tagen in Excel zusammengestellt, sondern täglich konsistent verfügbar sind – und zwar für alle Beteiligten in derselben Logik.
Wettbewerbsdruck, Fachkräftemangel und Regulatorik: Warum „Weiter so“ nicht reicht
Laut Bitkom nutzen nur 6 % der befragten Unternehmen in Deutschland das Potenzial ihrer Daten vollständig. Gleichzeitig steigt der Druck durch Fachkräftemangel, volatile Lieferketten und neue Vorgaben wie den EU Data Act, der seit September 2025 anwendbar ist und Datennutzung und -zugang stärker reguliert.
Wer weiter mit verstreuten Excel-Reports arbeitet, zahlt zeitlich und wirtschaftlich drauf: Reports dauern zu lange, Analysen sind schwer reproduzierbar und Wissensinseln hängen an einzelnen Köpfen. Eine Datenstrategie macht klar, welche Fähigkeiten wirklich gebraucht werden und wo Automatisierung sinnvoll entlastet.
Business Case: Wo Unternehmen ohne Datenstrategie Geld und Chancen verlieren
Die Kosten fehlender Datenstrategie sind selten in einer einzigen Zahl sichtbar, sondern verteilen sich über viele Prozesse und beeinträchtigen die organisatorische Effizienz. Typische Effekte sind lange Reporting-Zyklen, Mehrarbeit durch manuelle Auswertungen, Entscheidungsverzögerungen und Fehlerkosten durch falsche oder verspätete Zahlen.
In der Praxis sehen wir das zum Beispiel im Monatsabschluss, der zehn Tage dauert, weil Daten aus ERP, Produktion und Excel manuell zusammengeführt werden, was die Umsetzung der Datenstrategie erschwert. Oder in der Qualitätssicherung, die Stunden braucht, um Ursachen für Ausschuss zu identifizieren, weil MES-, CAQ- und Auftragsdaten nicht sauber verknüpft sind und die richtigen Daten fehlen.
| Bereich | Typischer Effekt ohne Datenstrategie | Messbare Folge |
|---|---|---|
| Reporting & Controlling | Monatsberichte werden manuell aus mehreren Systemen in Excel zusammengebaut. | Längere Durchlaufzeiten, mehr Korrekturschleifen, höhere Personalkosten für Standardreports sind Herausforderungen, die die gesamten Unternehmen betreffen. |
| Produktion & Qualität | Ausschussgründe sind nicht sauber codiert, Maschinendaten nicht integriert. | Langsame Ursachenanalyse, wiederkehrende Fehler, höhere Ausschuss- und Nacharbeitsquoten. |
| Supply Chain & Einkauf | Lieferperformance wird nur grob gemessen, Ursachen bleiben unklar, was die Implementierung einer effektiven Datenstrategie notwendig macht. | Schlechtere OTIF-Werte, Sicherheitsbestände steigen, Kapitalbindung nimmt zu. |
| Vertrieb & Service | Kundendaten liegen verteilt in CRM, ERP und E-Mail-Tools, was die Entwicklung einer umfassenden Datenstrategie beinhaltet. | Kein Gesamtbild pro Kunde, weniger zielgerichtete Angebote, verpasste Cross- und Upselling-Chancen. |
Zusammenspiel von Unternehmenszielen, Prozessen und Daten
Eine wirksame Datenstrategie beginnt immer mit den Unternehmenszielen, nicht mit den Systemen. Wenn klar ist, welche Kennzahlen für Deine Strategie entscheidend sind, lassen sich die dahinterliegenden Prozesse und Datenquellen gezielt identifizieren und priorisieren.
Für viele Mittelständler heißt das: zentrale Geschäftsprozesse wie Order-to-Cash, Procure-to-Pay oder Shopfloor-Qualität werden als Datenflüsse verstanden. Erst dann wird festgelegt, welche Datenobjekte (z. B. Auftrag, Material, Maschine, Kunde) wie erfasst, verknüpft und überwacht werden müssen.
Kostenloses Erstgespräch vereinbaren
Typische Probleme ohne Datenstrategie im Unternehmen und im Datenmanagement
Manuelle Reports und Excel-Wildwuchs
In vielen Unternehmen beginnt der Monat mit Exporten aus ERP, CRM und MES, die in Excel-Ordnern landen und die Umsetzung der Datenstrategie behindern. Einzelne Mitarbeitende verknüpfen diese Dateien, bauen Pivot-Tabellen und senden PDF-Reports per Mail an Führungskräfte im Rahmen der Umsetzung der Datenstrategie.
Dieses Vorgehen funktioniert, solange die Komplexität niedrig ist und die Schlüsselpersonen verfügbar sind. Spätestens bei Urlaubsvertretung, Wachstum oder zusätzlichen Standorten wird es jedoch zum Risiko, weil Wissen in persönlichen Dateien steckt und Prozesse weder dokumentiert noch skalierbar sind.
Datensilos, Inkonsistenzen und unklare Kennzahlen
Ohne Datenstrategie wachsen Systeme oft historisch: ein ERP hier, ein Produktionssystem dort, dazu Speziallösungen für Instandhaltung oder E-Commerce, was die Effizienz des Datenmanagements beeinträchtigt. Jedes System liefert eigene Berichte, mit eigenen Kennzahlen und Definitionen.
Das führt zu Situationen, in denen Vertrieb und Controlling unterschiedliche Umsatzzahlen berichten oder in der Produktion „Ausschuss“ je nach System anders gezählt wird. Statt über Maßnahmen zu sprechen, diskutiert Ihr über die Richtigkeit der Zahlen – und verliert wertvolle Zeit, die besser genutzt werden könnte, um innovative Ansätze wie machine learning auszuschöpfen.
Fehlende Datenqualität und Misstrauen in Zahlen
Wenn Stammdaten unvollständig, Dubletten verbreitet und Zeitstempel inkonsistent sind, sinkt das Vertrauen in Reports automatisch und die Fähigkeit, datengetriebene Entscheidungen zu implementieren. Führungskräfte beginnen, Zahlen „gegenzurechnen“ oder verlassen sich wieder stärker auf Bauchgefühl.
Datenqualität ist dabei kein einmaliges Bereinigungsprojekt, sondern ein laufender Prozess aus Regeln, Prüfungen und Verantwortlichkeiten. Ohne Strategie bleiben Qualitätsthemen reaktiv: Man korrigiert dort, wo es akut wehtut, statt Ursachen systematisch anzugehen.
Langsame, teure und riskante Entscheidungen
Wer für jede wichtige Entscheidung erst Zahlen zusammentragen, prüfen und nachjustieren muss, reagiert langsamer auf Marktveränderungen. Das betrifft Produktionsplanung, Preisentscheidungen, Investitionen oder Personalplanung gleichermaßen.
Gleichzeitig steigt das Risiko von Fehlentscheidungen, wenn Kennzahlen nicht einheitlich definiert oder Datenquellen nicht synchron sind. Gerade in volatilen Märkten wird das zu einem echten Wettbewerbsnachteil.
Warum KI- und BI-Projekte ohne Strategie scheitern oder steckenbleiben
Viele Unternehmen starten mit einem BI-Tool oder einem KI-Proof-of-Concept, ohne zuvor Grundlagen wie Datenqualität, Governance und Architektur zu klären. Anfangs entstehen beeindruckende Dashboards oder Modelle – doch im Alltag werden sie kaum genutzt; eine effektive Datenstrategie implementiert Maßnahmen, um ihre Nutzung zu fördern.
Die Gründe sind oft dieselben: fehlende Integration in Prozesse, unklare Verantwortung für Kennzahlen, instabile Datenlieferungen oder fehlende Nachvollziehbarkeit der zugrunde liegenden Logik. Ohne Strategie bleibt es bei Insellösungen und „Pilotitis“, weshalb es für Unternehmen wichtig ist, eine klare Datenstrategie zu entwickeln.
Vorteile einer klaren Datenstrategie für den Mittelstand
Bessere Entscheidungen: Transparenz über Geschäfts- und Prozessleistung
Mit einer klaren Datenstrategie werden Management- und Bereichskennzahlen systematisch definiert, in Datenmodellen abgebildet und automatisiert bereitgestellt. Das reduziert Diskussionen über die Herkunft der Zahlen und ermöglicht schnellere, fundierte Entscheidungen.
In der Praxis siehst Du das daran, dass wiederkehrende Fragen – etwa zur Profitabilität einer Produktlinie oder zur Liefertermintreue je Werk – jederzeit beantwortbar sind, ohne neue Excel-Projekte anzustoßen.
Effizientere Prozesse und weniger manuelle Arbeit
Eine durchdachte Datenstrategie ersetzt vielerorts manuelle Exporte, Kopierarbeiten und Nachkalkulationen durch automatisierte Pipelines und standardisierte, hochwertige Reports. Das entlastet Fachbereiche und IT gleichermaßen.
Statt Kapazitäten auf das Zusammentragen von Daten zu verwenden, können Teams mehr Zeit in Interpretation, Ursachenanalyse und Maßnahmenplanung investieren, um die Verwaltung und Nutzung von Daten zu optimieren. Das ist gerade bei knappen Fachkräften ein wesentlicher Hebel.
Neue Geschäftsmodelle, Services und Umsatzpotenziale
Sobald Daten sauber integriert und als „Datenprodukte“ strukturiert sind, können daraus neue Services entstehen, die das volle Potenzial einer Datenstrategie ausschöpfen. Beispiele sind vorausschauende Wartung, nutzungsabhängige Abrechnungsmodelle oder datenbasierte Beratungsleistungen für Kunden.
Auch im klassischen Produktgeschäft ermöglichen saubere Daten zum Beispiel bessere Ersatzteilprognosen, gezieltere Serviceangebote oder produktübergreifende Bundles, weil Du Nutzung, Ausfallrisiken und Kundenverhalten besser verstehst.
Mehr Compliance, Nachvollziehbarkeit und Risikoreduktion
Seit der EU Data Act anwendbar ist und weitere Regulierungen folgen, steigt der Druck, Datenzugriffe, Herkunft und Verarbeitung sauber zu dokumentieren. Eine Datenstrategie schafft hier einen Rahmen, wie Governance, Rollen und Prozesse verankert werden.
Für Dich bedeutet das: Berichte und Kennzahlen lassen sich besser auditieren, Datenherkünfte klar nachvollziehen und Berechtigungen gezielt steuern, um die richtigen Daten zur richtigen Zeit bereitzustellen. Das reduziert Risiken bei Audits, Kundennachfragen oder regulatorischen Prüfungen.
Solide Basis für Business Intelligence und KI
BI- und KI-Projekte brauchen konsistente, gut dokumentierte und reproduzierbare Daten. Eine Datenstrategie definiert, wie diese Basis geschaffen wird – von der Integration über Datenmodelle bis zur Datenqualität und Verantwortlichkeit, um unbefugtem Zugriff vorzubeugen.
So entstehen KI-Anwendungen nicht mehr als isolierte Experimente, sondern als logische Erweiterung bestehender Datenprodukte, etwa zur Prognose von Nachfrage, Anomalien in der Produktion oder Zahlungswahrscheinlichkeiten.
Praxisbeispiele: Wo Unternehmen mit Datenstrategie konkret profitieren
Ein produzierender Mittelständler mit drei Werken reduziert seine Reporting-Durchlaufzeit von acht auf zwei Tage, indem ERP-, MES- und CAQ-Daten in einem einheitlichen Modell zusammengeführt und zentrale KPIs definiert werden. Diskussionen über Zahlen gehen deutlich zurück, Maßnahmen können zeitnäher eingeleitet werden.
Ein anderes Unternehmen strukturiert seine Instandhaltungsdaten neu, verknüpft Sensorwerte mit hochwertig aufbereiteten Asset-Stammdaten und Wartungshistorie und kann so ungeplante Stillstände senken, indem es die Daten effektiv nutzt. Die Datenstrategie hat dabei festgelegt, welche Datenobjekte kritisch sind, wer sie verantwortet und wie sie qualitätsgesichert in die Plattform gelangen.
Bausteine erfolgreicher Datenstrategien: Geschäftsziele, Datenqualität und Datenarchitektur
Auch wenn jedes Unternehmen anders ist, tauchen bestimmte Bausteine in fast jeder erfolgreichen Datenstrategie auf, die für das gesamte Unternehmen von Bedeutung sind. Sie reichen von der Bestandsaufnahme über Datenqualität und Governance bis hin zur Architektur- und Make-or-buy-Entscheidung.
Wichtig ist, diese Bausteine nicht isoliert zu betrachten, sondern als zusammenhängendes System: Nur wenn Ziele, Daten, Technik und Organisation aufeinander abgestimmt sind, entsteht eine nachhaltige Datenbasis.
1. Bestandsaufnahme und Datenreife
Am Anfang steht die ehrliche Analyse: Welche Systeme habt Ihr, welche Daten werden dort geführt und wie werden sie heute genutzt, um die Datenstrategie der Bundesregierung zu unterstützen? Dazu gehören ERP, MES, CAQ, CRM, E-Commerce, aber auch Excel-Sammlungen und Access-Datenbanken, die alle Teil einer integrierten Datenstrategie innerhalb des Unternehmens sein können.
Parallel lohnt sich ein Blick auf die Datenreife: Wie stark hängen Eure Reports von manuellen Schritten ab, wie standardisiert sind Kennzahlen, wie stark sind Fachbereiche bereits im Umgang mit Daten befähigt?
2. Datenqualität und Datenintegration
Ohne verlässliche Integration und Basisqualität wird jede BI- oder KI-Lösung schnell fragil. Ein Datenstrategie-Baustein definiert deshalb, welche Datenobjekte besonders kritisch sind, welche Qualitätsregeln gelten und wie Daten aus Quellsystemen automatisiert zusammengeführt werden.
Gerade im Mittelstand hilft es, mit wenigen Kernobjekten zu starten, etwa Auftrag, Kunde, Material und Maschine, und hier zunächst eindeutige IDs, Pflichtfelder und Plausibilitätsregeln zu verankern.
3. Einheitliche KPIs, Data Governance und Verantwortlichkeiten
Ein KPI wie „Liefertermintreue“ muss im Einkauf dasselbe bedeuten wie in der Logistik und im Vertrieb, um eine gut durchdachte Datenstrategie zu unterstützen. Die Datenstrategie definiert deshalb Kennzahlenkatalog, Berechnungslogiken und Verantwortliche, die diese Definitionen pflegen, und beinhaltet auch die Verwaltung und Nutzung von Daten.
Daraus entsteht ein leichtgewichtiges Governance-Modell: Wer entscheidet über neue KPIs, wer genehmigt Änderungen an Datenmodellen, wer verantwortet Datenqualität in den Fachbereichen, und warum ist eine Datenstrategie dabei wichtig?
4. Technische Datenarchitektur und Plattformstrategie
Auf technischer Ebene beschreibt die Datenstrategie, wie Datenplattform, Data Warehouse, Data Lake oder Lakehouse zusammenspielen und wie BI- oder KI-Frontends angebunden sind, um verschiedene Aspekte des Datenmanagements zu berücksichtigen. Ziel ist eine Architektur, die sowohl stabil als auch erweiterbar ist, um die technologischen Anforderungen der Zukunft zu erfüllen.
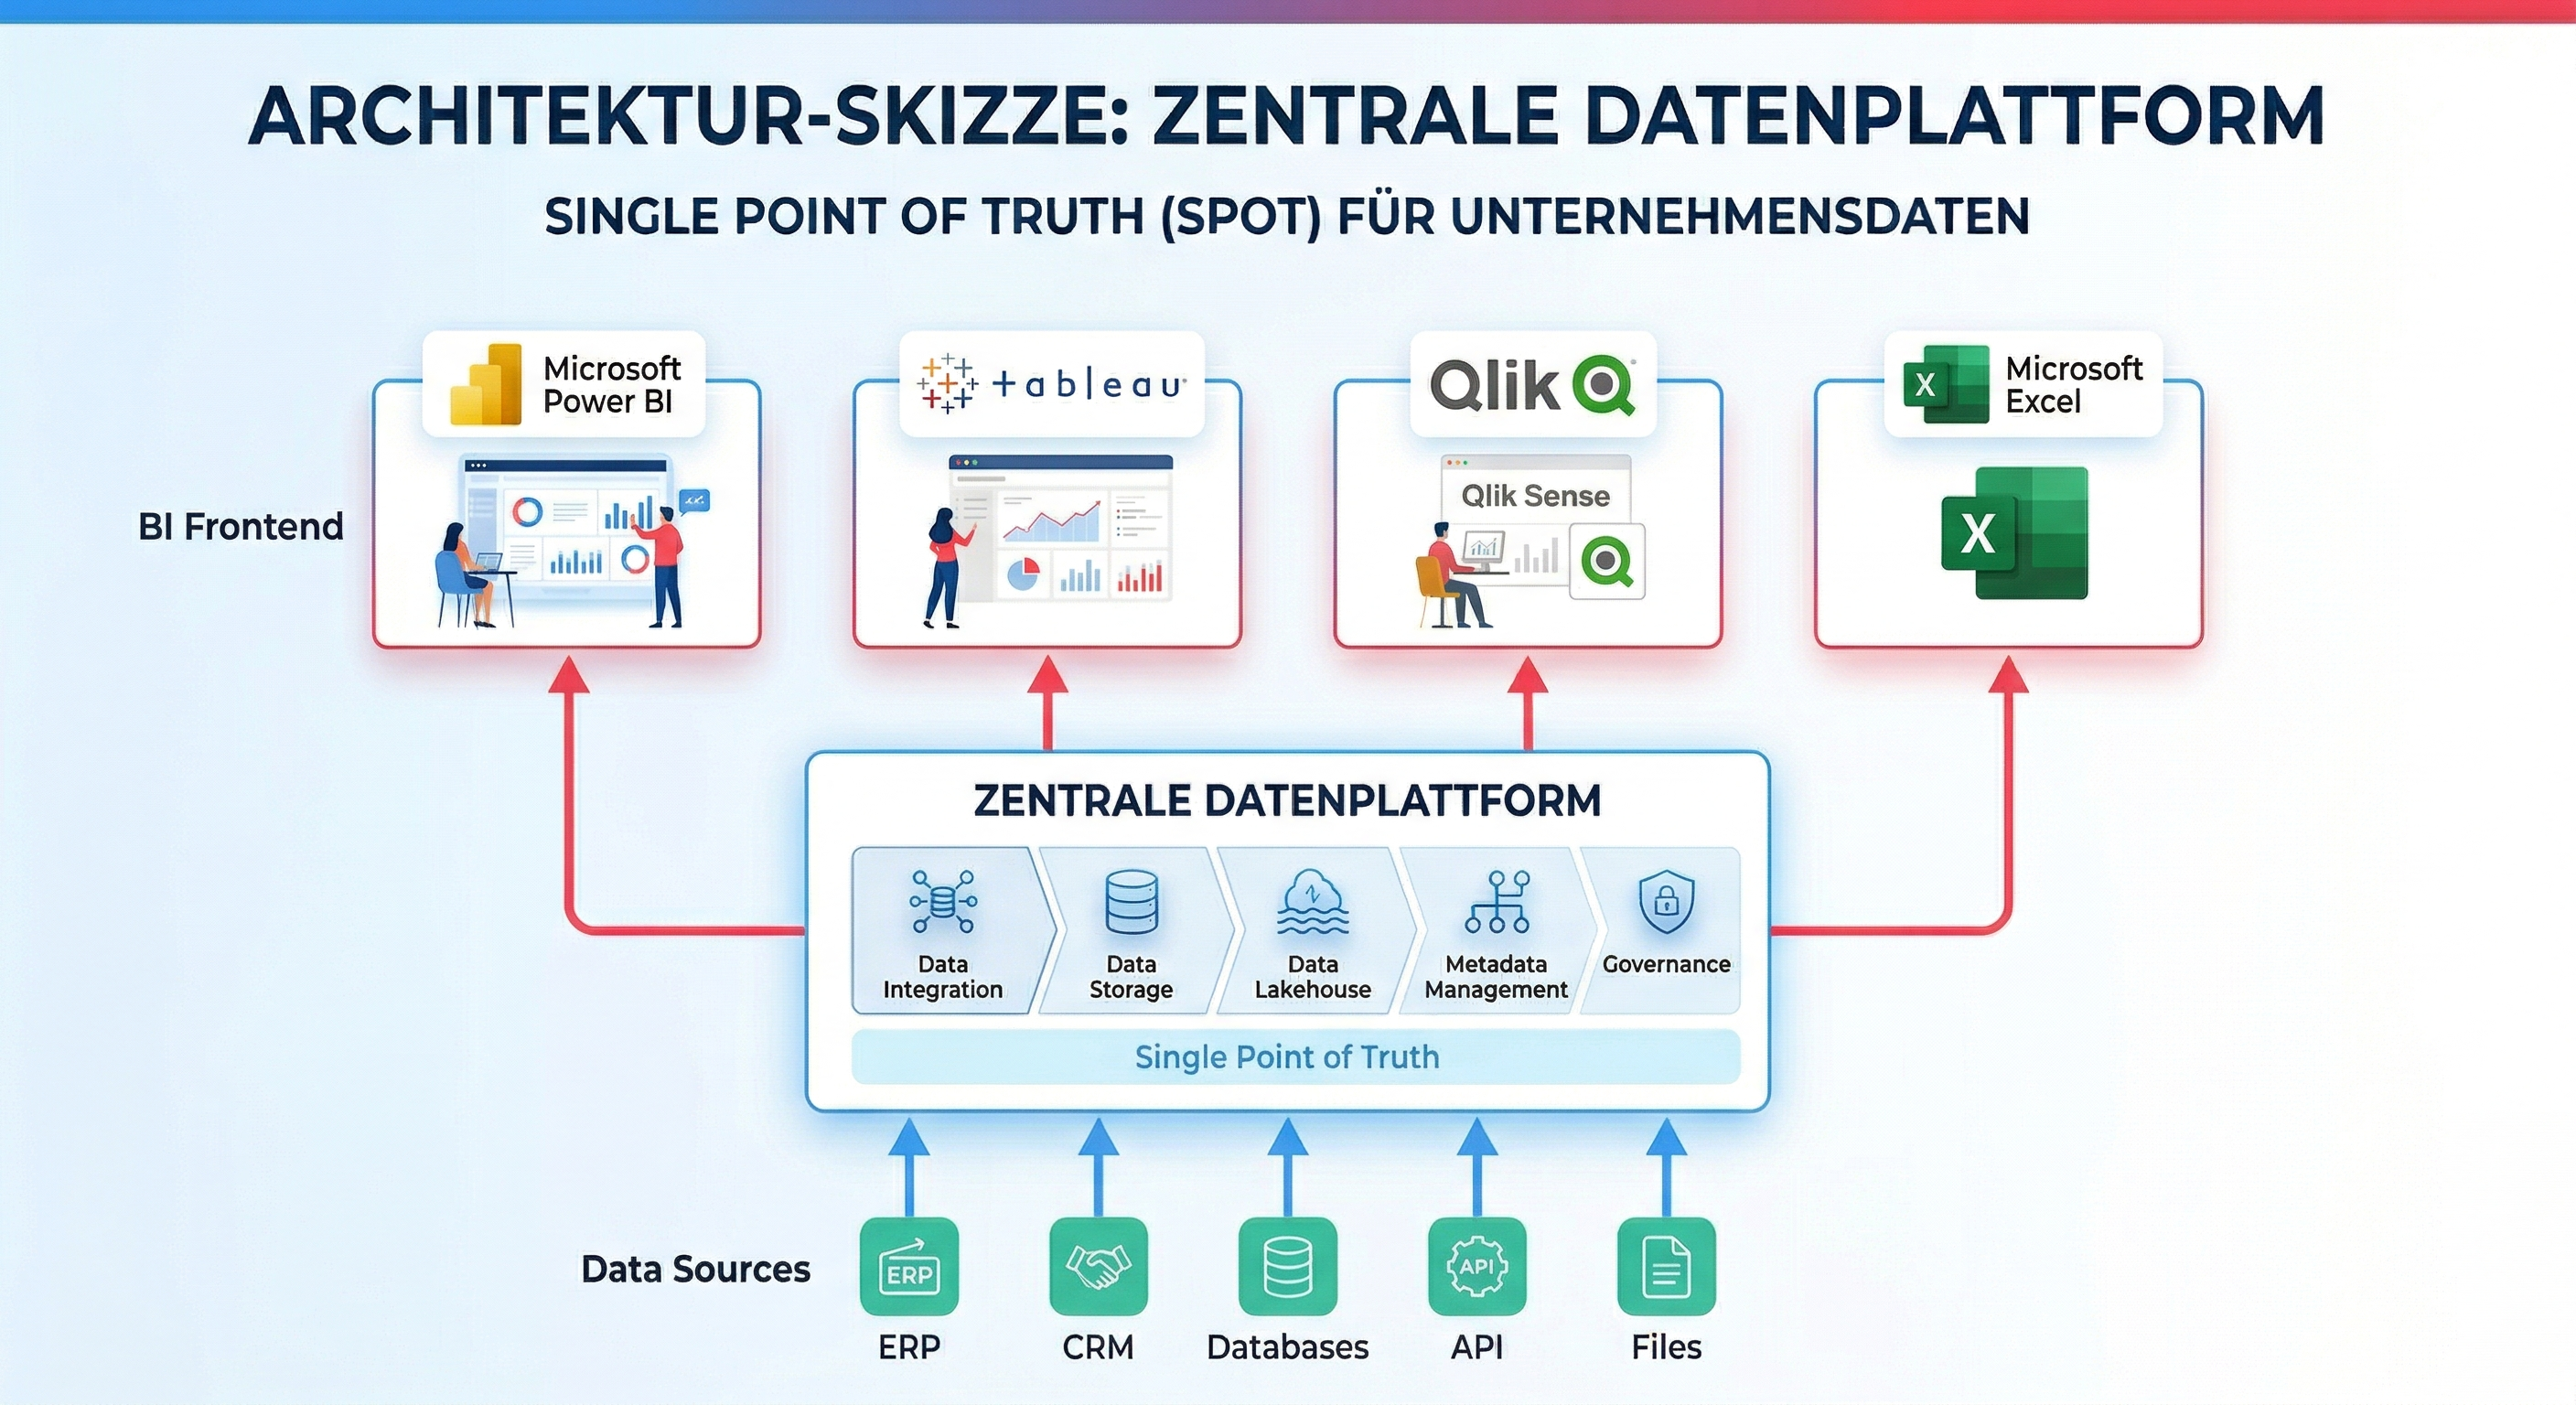
Für den Mittelstand bedeutet das meist: Eine zentrale Datenplattform als „Single Point of Truth“, die unterschiedliche Quellsysteme integriert und von verschiedenen Frontends aus genutzt werden kann, ohne dass jede Abteilung eigene Datenkopien pflegt.
5. Make-or-buy-Entscheidungen im Daten- und BI-Bereich
Nicht jede Fähigkeit muss intern aufgebaut werden. Die Datenstrategie legt fest, welche Teile der Datenlandschaft Ihr selbst verantworten wollt und wo Plattformen oder Partner sinnvoll sind – etwa bei Data-Warehouse-Automation, ETL/ELT oder Monitoring.
Dabei geht es nicht nur um kurzfristige Projektkosten, sondern um langfristige Betriebskosten, Abhängigkeiten und die Frage, wie stark Ihr vom Fachkräftemangel im Data-Engineering betroffen seid.
6. Datenkultur, Organisation und Zusammenarbeit
Eine Strategie auf Papier hilft wenig, wenn Fachbereiche sie nicht mittragen. Ein eigener Baustein widmet sich deshalb Datenkultur, Schulungen, Verantwortlichkeiten und regelmäßigen Abstimmungen zwischen Management, IT und Fachbereichen.
Ziel ist eine Kultur, in der Fachbereiche aktiv Daten nutzen, Begriffe verstehen und bereit sind, Verantwortung für „ihre“ Daten und Kennzahlen zu übernehmen, was für die gesamte Unternehmen entscheidend ist.
7. Roadmap und schrittweise Umsetzung mit klaren Use Cases
Zum Abschluss werden die Bausteine in eine Roadmap übersetzt: Welche Use Cases setzt Ihr in den nächsten 90 Tagen um, welche in den nächsten 12 oder 24 Monaten, um die Verwaltung und Nutzung von Daten zu optimieren? Dabei werden Aufwand, Nutzen und Abhängigkeiten transparent gemacht.
So entsteht ein realistischer Fahrplan, der schnelle Erfolge ermöglicht, ohne das System langfristig zu verbauen. Wichtig ist, dass jede Roadmap klar messbare Ziele und KPIs enthält.
Kostenloses Erstgespräch vereinbaren
Implementierung einer Datenstrategie: So starten Unternehmen strukturiert
1. Unternehmensziele und Geschäftsprobleme klar benennen
Bevor Du über Datenmodelle oder Tools sprichst, sollten die wichtigsten geschäftlichen Ziele und Probleme klar sein. Das können zum Beispiel zu lange Durchlaufzeiten in der Produktion, unklare Deckungsbeiträge je Kunde oder steigende Lagerbestände sein.
Für jeden Punkt lässt sich anschließend die Frage stellen: Welche Kennzahlen brauchen wir, um das zu steuern, und welche Daten stecken dahinter? So stellst Du sicher, dass Deine Datenstrategie nicht abstrakt bleibt, sondern direkt am Geschäft ansetzt und die gesellschaftlichen Fortschritte fördert.
2. Ist-Analyse: Datenlandschaft, Systeme und Datenreife erfassen
Im nächsten Schritt erstellst Du eine Datenlandkarte: Welche Systeme führen welche Kernobjekte, wie werden sie aktuell verbunden und wofür werden sie genutzt? Dazu gehört auch die Frage, welche Reports heute kritisch sind und wie sie erzeugt werden.
Ergänzend bewertest Du den Reifegrad: Wie hoch ist der Anteil manueller Arbeit in Reporting-Prozessen, wie konsistent sind Kennzahlen, wie groß ist das Vertrauen in vorhandene Reports? Diese Analyse muss nicht akademisch sein, aber sollte technologisch fundiert und ehrlich sein.
3. Datenquellen und Kernprozesse priorisieren
Nicht jede Datenquelle ist gleich kritisch. Ein praktischer Weg ist, die wichtigsten Geschäftsprozesse zu identifizieren – etwa Order-to-Cash oder Shopfloor-Qualität – und die dafür relevanten Systeme zu priorisieren.
So vermeidest Du, Dich in Randthemen zu verlieren, und richtest Deine ersten Strategie-Schritte konsequent auf die Bereiche aus, in denen Daten einen klaren Hebel haben.
4. Use Cases definieren: Wo bringt Datenvernetzung den größten Hebel?
Aus den priorisierten Prozessen leitest Du konkrete Use Cases ab. Beispiele sind ein zentrales Management-Dashboard, eine Ausschussanalyse je Linie oder ein Liefertreue-Cockpit inklusive Ursachenanalyse.
Gute Use Cases zeichnen sich dadurch aus, dass sie klar umrissen sind, auf vorhandenen Daten aufsetzen und einen spürbaren Nutzen innerhalb weniger Monate bringen können.
5. Zielbild für Datenarchitektur, Rollen und Governance entwickeln
Aus den Use Cases ergibt sich ein erstes Zielbild: Welche Architektur-Komponenten brauchst Du mindestens, welche Rollen müssen besetzt werden und welche Governance-Regeln gelten, um eine erfolgreiche Datenstrategie zu entwickeln? Es geht nicht darum, alles final festzulegen, sondern ein pragmatisches erstes Bild zu zeichnen, das die Grundlage für eine erfolgreiche Datenstrategie bildet.
Für viele Mittelständler bedeutet das: eine zentrale Datenplattform mit standardisierten Konnektoren, definierte Rollen wie Data Owner und Data Steward sowie einfache Entscheidungswege für neue KPIs oder Modellanpassungen.
6. Roadmap und Quick Wins planen – statt Großprojekt „Big Bang“
Statt ein großes, mehrjähriges Projekt zu planen, ist es sinnvoll, mit einer 90-Tage-Perspektive zu starten. Welche drei Schritte bringen den größten Fortschritt in Richtung Zielbild und liefern bereits messbare Verbesserungen?
Typische Quick Wins sind die Automatisierung eines kritischen Reports, die Bereinigung eines zentralen Stammdatensatzes oder die Einführung eines gemeinsamen KPI-Glossars für ein Kernthema wie Lieferperformance.
7. Erfolgskriterien und KPIs für die Datenstrategie festlegen
Damit Deine Datenstrategie steuerbar bleibt, brauchst Du eigene Kennzahlen. Dazu gehören zum Beispiel Time-to-Report, Anteil automatisierter Datenpipelines, Anzahl korrigierter Reports pro Monat oder der Standardisierungsgrad zentraler KPIs.
Diese Kennzahlen sollten von Anfang an mit definiert werden, damit Fortschritte sichtbar werden und Prioritätenobjektiv diskutiert werden können.
| Kriterium: Eine effektive Datenstrategie ist entscheidend, um das volle Potenzial der Daten im gesamten Unternehmen auszuschöpfen. | Was wird gemessen? | Typisches Zielbild einer Datenstrategie ist es, dass Daten für alle im Unternehmen zugänglich sind und effektiv genutzt werden können. |
|---|---|---|
| Time-to-Report | Zeit von Periodenende bis verfügbarer Standardreport. | Von mehreren Tagen auf Stunden für zentrale Management-Reports. |
| Automatisierungsgrad | Anteil der Datenflüsse ohne manuelle Eingriffe. | Der schrittweise Ausbau in Richtung eines hohen zweistelligen Prozentbereichs ist ein wichtiger Schritt, um die Datenstrategie zu entwickeln. |
| Datenqualitäts-SLAs | Vollständigkeit, Aktualität, Dublettenrate kritischer Objekte. | Definierte Mindeststandards für Auftrag, Kunde, Material, Maschine. |
| KPI-Standardisierung ist ein wichtiger Schritt, um eine hochwertige Datenstrategie zu implementieren und Best Practices innerhalb des Unternehmens zu etablieren. | Anteil zentral definierter KPIs vs. individueller Definitionen. | Einheitliche Definitionen für alle geschäftskritischen KPIs sind entscheidend, um eine effektive Datenstrategie zu entwickeln, die Unternehmen schaffen kann. |
Bestandsaufnahme und Datenreife: Wo steht Dein Unternehmen mit seiner Datenstrategie heute?
Reifegradmodelle: Von Excel-getrieben bis datengetrieben
Reifegradmodelle helfen Dir, den Status quo greifbar zu machen. Auf der linken Seite stehen Unternehmen, deren Berichte hauptsächlich aus Excel bestehen, ohne transparente Datenflüsse oder zentrale Definitionen.
Auf der rechten Seite stehen Organisationen, die Daten als Produkte verstehen, Datenqualität kontinuierlich überwachen und BI- oder KI-Use-Cases effektiv und reproduzierbar betreiben. Die meisten Mittelständler befinden sich irgendwo dazwischen.
Typische Reifegradstufen im Mittelstand
Um eine sinnvolle Standortbestimmung zu machen, reicht oft ein einfaches Modell mit vier Stufen: ad hoc, standardisiert, integriert und datengetrieben, was eine grundlegende Datenstrategie beinhaltet. Entscheidend ist, wo Du heute stehst und welche Stufe realistisch als nächstes erreicht werden kann.
So vermeidest Du Überforderungen und unrealistische Projektziele und richtest Deine Roadmap konsequent auf den nächsten sinnvollen Schritt aus, um die geschäftlichen Ziele voranzutreiben, denn warum ist eine Datenstrategie entscheidend für den Erfolg?
| Stufe | Kennzeichen einer gut durchdachten Datenstrategie sind klare Definitionen und transparente Datenflüsse. | Nächster sinnvoller Schritt |
|---|---|---|
| Ad hoc | Viele Excel-Reports, kaum Dokumentation, individuelle Logiken. | Kritische Reports identifizieren und erste Automatisierung starten. |
| Standardisiert | Wiederkehrende Reports, erste KPI-Definitionen, aber Insellösungen. | Zentrale Datenplattform und gemeinsames KPI-Glossar aufbauen. |
| Integriert in eine umfassende Datenstrategie, die Machine Learning nutzt, um Daten als strategisches Gut zu behandeln. | Daten aus mehreren Systemen im DWH, zentrale Kennzahlen, erste Governance. | Datenqualität operativ verankern und Datenprodukte definieren. |
| Datengetrieben ist die Grundlage, auf der Unternehmen dabei ihre Strategien entwickeln. | Datenprodukte, Self-Service-Analytics, produktive KI-Use-Cases. | Skalierung, neue Geschäftsmodelle und die Implementierung einer Datenstrategie sind entscheidend für den Erfolg von Unternehmen dabei. |
Fragen für den Self-Check: Daten, Prozesse, Organisation, Technik
Für einen Self-Check kannst Du Dir unter anderem folgende Fragen stellen: Wie werden heute Management-Reports erzeugt und wie viel davon ist automatisiert? Welche drei Datenquellen sind für unser Kerngeschäft kritisch und wie gut sind sie integriert?
Ergänzend lohnt sich der Blick auf Organisation und Kultur: Wer entscheidet heute über neue Kennzahlen, wer korrigiert Datenfehler und wie wird Wissen zu Datenflüssen und Logiken dokumentiert, um die Implementierung einer Datenstrategie zu unterstützen?
Wie Du Schwachstellen sichtbar machst (statt nur zu vermuten)
Schwachstellen werden klarer, wenn Du ein oder zwei konkrete Reports „auseinander nimmst“ und alle Zwischenschritte dokumentierst, um die Umsetzung der Datenstrategie zu verbessern. So siehst Du, wo manuelle Eingriffe stattfinden, wo Daten mehrfach transformiert werden und wo Definitionen fehlen.
Aus diesen Analysen lassen sich schnell Muster ableiten, die für andere Bereiche ähnlich gelten. Das schafft eine belastbare Grundlage für Priorisierungen und Investitionsentscheidungen.
Kostenloses Erstgespräch vereinbaren
Datenqualität, Datenintegration und Datenverwaltung als Fundament der Datenstrategie
Warum Datenqualität über Erfolg oder Misserfolg entscheidet
Jede Entscheidung, jedes Dashboard und jedes KI-Modell ist nur so gut wie die zugrunde liegenden Daten. Wenn Auftragsdaten unvollständig sind, Maschinensignale Lücken aufweisen oder Kundenstammdaten veraltet sind, bleiben Analysen unscharf oder schlicht falsch.
Datenqualität umfasst dabei mehr als nur „korrekte Werte“; sie sichert auch die Einhaltung von Standards. Relevante Dimensionen sind Vollständigkeit, Aktualität, Eindeutigkeit (keine Dubletten) und Konsistenz über Systeme hinweg, um die Datenverwaltung zu gewährleisten.
Typische Fehlerquellen bei Datenqualität im Mittelstand
Häufige Ursachen sind uneinheitliche Stammdatenpflege, fehlende Pflichtfelder, unterschiedliche Schreibweisen oder fehlende Plausibilitätsprüfungen in Quellsystemen. Auch manuelle Exporte und Importe zwischen Systemen sind beliebte Fehlerquellen.
Eine gute Datenstrategie nimmt diese Ursachen in den Blick und definiert, wo Regeln technisch umgesetzt werden können und wo Prozesse oder Schulungen im Fachbereich nötig sind.
Datenintegration: ERP, CRM, Produktion, Finance & Co. zusammenführen
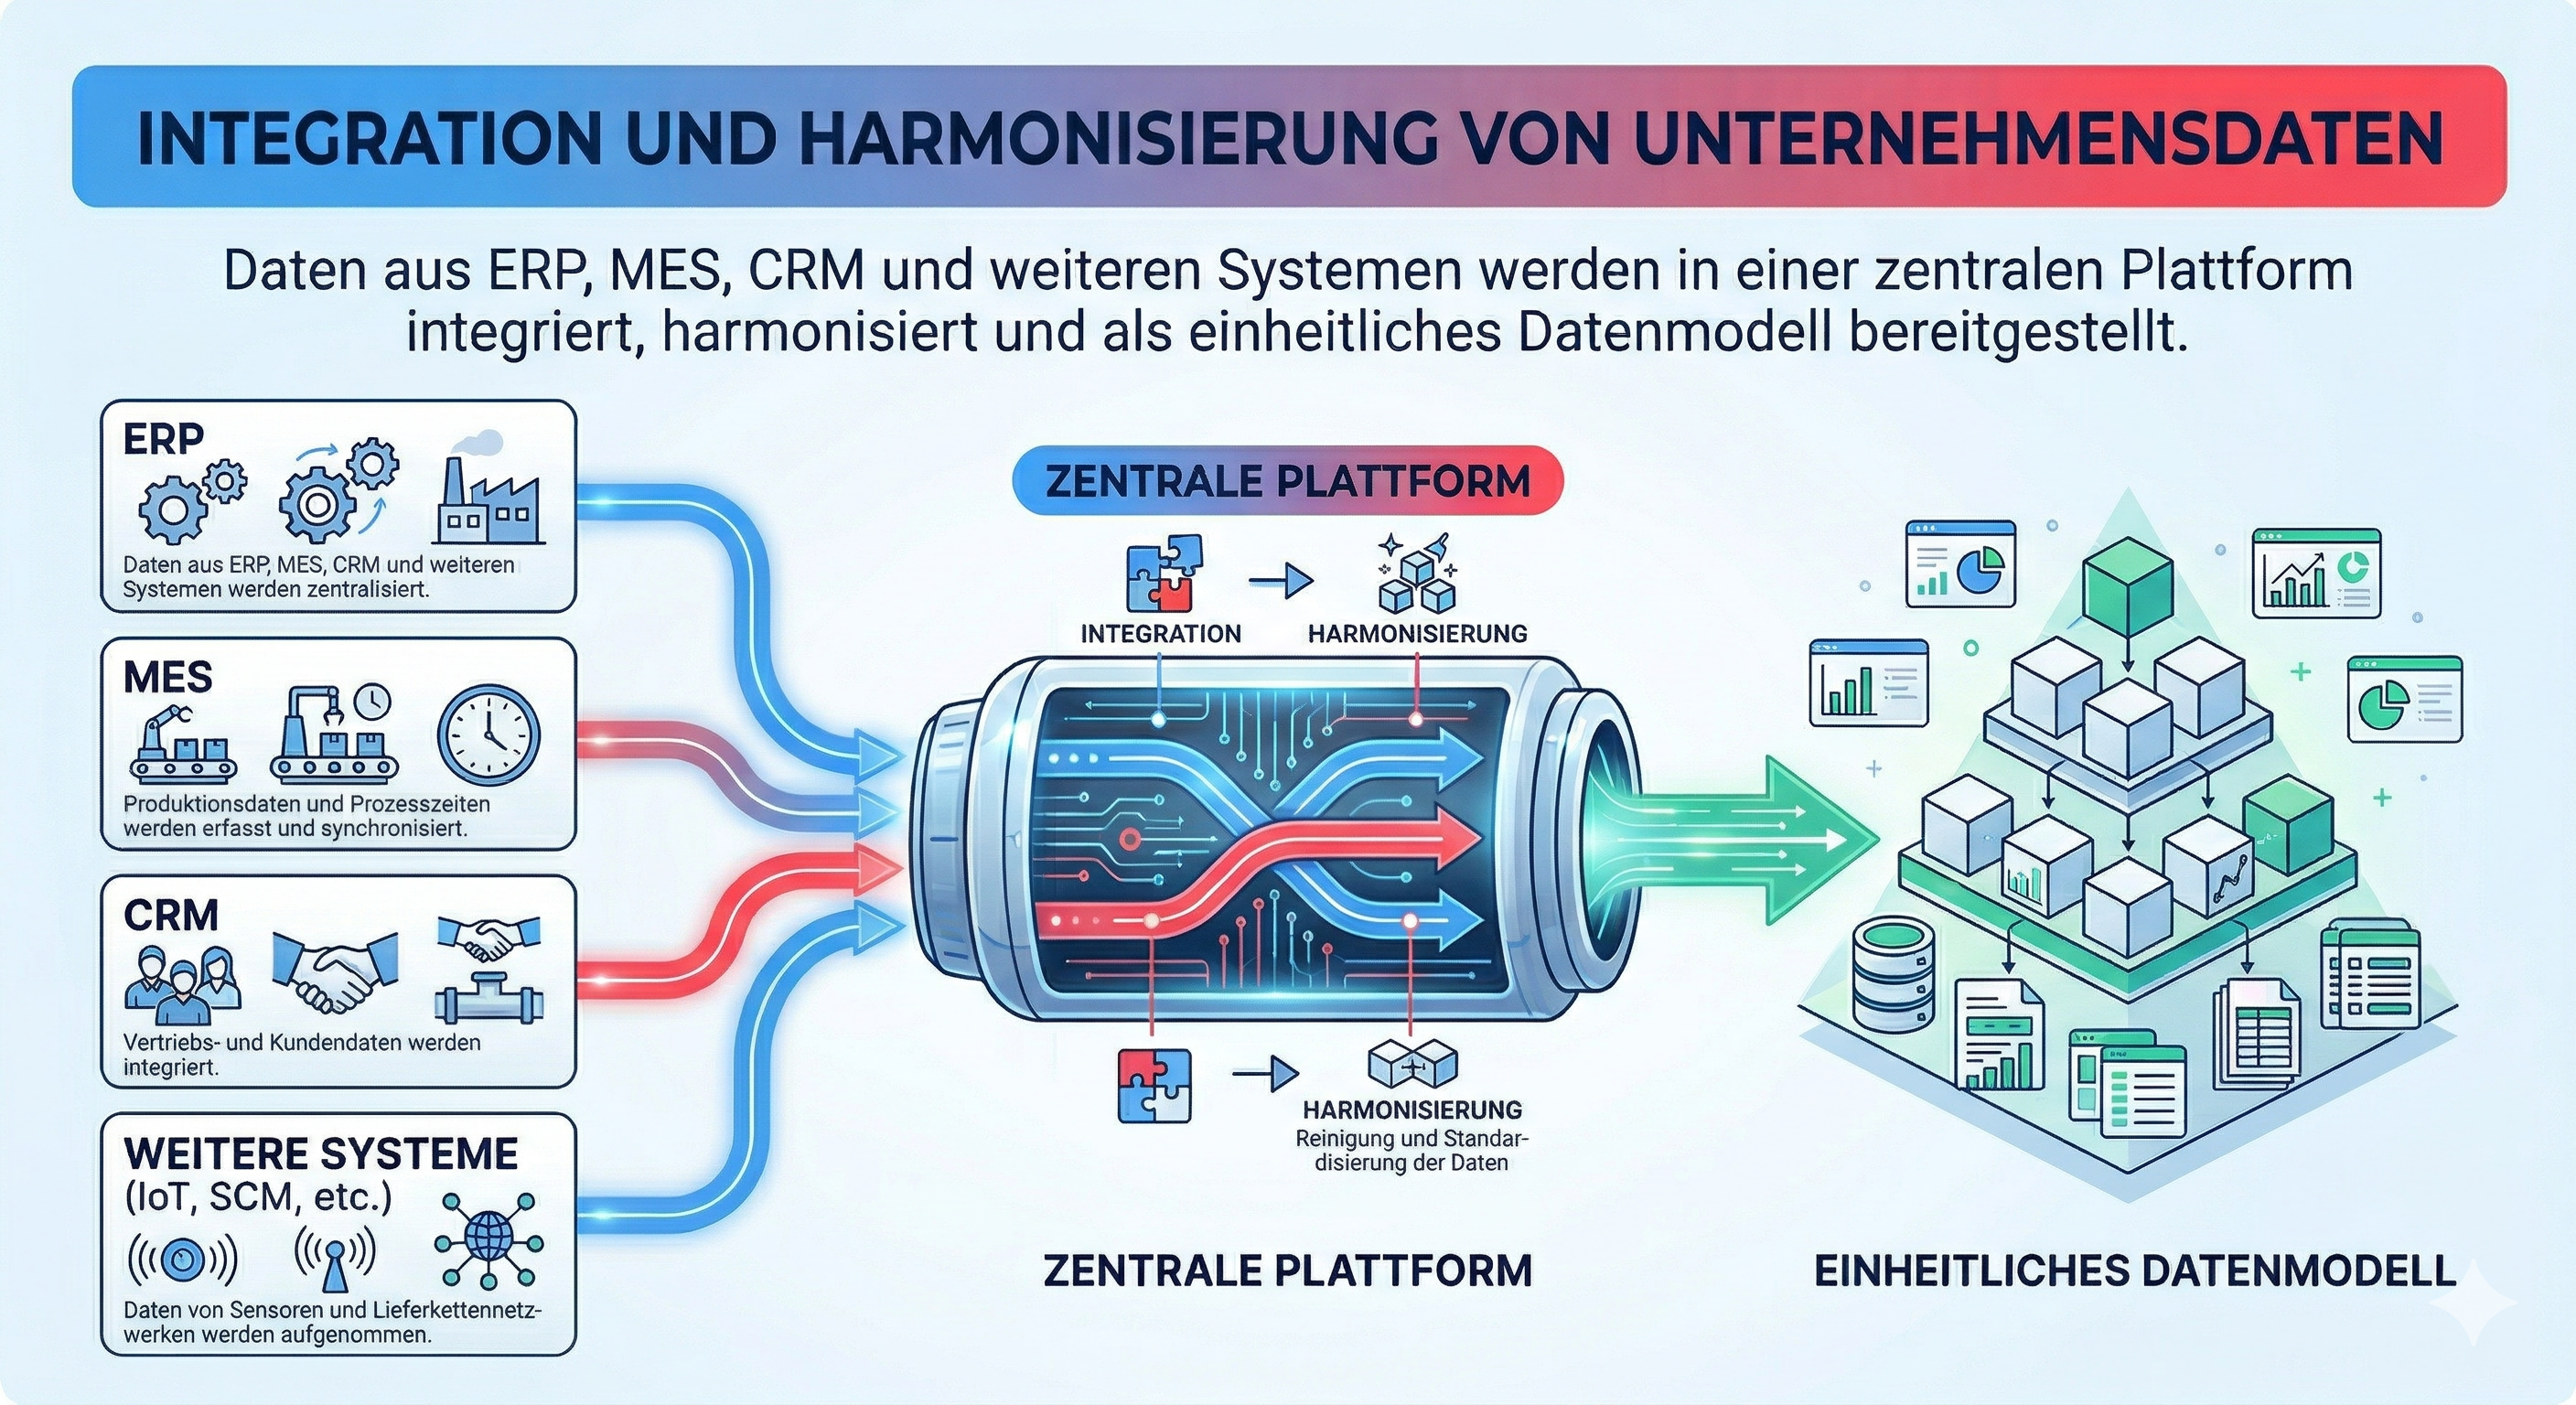
Der Schritt von Einzelsichten zu durchgängigen Prozessanalysen erfordert saubere Integration. Das bedeutet nicht nur technische Verbindungen per Schnittstellen, sondern auch fachliche Verknüpfung über IDs, Zeitstempel und Datenmodelle, die für eine erfolgreiche Datenstrategie wichtig sind und die Nutzung von Data Science ermöglichen.
Typische Integrationspfade reichen von ERP und MES über CAQ und Instandhaltung bis zu CRM und E-Commerce-Systemen. Ziel ist, Kernobjekte wie Auftrag, Produkt, Maschine oder Kunde konsistent über Systemgrenzen hinweg zu verbinden, was eine solide Datenstrategie bildet und die richtigen Daten bereitstellt.
Architektur-Basics: Data Warehouse, Data Lake, Lakehouse & Co. verständlich erklärt
Ein Data Warehouse speichert hochwertige, strukturierte, modellierte Daten für Reporting und Planung. Ein Data Lake sammelt große Datenmengen in Rohform, etwa Sensordaten oder Logfiles, und bietet Flexibilität für spätere Analysen, was die Nutzung von Daten optimiert und die Umsetzung der Datenstrategie unterstützt.
Lakehouse-Ansätze kombinieren beide Welten: Rohdaten und aufbereitete Daten liegen auf einer gemeinsamen Plattform, mit Schichten für Modellierung, Qualität und Zugriff. Für den Mittelstand ist entscheidend, dass die Architektur beherrschbar bleibt und nicht zum Selbstzweck wird.
Schrittweise Verbesserungen statt Perfektionismus
Ein verbreiteter Irrtum ist, dass alle Daten erst „perfekt“ sein müssen, bevor Nutzen entsteht, was die Umsetzung der Datenstrategie verzögert; eine Datenstrategie ist für Unternehmen entscheidend, um schnell Nutzen aus vorhandenen Daten zu ziehen. In der Praxis ist es sinnvoller, mit kritischen Bereichen zu starten und dort Qualität und Integration gezielt zu erhöhen.
Mit jedem priorisierten Use Case wächst so Schritt für Schritt eine stabilere Datenbasis, statt in einem einmaligen „Bereinigungsprojekt“ zu viel auf einmal zu wollen.
Wie Plattformen Datenharmonisierung und ETL/ELT vereinfachen können
Moderne Datenplattformen bieten vorgefertigte Konnektoren, Low-Code-Oberflächen für Transformationslogik und automatisierte Validierungen, um die Effizienz im Datenmanagement zu erhöhen. So lassen sich Integrations- und Harmonisierungsschritte standardisieren und wiederverwenden.
Gerade im Mittelstand, wo Data-Engineering-Ressourcen knapp sind, ist diese Automatisierung ein entscheidender Faktor, um Projekte schnell und nachhaltig umzusetzen und die Nutzung von Daten zu optimieren.
Einheitliche KPIs, Begriffe und Data Governance für die richtigen Daten zur richtigen Zeit
Warum ein gemeinsames Kennzahlenverständnis unverzichtbar ist
Wenn jede Abteilung eigene Definitionen für Umsatz, Deckungsbeitrag oder Liefertreue nutzt, entstehen zwangsläufig widersprüchliche Reports, die die gesamten Unternehmen betreffen. Das schwächt das Vertrauen in hochwertige Daten und erschwert einheitliche Steuerung.
Ein gemeinsamer Kennzahlenkatalog sorgt dafür, dass alle Beteiligten wissen, wie eine Kennzahl berechnet wird, aus welchen Datenquellen sie stammt und wofür sie verwendet werden darf.
Kennzahlenkatalog, Stammdatenlogik und Definitionsregeln
Praktisch bedeutet das, dass Ihr für zentrale Kennzahlen Name, Definition, Formel, Datenquellen, Aktualität und Verantwortliche festhaltet, um die Datenstrategie zu entwickeln und die richtigen Daten zu nutzen. Dazu gehört auch, wie Stammdaten – etwa Materialgruppen, Kundensegmente oder Maschinenklassen – strukturiert werden.
Diese Dokumentation muss nicht kompliziert sein, sie sollte aber in einem zentralen, zugänglichen System gepflegt werden und Teil des täglichen Arbeitens werden.
Data Governance: Rollen, Verantwortlichkeiten und Entscheidungswege
Data Governance beschreibt, wie Entscheidungen rund um Daten getroffen und kontrolliert werden, um die Einhaltung von Richtlinien sicherzustellen. Dazu gehören Rollen wie Data Owner, die für bestimmte Datenbereiche verantwortlich sind, und Data Stewards, die Qualität und Nutzung im Blick behalten.
Wichtig ist, Governance pragmatisch zu halten: klare Verantwortlichkeiten, kurze Entscheidungswege und eine enge Verzahnung mit laufenden Prozessen, statt schwerfälliger Gremienstrukturen.
Data Ownership in Fachbereichen vs. zentrale IT – ein pragmatisches Modell
In der Praxis hat es sich bewährt, die Verantwortung für Inhalte und Definitionen in den Fachbereichen zu verankern, während IT oder Datenplattformteams für technische Umsetzung, Betrieb und Sicherheit zuständig sind.
So bleibt fachliches Wissen dort, wo es entsteht, und wird gleichzeitig durch eine stabile, wiederverwendbare technische Basis unterstützt.
Transparenz schaffen: Data Lineage und Dokumentation
Data Lineage macht sichtbar, wie eine Kennzahl entsteht: von der ursprünglichen Quelle über Transformationsschritte und Mappings bis zum Report. Diese Transparenz ist entscheidend, um Vertrauen zu schaffen und Änderungen kontrolliert auszurollen.
Gleichzeitig erleichtert sie Audits und Fehleranalysen, weil nachvollziehbar ist, welche Anpassung welche Auswirkungen hatte, was für die gesamte Datenstrategie wichtig ist und den Schutz der Daten vor unbefugtem Zugriff unterstützt.
Wie Tools KPI-Management und Governance im Alltag unterstützen können
Spezialisierte Plattformen bieten hochwertige Funktionen für KPI-Kataloge, Versionsverwaltung von Berechnungslogiken und nachvollziehbare Deployment-Prozesse. So wird Governance nicht zur zusätzlichen Last, sondern ein integrierter Bestandteil des täglichen Arbeitens mit Daten.
Für den Mittelstand ist wichtig, dass diese Funktionen ohne aufwändige Tool-Landschaften verfügbar sind und sich nahtlos in bestehende BI-Frontends integrieren lassen.
Wer tiefer in das Thema einsteigen möchte, findet weitere praxisnahe Einblicke in unserer Podcast-Folge „Was ist eine Datenstrategie? Einfach erklärt!“. Dort sprechen wir darüber, warum Unternehmen ohne klare Datenstrategie Geld und Chancen verlieren, welche typischen Fehler in der Praxis auftreten und wie ein sinnvoller Einstieg aussehen kann. Die Folge ergänzt den Artikel um konkrete Erfahrungen aus Projekten im Mittelstand und zeigt, worauf es bei der Umsetzung wirklich ankommt.
Kostenloses Erstgespräch vereinbaren
Datenkultur und Strategie: Warum Menschen für eine wirksame Datenstrategie entscheidend sind
Warum Datenprojekte scheitern, wenn Fachbereiche nicht mitgenommen werden
Viele Dateninitiativen scheitern nicht an Technik, sondern daran, dass Fachbereiche sich nicht abgeholt fühlen oder die neuen Lösungen nicht in ihren Alltag passen. Dann werden alte Excel-Listen weitergeführt, obwohl zentrale Dashboards bereitstehen.
Ein Grund ist oft, dass Fachbereiche zwar Datenlieferanten sind, aber nicht aktiv in Definitionen, Prioritäten und Gestaltung der Lösungen eingebunden werden.
Zusammenarbeit zwischen Management, IT und Fachbereichen organisieren
Erfolgreiche Datenstrategien basieren auf klaren Abstimmungsformaten: regelmäßige Runden zu KPIs, Use-Case-Workshops, gemeinsame Reviews von Dashboards und Datenprodukten. Management setzt den Rahmen, Fachbereiche bringen Anforderungen und Erfahrungen ein, IT sorgt für stabile Umsetzung, um die Datenstrategie der Bundesrepublik voranzutreiben und die Daten voll auszuschöpfen.
Diese Zusammenarbeit muss bewusst organisiert werden, sonst dominieren kurzfristige Einzelanfragen und reaktive Firefighting-Aufgaben.
Kompetenzen aufbauen: Data Literacy, Schulungen und Enablement
Damit Fachbereiche souverän mit Daten arbeiten können, brauchen sie ein Grundverständnis von Kennzahlen, Datenquellen und Grenzen von Analysen. Das bedeutet keine Schulung in Datenbank-Programmierung, sondern praxisnahe Trainings entlang realer Use Cases.
Solche Maßnahmen zahlen direkt auf die Akzeptanz neuer Systeme ein und reduzieren Abhängigkeiten von einzelnen Data-Spezialistinnen und -Spezialisten, was für die Implementierung einer Datenstrategie entscheidend ist.
Change-Management: Vom „Bericht bestellen“ zur aktiven Datennutzung
In vielen Organisationen ist es üblich, Berichte bei IT oder Controlling „zu bestellen“. Eine datengetriebene Kultur bedeutet dagegen, dass Fachbereiche aktiv mit technologisch fortschrittlichen Daten arbeiten, Hypothesen formulieren und selbstständig Analysen durchführen können, was für die Datenstrategie entscheidend ist.
Das erfordert nicht nur Tools, sondern auch eine Veränderung im Rollenverständnis: weg von reiner Datenlieferung, hin zu gemeinsamer Verantwortung für Daten und Entscheidungen, was Teil einer gut durchdachten Datenstrategie ist.
Praktische Hebel für mehr Datenakzeptanz im Alltag
Akzeptanz entsteht dort, wo Daten den Alltag sichtbar erleichtern. Das können beispielsweise verlässliche Standardreports zur Produktionsleistung, leicht verständliche Service-Dashboards oder automatisierte Warnmeldungen bei Risiken in der Supply Chain sein, die entscheidend für die Umsetzung der Datenstrategie sind.
Wichtig ist, diese Erfolge sichtbar zu machen und Nutzende aktiv einzubinden – etwa durch Feedback-Runden oder gemeinsame Weiterentwicklungen von Dashboards.
Datenarchitektur, Tools und Make-or-buy: Die technische Basis einer Datenstrategie
Grundprinzipien einer skalierbaren Datenarchitektur für den Mittelstand
Eine gute Datenarchitektur ist so einfach wie möglich, aber so flexibel wie nötig, um das Potenzial von Daten voll auszuschöpfen. Sie sollte zentrale Datenhaltung, klare Schnittstellen und wiederverwendbare Modelle bieten, ohne jeden Spezialfall durch Sonderlösungen zu bedienen.
Kernprinzipien sind Modularität, Automatisierung, Transparenz und die Trennung von Rohdaten, Modellierungslogik und Zugriffsschichten, um die Daten vor unbefugtem Zugriff zu schützen. So bleiben Anpassungen beherrschbar, auch wenn Anforderungen wachsen, und die Einhaltung von Standards wird sichergestellt.
On-Premise, Cloud oder Hybrid? Kriterien für die Entscheidung
Die Wahl zwischen On-Premise, Cloud oder Hybrid hängt von vielen Faktoren ab: vorhandene Infrastruktur, Datenschutzanforderungen, benötigte Skalierbarkeit und interne Ressourcen. Cloud-Lösungen bieten oft schnellere Verfügbarkeit und integrierte Services, während On-Premise maximale physische Kontrolle und Anpassungsfähigkeit an Geschäftszielen ermöglicht.
Hybrid-Modelle kombinieren beides und sind gerade bei sensiblen Daten oder bestehenden Rechenzentren eine realistische Option. Entscheidend ist, dass die Architektur nicht zum Bremsklotz künftiger BI- oder KI-Initiativen wird.
Make-or-buy: Wann Eigenentwicklung, wann Plattform?
Eigenentwicklung bietet maximale Flexibilität, erfordert aber ein starkes technisches Team und langfristige Wartungskapazitäten. Plattformlösungen reduzieren Entwicklungsaufwand, standardisieren wiederkehrende Aufgaben und entlasten knappe Fachkräfte.
Eine sinnvolle Datenstrategie legt fest, wo individuelle Entwicklung echten Mehrwert bringt und wo Standardisierung und Automatisierung wirtschaftlicher sind, während sie gleichzeitig Bereiche mit Verbesserungspotenzial identifizieren hilft.
| Option | Stärken | Risiken |
|---|---|---|
| Eigenentwicklung | Hohe Flexibilität, passgenaue Lösungen, volle Kontrolle. | Hoher Ressourcenbedarf, Abhängigkeit von wenigen Expert:innen, längere Time-to-Value. |
| Plattform | Schneller Einstieg, vorgefertigte Konnektoren, integrierte Governance. | Die Abhängigkeit vom Anbieter und Anpassungen im Rahmen der Plattformlogik können die Umsetzung einer effektiven Datenstrategie behindern, was zu unbefugtem Zugriff führen kann. |
| Hybrid | Kombiniert Standardfunktionen mit gezielter Eigenentwicklung. | Erfordert klare Architektur- und Governance-Regeln, um Komplexität zu vermeiden. |
Low-Code- und Automatisierungsansätze als Antwort auf Fachkräftemangel
Angesichts knapper Data-Engineering-Ressourcen ist es für viele Mittelständler entscheidend, wiederkehrende Aufgaben zu automatisieren. Low-Code-Plattformen ermöglichen es Fachbereichen, fachliche Logiken einzubringen, ohne tief in Code einsteigen zu müssen.
Gleichzeitig entlasten sie die IT von Routineaufgaben wie der Anlage neuer Datenpipelines oder der Anpassung standardisierter Transformationsregeln, was mit den richtigen Tools und Technologien effizienter gestaltet werden kann.
Wie Du bestehende BI-Frontends sinnvoll einbindest (Power BI, Tableau, Qlik, Excel)
In vielen Unternehmen sind BI-Frontends bereits etabliert. Eine sinnvolle Datenstrategie ersetzt diese nicht zwangsläufig, sondern stellt eine konsistente, zentrale Datenbasis bereit, auf die diese Tools zugreifen.
So können Anwenderinnen und Anwender in vertrauten Werkzeugen arbeiten, während Integrations-, Modellierungs- und Governance-Themen auf einer zentralen Plattform gelöst werden, um die richtigen Daten zur richtigen Zeit bereitzustellen.
Kostenloses Erstgespräch vereinbaren
Schrittweise Implementierung: Von ersten Use Cases zur skalierbaren Datenstrategie mit KI und Data Science
Use Cases wählen: Hoher Nutzen, überschaubare Komplexität
Die ersten Umsetzungsprojekte sollten einen spürbaren Nutzen bringen, ohne technisch zu überfordern. Gute Beispiele sind ein zentrales KPI-Dashboard für Management, eine Ausschussanalyse oder ein Liefertreue-Report mit klarer Ursachenstruktur.
Entscheidend ist, dass diese Use Cases repräsentativ für spätere Erweiterungen sind, sodass die dabei aufgebauten Datenmodelle und Prozesse wiederverwendet werden können, was die gesamte Datenstrategie bildet.
Von manuellen Reports zu wiederverwendbaren Datenpipelines
Anstatt manuelle Reportings parallel weiterzuführen, sollten im Rahmen der Pilot-Use-Cases automatisierte Datenpipelines aufgebaut und dokumentiert werden. So entsteht Schritt für Schritt ein wiederverwendbares Datenfundament.
Mit jeder neuen Kennzahl und jedem neuen Report wird die Plattform wertvoller, weil zusätzliche Anforderungen auf bestehenden Strukturen aufsetzen können, um das Potenzial von Daten voll auszuschöpfen.
Iteratives Vorgehen: Lernen, anpassen, ausrollen
Kein Modell ist von Anfang an perfekt. Ein iterativer Ansatz, bei dem regelmäßiges Feedback aus den Fachbereichen eingeholt und in kurzen Zyklen Anpassungen vorgenommen werden, ist deutlich erfolgreicher als starre Großprojekte, insbesondere bei der Implementierung einer Datenstrategie.
So können auch Governance-Regeln, Qualitätschecks und Rollenverteilungen anhand konkreter Erfahrungen geschärft werden.
Monitoring, KPIs und Governance im laufenden Betrieb
Sobald erste Pipelines produktiv laufen, ermöglicht es Unternehmen, Monitoring und Datenqualitäts-Checks zentral zu implementieren. Fehler oder Ausfälle sollten automatisch erkannt und nachvollzogen werden können, bevor sie sich in kritischen Reports bemerkbar machen.
Governance wird damit zum operativen Prozess: Änderungen an Datenmodellen, KPIs oder Zugriffsrechten folgen definierten Abläufen und sind für alle Beteiligten transparent.
Wann der Zeitpunkt für KI-Use-Cases gekommen ist
KI-Projekte werden dann sinnvoll, wenn Datenquellen verlässlich integriert, Datenprodukte definiert und Governance-Fragen geklärt sind. Dann lassen sich Vorhersagen und Mustererkennung auf stabile, reproduzierbare Grundlagen stellen.
In vielen Fällen lohnt es sich, zuerst mit klassischen BI- und Prognose-Anwendungen zu starten und KI darauf aufzusetzen, statt umgekehrt mit KI-Piloten zu beginnen und die Datenbasis später „nachzuziehen.
Wie die bimanu Cloud Unternehmen bei der Implementierung einer Datenstrategie unterstützt
bimanu als operative Ebene Deiner Datenstrategie – kein reines BI-Tool
Wenn Datenstrategie, Ziele und Governance definiert sind, braucht es eine Plattform, die diese Leitlinien technisch umsetzt. Die bimanu Cloud setzt genau hier an: als vollständig automatisierte Datenplattform, die Datenintegration, Modellierung, Qualitätssicherung und Bereitstellung in einem System bündelt.
Im Unterschied zu klassischen BI-Tools beginnt bimanu deutlich früher im Prozess – bei der strukturierten Erzeugung einer zentralen Datenbasis, auf die Deine bestehenden BI-Frontends zugreifen können.
Zentrale Datenbasis: Multi-Quellen-Anbindung, Harmonisierung und automatisierte Datenmodelle
Die bimanu Cloud verbindet ERP, MES, CRM, Marketing- und weitere Systeme über vorgefertigte Konnektoren und bringt die Daten in einheitliche, wiederverwendbare Modelle, die die Verwaltung und Nutzung von Daten optimieren. Fachliche und technische Datenmodelle entstehen per Low-Code und werden automatisch validiert, was Best Practices in der Datenstrategie widerspiegelt.
So entsteht ein „Single Point of Truth“, auf dem Du Reports, Analysen und KI-Anwendungen aufbauen kannst, um Geschäftszielen gerecht zu werden, ohne für jede neue Fragestellung eigene Integrations- und Bereinigungslogik zu entwickeln.
Datenarchitektur & Governance: Data Vault, Data Lineage, KPI-Katalog und Versionierung
Bimanu unterstützt bewährte Modellierungsansätze wie Data Vault, Versionierung von Modellen und Transformationen sowie Data Lineage. Dadurch bleiben Änderungen nachvollziehbar und Auswirkungen auf Berichte transparent.
Ergänzend hilft die Plattform, Kennzahlenstrukturen und fachliche Definitionen zentral zu hinterlegen, um die Daten in einem zentralen Repository zu organisieren. Das zahlt direkt auf Data Governance und Audit-Fähigkeit ein.
Low-Code-Ansatz: Weniger Abhängigkeit von knappen Data-Engineering-Ressourcen
Viele Arbeitsschritte in der Datenintegration, Modellierung und Qualitätssicherung können in der bimanu Cloud per Low-Code gestaltet werden, um Daten effektiv zu nutzen und Innovationen in den Bereichen zu fördern. Fachbereiche können so fachliche Logiken einbringen, ohne SQL oder Skriptsprachen zu beherrschen, und somit Daten effektiv nutzen, was das Teilen von Daten erleichtert.
Gleichzeitig generiert die Plattform den notwendigen technischen Code automatisch im Hintergrund, was Entwicklungsaufwand reduziert und die Qualität der Implementierung einer Datenstrategie sichert, insbesondere durch den Einsatz generativer KI.
Offenheit im Frontend: Weiterarbeiten mit Power BI, Tableau, Qlik oder Excel
Die bimanu Cloud ist bewusst offen für verschiedene Visualisierungs- und Analysewerkzeuge gestaltet. Du kannst bestehende BI-Frontends wie Power BI, Tableau, Qlik oder auch Excel weiter nutzen und sie auf die harmonisierten Datenmodelle der Plattform aufsetzen.
Dadurch bleibt das Nutzererlebnis für Deine Teams vertraut, während sich im Hintergrund hochwertige Datenstrukturen, Qualität und Governance deutlich verbessern, was das Potenzial von Daten voll ausschöpft.
Skalierbarer Betrieb: Deployment, Scheduling, Monitoring und Berechtigungen
Neben Modellierung und Integration deckt die bimanu Cloud auch Betriebsthemen ab: automatisierte Ladeprozesse, Deployment von Änderungen in Test- und Produktivumgebungen, Monitoring und Alarmierung bei Fehlern sowie rollenbasierte Berechtigungskonzepte.
Für Dich bedeutet das: weniger manuelle Eingriffe im Tagesgeschäft, mehr Transparenz im Betrieb und eine Plattform, die mit den Anforderungen wachsen kann, ohne unübersichtlich zu werden, sodass Du die Unternehmensziele vorantreiben kannst.
Schnelle Erfolge statt Großprojekt: Typische Einstiegs-Szenarien im Mittelstand
In der Praxis starten viele Unternehmen mit einem klar umrissenen Szenario, etwa einem Management-KPI-Cockpit, einer integrierten Ausschussanalyse oder einer harmonisierten Liefertreue-Auswertung über mehrere Werke. Diese Use Cases lassen sich mit der bimanu Cloud innerhalb überschaubarer Zeiträume umsetzen, was die Implementierung einer Datenstrategie erleichtert.
Schritt für Schritt können weitere Bereiche angebunden und Modelle erweitert werden – immer entlang Deiner Datenstrategie und ohne jedes Mal ein neues Projekt von Grund auf zu beginnen.
Datenstrategie im Mittelstand: Praxisleitfaden für bessere Daten, klare Geschäftsziele und wirksame Umsetzung
Eine Datenstrategie ist die Brücke zwischen Unternehmenszielen und täglicher Datenarbeit, da sie Maßnahmen zur Verwaltung und Nutzung von Daten beinhaltet. Sie klärt, welche Daten Du brauchst, wie Du sie strukturierst, wer wofür verantwortlich ist und wie aus all dem messbarer geschäftlicher Nutzen entsteht.
Für mittelständische Unternehmen ist der Weg dorthin kein Großprojekt, sondern eine Folge bewusster Schritte: ehrliche Bestandsaufnahme, klare Priorisierung, fokussierte Use Cases, passende Architektur und eine Plattform, die diese Entscheidungen zuverlässig in den Alltag trägt.

Datenstrategie FAQ: Warum sie wichtig ist, welche Tools helfen und wie Unternehmen starten
Was ist eine Datenstrategie in einfachen Worten erklärt?
Eine Datenstrategie ist der Plan, wie Dein Unternehmen Daten sammelt, organisiert und nutzt, um die eigenen Geschäftsziele besser zu erreichen und die Datenverwaltung zu optimieren. Sie legt fest, welche Daten wichtig sind, wer dafür verantwortlich ist und wie daraus verlässliche Reports, Analysen und Automatisierungen entstehen, was zeigt, warum eine Datenstrategie wichtig ist.
Ab welcher Unternehmensgröße lohnt sich eine Datenstrategie?
Spürbar wird der Nutzen meist ab etwa 100 bis 200 Mitarbeitenden und mehreren Systemen oder Standorten, was die organisatorische Nutzung von Daten verbessert. Aber entscheidender als die Größe ist die Komplexität Deiner Prozesse und der Druck durch Reporting, Wachstum oder Regulatorik – je höher dieser ist, desto eher zahlt sich eine strukturierte Datenstrategie aus.
Wie starte ich eine Datenstrategie, wenn wir aktuell „nur“ mit Excel und ein paar BI-Reports arbeiten?
Beginne mit einer Bestandsaufnahme Deiner wichtigsten Reports und den dazugehörigen Datenquellen. Identifiziere, wo der meiste manuelle Aufwand entsteht und welche Kennzahlen für Deine Steuerung kritisch sind, und definiere dann 1–2 Use Cases, die Du automatisieren und zentralisieren willst.
Wie viel muss technisch stehen, bevor wir mit einer Datenstrategie beginnen können?
Für die Erarbeitung einer Datenstrategie brauchst Du keine fertige Plattform, sondern vor allem Klarheit über Ziele, Prozesse und bestehende Systeme. Die technische Architektur und eventuelle Plattformentscheidungen ergeben sich im Verlauf der Strategiearbeit – nicht davor.
Wer sollte in einem mittelständischen Unternehmen die Datenstrategie verantworten?
Idealerweise liegt die Verantwortung bei einer Person mit übergreifender Sicht, etwa dem Geschäftsführer, CFO, COO oder einem CDO, in enger Zusammenarbeit mit IT und Fachbereichen. Wichtig ist, dass die Rolle ausreichend Mandat hat, um bereichsübergreifend Standards zu setzen und Prioritäten zu definieren.
Wie lange dauert es typischerweise, bis erste Erfolge sichtbar sind?
Erste, konkrete Verbesserungen – etwa automatisierte Reports oder ein harmonisiertes KPI-Set für einen Kernprozess – ermöglichen es Unternehmen oft, innerhalb von drei bis sechs Monaten zu realisieren. Der vollständige Aufbau einer reifen Datenlandschaft ist dagegen ein mehrjähriger, iterativer Prozess.
Kann ich KI-Projekte starten, bevor eine vollständige Datenstrategie existiert?
Einzelne KI-Piloten sind auch ohne ausgereifte Datenstrategie möglich, bleiben dann aber meist Insellösungen, die nicht die volle Bandbreite der Möglichkeiten ausschöpfen. Sinnvoller ist es, zumindest zentrale Grundlagen wie Datenquellen, Qualitätsstandards und Governance zu klären, bevor Du KI in größerem Umfang einsetzt.
Wie stelle ich sicher, dass Fachbereiche und IT bei der Datenstrategie wirklich zusammenarbeiten?
Definiere klare gemeinsame Formate, etwa KPI-Workshops, Lenkungskreise oder regelmäßige Review-Termine zu Datenprodukten, um die Datenstrategie und das Team zu stärken, und benenne feste Ansprechpersonen auf beiden Seiten. Ergänzend helfen gemeinsame Ziele und KPIs, damit alle in dieselbe Richtung arbeiten.
Wie unterscheidet sich eine Plattform wie bimanu von klassischer BI-Software?
Klassische BI-Software fokussiert sich vor allem auf Visualisierung und Self-Service-Analysen, setzt aber oft eine vorbereitete Datenbasis voraus. Die bimanu Cloud beginnt früher, indem sie Daten aus verschiedenen Systemen integriert, modelliert, qualitätsgesichert und als zentrale Basis für beliebige BI-Frontends bereitstellt.
Wir haben wenig interne IT-Ressourcen – ist eine Datenstrategie trotzdem realistisch?
Ja, wenn Du den Fokus auf wenige, wirkungsstarke Use Cases legst und auf Plattformen setzt, die Integrations- und Modellierungsaufwand reduzieren, kannst Du die Daten voll ausschöpfen und eine erfolgreiche Datenstrategie implementieren. Eine klare Datenstrategie hilft Dir gerade dann, knappe Ressourcen auf das Wesentliche zu konzentrieren und Automatisierung gezielt einzusetzen.