
Microsoft Fabric für den Mittelstand: Warum die Plattform selten passt – und was die Alternative ist
Ausgangslage im Mittelstand: Datenchaos trotz Power BI
Drei Abteilungen, drei Wahrheiten: Warum niemand den Zahlen traut
In vielen mittelständischen Unternehmen ist Power BI längst eingeführt, aber das Grundproblem bleibt: Controlling, Vertrieb und Produktion arbeiten mit unterschiedlichen Kennzahlenlogiken. Die Folge ist, dass dieselbe Frage – etwa „Wie hoch war der Umsatz im letzten Quartal?“ – je nach Abteilung zu drei verschiedene Antworten führt.
In der Praxis entstehen diese Differenzen durch fehlende einheitliche Definitionen, manuelle Excel-Zwischenschritte und voneinander unabhängige Reports. Selbst wenn alle im selben Tool arbeiten, fehlt die zentrale Datenbasis, die eine einzige, verbindliche Datenwahrheit sicherstellt – das Vertrauen in die Zahlen bleibt gering.
„Wir wissen gar nicht, wo wir anfangen sollen“: fehlende Datenstrategie
Parallel zur Tool-Einführung bleibt häufig eine Frage unbeantwortet: Welche Geschäftsfragen sollen mit Daten wirklich gelöst werden? Statt einer klar priorisierten Roadmap entstehen viele Einzelinitiativen, die jeweils nur einen Ausschnitt des Unternehmens abbilden.
Ohne Datenstrategie fehlt der rote Faden für Architektur, Governance und Verantwortlichkeiten. Das führt dazu, dass BI-Projekte lange laufen, aber nie „fertig“ sind – und Entscheider den Eindruck gewinnen, dass Reporting „ein Fass ohne Boden“ ist.
Unkalkulierbare Cloud- und Speicherkosten: die 3-Jahres-Frage
Spätestens beim Blick in die Cloud-Rechnung stellt sich im Mittelstand die 3‑Jahres-Frage: Was kostet uns diese Plattform, wenn wir sie wirklich unternehmensweit nutzen? Viele Modelle basieren auf verbrauchsabhängigen Kapazitäten, die sich nur mit aktivem Monitoring steuern lassen.
Hinzu kommen versteckte Kosten für Speicher, Datentransfers, Premium-Funktionen oder KI-Funktionen wie Copilot, die zusätzliche Kapazitäten verbrauchen. Für Entscheider wird es damit schwer, Budgets zu planen und einen belastbaren Business Case zu formulieren.
Buzzword-Dschungel: KI, Data Lake, Fabric, Databricks – was davon braucht der Mittelstand?
Parallel explodiert die Anzahl der Begriffe: Data Lake, Lakehouse, Fabric, Databricks, Copilot, Generative AI. Viele mittelständische Teams haben weder die Zeit noch die Ressourcen, jede neue Plattform in der Tiefe zu verstehen – sie sollen aber trotzdem heute eine Entscheidung treffen.
In der Folge wird häufig nach Logo oder Lieferant entschieden: „Wir sind ohnehin im Microsoft-Stack, dann nehmen wir auch Fabric.“ Ob das eigene Datenvolumen, die Use Cases und das Team tatsächlich zu einer Enterprise-Plattform passen, wird selten systematisch geprüft.
Was ist Microsoft Fabric – und für wen wurde es gebaut?
Definition: Microsoft Fabric als einheitliche Daten- und Analytics-Plattform
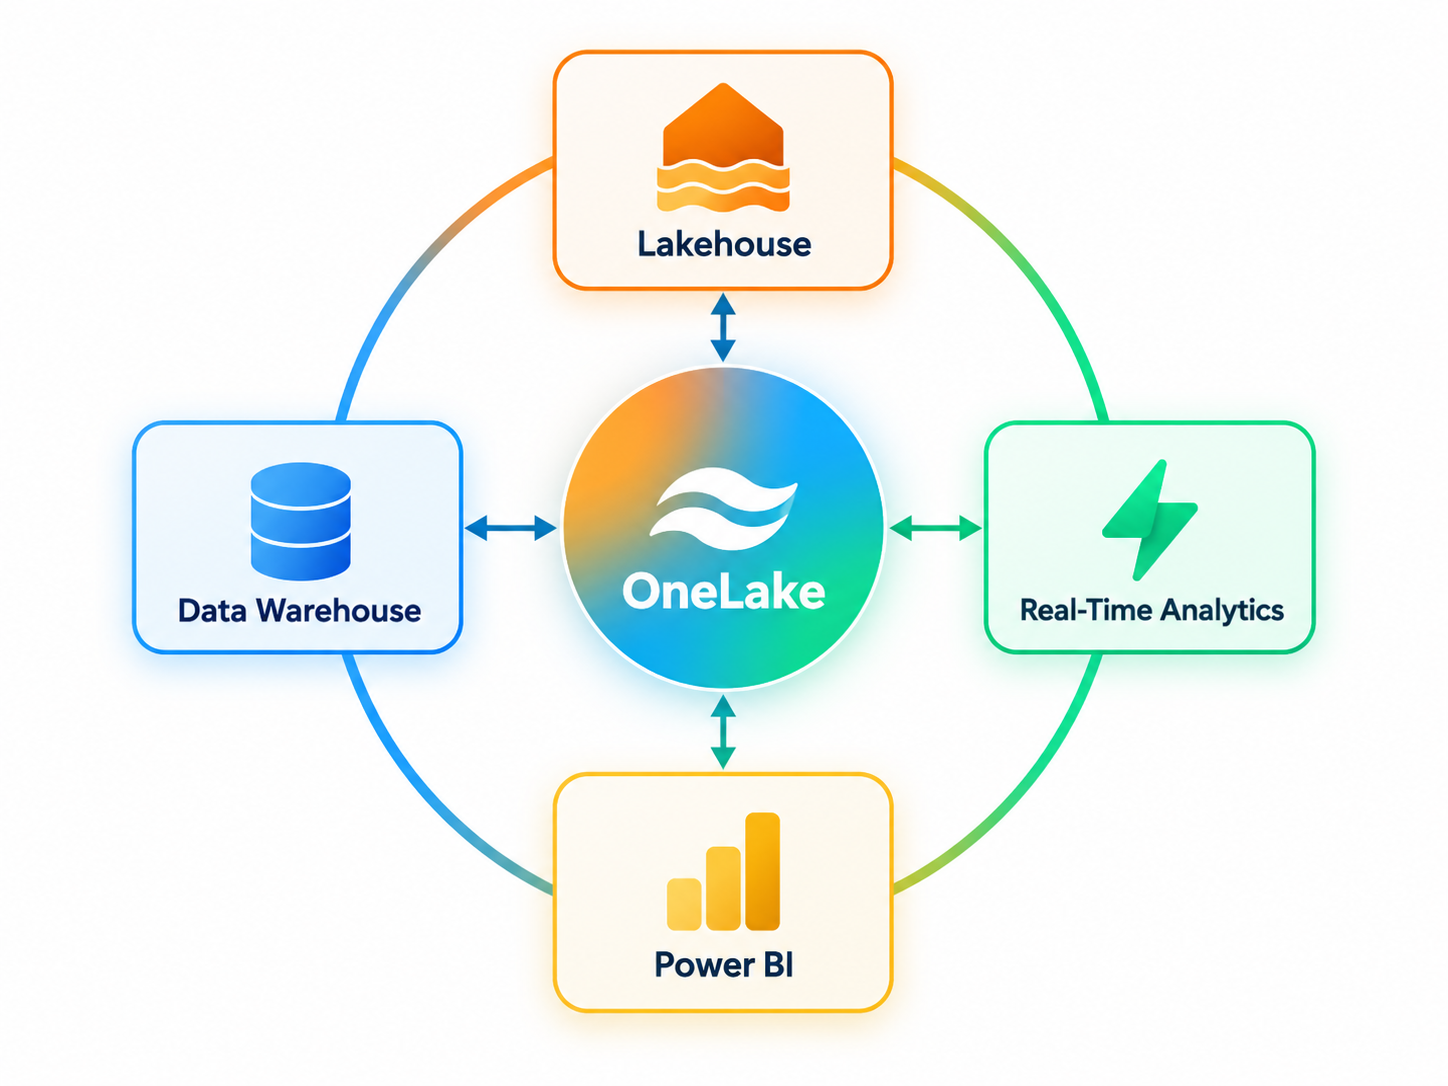
Microsoft Fabric ist eine SaaS-Datenplattform, die Datenintegration, Data Lake, Data Warehouse, Data Engineering, Data Science, Echtzeit-Analytik und Power BI in einer Oberfläche bündelt. Technisch basiert alles auf OneLake als zentralem logischen Datenspeicher und Fabric-Kapazitäten als Rechenschicht.
Die Plattform ist darauf ausgelegt, Analytics-Landschaften in großen Organisationen zu vereinheitlichen: weg von vielen einzelnen Azure-Services hin zu einer zentral gesteuerten Kapazität mit gemeinsamer Governance und Sicherheitsmodell. Genau das macht Fabric im Enterprise-Umfeld attraktiv – und für kleinere Teams schnell komplex.
Wichtige Komponenten in der Praxis: OneLake, Lakehouse, Data Warehouse, Real-Time Intelligence, Power BI
Kern von Fabric ist OneLake, ein zentraler Data Lake, auf dem unterschiedliche Workloads aufsetzen: Lakehouse für dateibasierte Analysen, das relationale Data Warehouse für strukturierte Daten und Real-Time Intelligence für Streaming-Daten. Dazu kommen Werkzeuge wie Data Factory für Pipelines und Data Engineering mit Notebooks.
Power BI ist als Visualisierungsebene tief integriert und wird zunehmend als Frontend der gesamten Plattform positioniert. Unternehmen sollen idealerweise Integrationspipelines, Speicherstrukturen, semantische Modelle und Dashboards im selben Fabric-Tenant betreiben – inklusive KI-Funktionen wie Copilot für Analysen und Berichtserstellung.
Welche Probleme Fabric in Konzernen löst
In Konzernen existieren oft dutzende Datenplattformen parallel: unterschiedliche Azure-Setups, historische DWHs, verschiedenste BI-Tools. Fabric adressiert diesen Wildwuchs, indem es Kapazität, Governance und Sicherheit in einem Modell bündelt und so Standardisierung ermöglicht.
Außerdem profitieren große Organisationen von Features wie Multi-Region-Setup, granularer Kapazitätssteuerung über mehrere Abteilungen und enger Integration in Microsoft Purview für Katalog, Lineage und Compliance. Dort gibt es Teams, die sich ausschließlich um Datenarchitektur, Governance und Kapazitätsmanagement kümmern.
Warum Fabric im Mittelstand oft im falschen Kontext eingesetzt wird
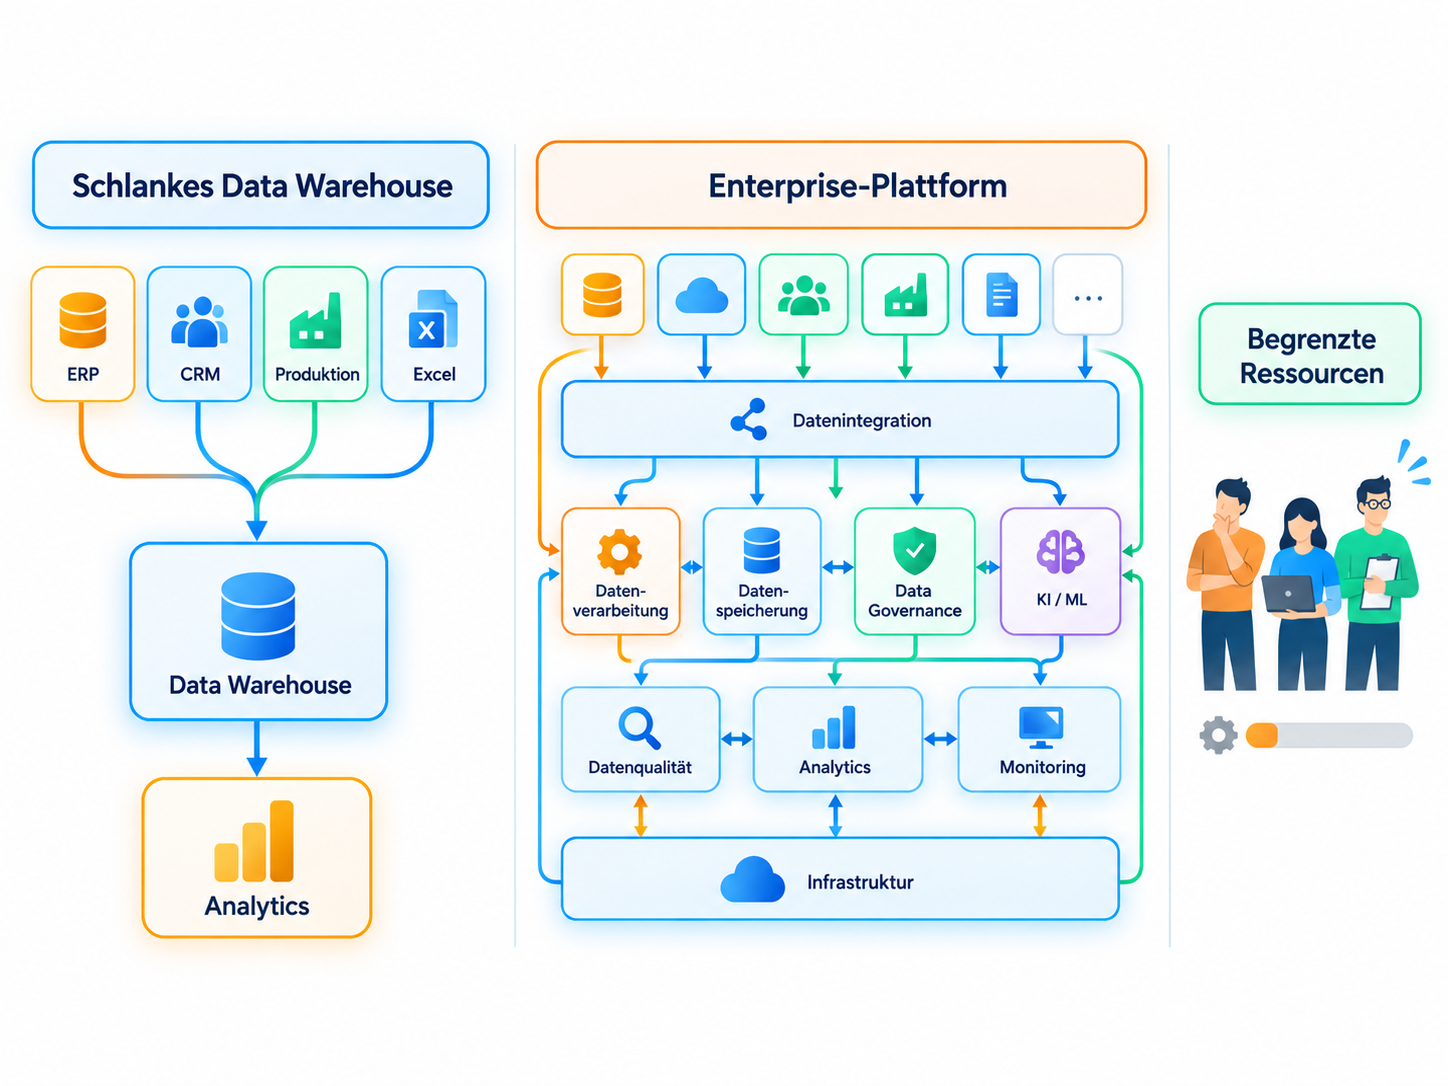
Im Mittelstand ist die typische Ausgangslage anders: wenige Kernsysteme, überschaubare Datenvolumina, aber hoher Druck auf Reporting und begrenzte IT-Ressourcen. Hier soll eine Plattform in erster Linie schnell belastbare Dashboards und ein sauberes Data Warehouse liefern – nicht eine komplette Enterprise-Analytics-Landschaft.
Wenn Fabric in diesem Kontext als „nächstes Power BI“ eingeführt wird, ohne Rollen, Governance und Kapazitätsmodell mitzudenken, kippt das Projekt schnell in Überforderung. Das Ergebnis ist dann nicht selten: hohe Grundkosten, viele Optionen – aber wenig zusätzliche Klarheit gegenüber der bisherigen BI-Landschaft.
Lizenz- und Kostenmodell von Microsoft Fabric: Warum viele den Überblick verlieren
Wie Fabric lizenziert wird: Pro, Premium, E5, Fabric-Kapazitäten
Microsoft Fabric kombiniert zwei Welten: Nutzerlizenzen für Power BI (z. B. Pro, PPU oder E5) und organisationsweite Kapazitäten über F‑SKUs. Autorinnen und Autoren brauchen weiterhin in der Regel eine Power BI Pro- oder PPU-Lizenz, um Inhalte zu erstellen und zu veröffentlichen.
Hinzu kommen Fabric-Kapazitäten, die als F‑SKUs (z. B. F8, F32, F64) gebucht werden und Rechenleistung über Capacity Units (CUs) bereitstellen. Ab F64 dürfen Viewer Power-BI-Inhalte in Fabric-Workspaces auch mit kostenloser Lizenz konsumieren; darunter benötigen sie zusätzliche Pro-/PPU-Lizenzen – ein wichtiger Kostentreiber bei vielen Report-Konsumenten.
Kapazitätsmodell mit F-SKUs: Funktionsweise und typische Missverständnisse
Technisch rechnet Fabric Verbrauch in Capacity Units, die je nach F‑SKU bereitgestellt werden. Eine F8-Kapazität stellt beispielsweise deutlich weniger CUs bereit als eine F32 oder F64, entsprechend steigt mit größerer Kapazität die Anzahl paralleler Jobs, Refreshes und Copilot-Anfragen, bevor Throttling greift.
Ein verbreitetes Missverständnis ist, dass mit einer einmal gebuchten Kapazität „alles performant läuft“. In der Realität müssen Workloads geplant, überwacht und teilweise entkoppelt werden, um Lastspitzen und Überlast zu vermeiden. Die Capacity Metrics App liefert dafür Kennzahlen – setzt aber voraus, dass sich jemand aktiv darum kümmert.
Compute-, Speicher- und Zusatzkosten: wo die versteckten Kosten lauern
Neben den Lizenz- und Kapazitätskosten entstehen weitere Kostenpositionen: Speicher im OneLake, Netzwerkkosten für Datenbewegungen sowie zusätzliche Services oder Premium-Features. Hinzu kommen potenzielle Mehrkosten durch KI-Funktionen wie Copilot, der laut Microsoft tokenbasiert ebenfalls CUs verbraucht.
Gerade im Mittelstand werden diese Kosten selten von Anfang an in einer Vollkostenrechnung abgebildet. Während der Start mit einer kleineren Kapazität überschaubar wirkt, steigen die Ausgaben später durch mehr Nutzer, weitere Datenquellen und KI-Nutzung – ohne dass der Zusammenhang für das Management immer transparent ist.
Warum die Kosten über Kapazitäten statt Nutzer im Mittelstand zur Blackbox werden
Viele mittelständische Entscheider sind es gewohnt, Software primär nach Nutzerlizenzen zu kalkulieren. Fabric verschiebt den Schwerpunkt auf laufende Kapazitätskosten, die eng mit technischer Nutzung verknüpft sind. Damit werden Kostensteuerung und Budgetplanung zu einer gemeinsamen Aufgabe von IT und Fachbereichen.
Ohne klare Regeln, wer wann welche Workloads betreibt, und ohne regelmäßiges Kapazitäts-Monitoring entsteht schnell eine gefühlte Blackbox. In der Praxis ist dann unklar, ob steigende Kosten aus intensiver Nutzung, ineffizienten Pipelines, KI-Experimenten oder falsch dimensionierten Kapazitäten resultieren.
Planbare vs. variable Kosten: was Entscheider wirklich brauchen
Für mittelständische Unternehmen ist Planbarkeit zentraler als maximale Flexibilität. Budgets für BI- und Datenplattformen werden meist jährlich freigegeben und müssen gegen andere Initiativen verteidigt werden. Ein Modell, das sich nur mit hohem Monitoring-Aufwand stabil steuern lässt, ist hier organisatorisch oft schwer zu verankern.
In vielen Fällen wären klare Plattformpreise mit definierten Leistungsumfängen einfacher zu vertreten: etwa ein Pauschalbetrag für Betrieb, Datenintegration und Reporting für eine definierte Anzahl Quellen und Nutzer. Genau an diesem Punkt kollidiert das Fabric-Kapazitätsmodell mit den Erwartungen des Mittelstands.
| Aspekt | Fabric (Kapazitätsmodell) | Klassisches Lizenzmodell |
|---|---|---|
| Preisbasis | Capacity Units pro F‑SKU, Verbrauch je Workload | Lizenzen pro Nutzer oder feste Plattformfee |
| Kostentransparenz | Abhängig von Monitoring und Governance | Vorab kalkulierbar, wenig laufende Steuerung |
| Steuerungsaufwand | Hoch: Kapazität, Jobs, KI-Verbrauch managen | Niedrig bis mittel: Fokus auf Nutzeranzahl |
| Eignung Mittelstand | Gut mit erfahrenem Data-Team | Gut bei knappen Ressourcen und klaren Budgets |
Skill-Anforderungen: Welche Rollen Microsoft Fabric im Alltag wirklich braucht
Datenmodellierung und DAX-Know-how: ohne sauberes Modell keine sauberen Zahlen
Auch in Fabric bleibt eine zentrale Wahrheit bestehen: Ohne durchdachtes Datenmodell sind Reports unzuverlässig. Das bedeutet, jemand muss Fakten, Dimensionen, Granularitäten und Historisierungskonzepte planen und dokumentieren – idealerweise mit Erfahrung in Data-Warehouse-Design.
Hinzu kommt DAX-Know-how für Power BI, denn viele Geschäftslogiken werden in Measures abgebildet. Fehlerhafte DAX-Formeln oder schlecht strukturierte Modelle führen direkt zu widersprüchlichen Kennzahlen – und genau dort verliert ein BI-System im Mittelstand am schnellsten seine Akzeptanz.
Row-Level Security, Governance und Performance-Tuning
In produktiven Szenarien müssen Zugriffe mit Row-Level Security sauber konzipiert und umgesetzt werden, damit jede Person nur die für sie relevanten Daten sieht. Das ist nicht nur eine Frage der Technik, sondern auch der Organisation und Compliance.
Zusätzlich braucht es kontinuierliches Performance-Tuning: Modellvereinfachung, Aggregationstabellen, Partitionierung und Optimierung von Refresh-Strategien. In einer Kapazitätsplattform wie Fabric werden diese Themen noch wichtiger, weil ineffiziente Modelle direkt Kapazität und damit Kosten treiben.
Data Engineers, Architects, BI-Entwickler: das Team hinter einer Fabric-Implementierung
Eine ernsthafte Fabric-Einführung erfordert typischerweise mehrere Rollen: Data Engineers für Pipelines und Integration, Data Architects für Modell- und Governance-Design, BI-Entwickler:innen für Dashboards und semantische Schichten sowie jemanden für Kapazitäts- und Kostensteuerung.
In Konzernen verteilen sich diese Aufgaben auf eigene Teams, oft über mehrere Bereiche hinweg. Im Mittelstand landen sie hingegen häufig auf wenigen Köpfen, die zusätzlich noch operative IT-Aufgaben stemmen – eine strukturelle Überlastung ist damit vorprogrammiert.
Warum genau diese Skills in mittelständischen IT-Teams meist fehlen
Laut Bitkom-Studie 2025 sind in Deutschland rund 109.000 IT-Stellen unbesetzt. Mittelständische Unternehmen konkurrieren hier direkt mit Konzernen und Tech-Unternehmen um dieselben Profile – mit deutlich geringerer Sichtbarkeit und oft weniger attraktiven Rahmenbedingungen.
In der Realität bedeutet das: Die Suche nach einem „Fabric-Team“ dauert lange, bleibt unvollständig oder führt zu externen Abhängigkeiten. Projekte verzögern sich, weil zentrale Entscheidungen nicht getroffen werden können, oder sie laufen nach der Einführung ins Leere, weil niemand den Betrieb verantwortet.
„Wir wollen das nachher selber können“: Lock-in-Risiko und Abhängigkeiten
Viele Mittelständler formulieren zurecht den Anspruch, ihre Datenplattform nach einer Einführungsphase eigenständig betreiben zu können. Eine hochspezialisierte Enterprise-Plattform erhöht jedoch die Abhängigkeit von wenigen Experten und von einzelnen Dienstleistern – gerade wenn internes Know-how schwer aufzubauen ist.
Das Lock-in-Risiko ist dabei zweifach: technologisch, weil die komplette Architektur auf einem bestimmten Ökosystem basiert, und organisatorisch, weil kritisches Wissen bei wenigen Köpfen liegt. Für Entscheider entsteht damit ein Spannungsfeld zwischen Innovationsdruck und dem Wunsch nach langfristiger Unabhängigkeit.
Überdimensionierung: Zu groß für Excel, zu klein für den Enterprise-Stack?
Wenn die Plattform mehr kann, als das Team je nutzen wird
Für viele mittelständische Unternehmen gilt: Sie haben fünf bis zehn zentrale Quellen, definierte Kernkennzahlen und klare Reporting-Anforderungen. Eine Plattform, die gleichzeitig Integration, Streaming, Data Science, Data Engineering und Self-Service-Governance auf Enterprise-Niveau abdecken will, bietet hier deutlich mehr Funktionen, als kurzfristig benötigt werden.
Bezahlt wird dennoch die gesamte Plattformbreite – sowohl in Form von Kapazitäten als auch in Form von Komplexität im Daily Business. Das ist vergleichbar mit einer hochmodernen Fertigungslinie, die gekauft wird, um zunächst nur ein einziges Standardteil darauf zu produzieren.
Typische Mittelstands-Szenarien: wenige Quellen, klare Kennzahlen – viel Plattform-Overhead
Ein typischer Use Case im Mittelstand: ERP, CRM und vielleicht ein Produktionssystem sollen für Controlling und Vertrieb zusammengeführt werden. Ziel ist ein konsistenter Kennzahlenkatalog, Monatsabschlüsse ohne Excel-Schleifen und einheitliche Sicht auf Kunden, Aufträge und Deckungsbeiträge.
Diese Anforderung lässt sich oft mit einem gut strukturierten Data Warehouse und sauber definierten Datenprozessen abbilden – ohne dass dafür die gesamte Breite einer Fabric- oder Databricks-Plattform benötigt wird. Der Overhead entsteht dann vor allem durch Aufbau, Betrieb und Lizenzmodell, nicht durch den eigentlichen fachlichen Bedarf.
Warum Fabric/Databricks-Projekte häufig bei Konzept und Governance stecken bleiben
In vielen Projekten wird früh mit der technischen Plattform gestartet, während konzeptionelle Grundlagen wie Datenstrategie, Governance-Modell und Verantwortlichkeiten nur grob skizziert sind. Gerade bei mächtigen Systemen wie Fabric oder Databricks führt das dazu, dass schnell viele Artefakte entstehen – ohne einheitliche Linie.
Spätestens wenn mehrere Fachbereiche parallel Self-Service nutzen, ohne zentrale Leitplanken, zeigt sich die Kehrseite: inkonsistente KPIs, redundante Datenmodelle, schwer nachvollziehbare Berechtigungen. Die Plattform kann das adressieren – aber nur, wenn Governance und Konzept von Anfang an mitgedacht und umgesetzt werden.
KI auf Treibsand: wenn die Datenbasis nicht stimmt
KI-Funktionen wie Copilot in Fabric sind nur so gut wie das Datenfundament, auf dem sie aufsetzen. Wenn Datenmodelle lückenhaft sind, Kennzahlen uneinheitlich definiert wurden oder Datenqualität nicht überwacht wird, erzeugen KI-Assistenten zwar beeindruckende Antworten, aber auf wackeliger Basis.
Für Entscheider ist das besonders riskant: Je besser das Interface, desto größer die Versuchung, Ergebnissen zu vertrauen, ohne das Fundament zu hinterfragen. Im Mittelstand, wo einzelne Fehlentscheidungen schnell spürbare wirtschaftliche Folgen haben, ist „KI auf Treibsand“ keine Option.
Fazit aus der Praxis: richtiges Werkzeug, falsche Unternehmensgröße
Zusammengefasst ist Microsoft Fabric technisch eine starke Plattform – für Organisationen, die eine Vielzahl an Daten- und Analytics-Workloads konsolidieren wollen und die entsprechenden Teams dafür haben. Für viele mittelständische Unternehmen entsteht jedoch ein Mismatch aus Plattformbreite, Lizenzlogik und verfügbarem Skillset.
Die zentrale Erkenntnis lautet deshalb: Du kannst mit Fabric viel erreichen, aber Du musst dafür auch viel betreiben. Wenn Deine Priorität auf schnellen, verlässlichen Ergebnissen mit begrenzten Ressourcen liegt, solltest Du prüfen, ob eine fokussiertere, stärker gemanagte Plattform besser zu Deiner Realität passt.
Was braucht der Mittelstand wirklich von einer Datenplattform?
Eine Quelle der Wahrheit statt Reporting-Wildwuchs
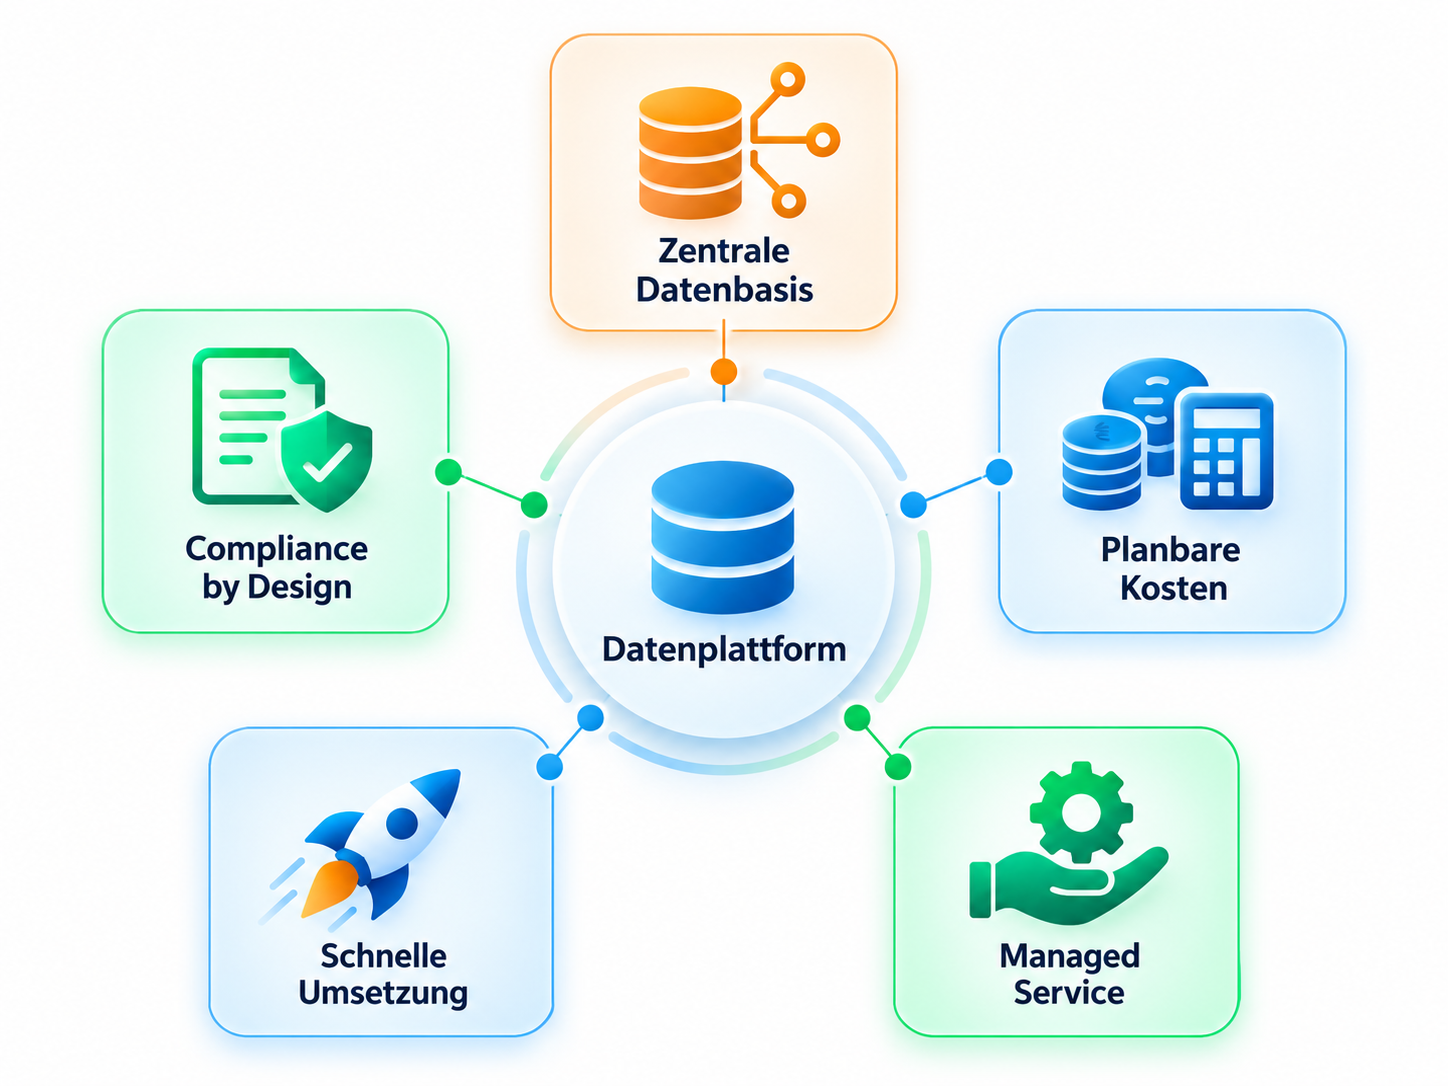
Unabhängig von der gewählten Technologie ist das wichtigste Ziel im Mittelstand eine zentrale, verlässliche Datenbasis. Alle relevanten Zahlen – von Umsatz und Deckungsbeitrag bis hin zu OEE (Gesamtanlageneffektivität / Overall Equipment Effectiveness) und Ausschuss – sollten aus einem harmonisierten Modell kommen, das von allen Bereichen akzeptiert wird.
Das bedeutet: ein zentrales Data Warehouse mit klaren Definitionen, historisierter Sicht und sauberer Trennung von Roh- und Auswertungsdaten. Erst wenn diese Grundlage steht, lohnen sich Self-Service-Analysen, KI-Modelle oder Echtzeit-Dashboards wirklich.
Klarheit bei Kosten, Lizenzen und Betrieb – ohne F-SKU-Rätsel
Für Entscheider ist es entscheidend zu wissen, was die Plattform pro Monat kostet und welche Leistungen damit abgedeckt sind. Ein klares Preismodell mit definierten Stufen und transparenten Compute-Kosten ist hier deutlich hilfreicher als eine reine Kapazitätslogik mit vielen Stellschrauben.
Das gilt auch für den Betrieb: Wer kümmert sich um Pipelines, Monitoring, Datenqualität und Backups? Eine Lösung, die Betrieb und Weiterentwicklung als Managed Service mitliefert, reduziert Risiken und entlastet knappe IT-Teams spürbar.
Weniger Tool-Baukasten, mehr fertige Lösung mit Managed Service
Statt eine Vielzahl einzelner Services zu orchestrieren, suchen viele Mittelständler eine Plattform, die zentrale Bausteine – Integration, Modellierung, Reporting, KI – in einem klar strukturierten Rahmen bereitstellt. Idealerweise mit vordefinierten Best Practices für typische Use Cases in Finance, Vertrieb und Produktion.
Entscheidender Vorteil einer solchen Lösung ist, dass Fachbereiche sich auf Inhalte und Fragen konzentrieren können, während das zugrunde liegende technische Setup stabil betrieben wird. Das reduziert die Abhängigkeit von einzelnen internen „Key Usern“, die nebenbei die Plattform zusammenhalten müssen.
Realistische Time-to-Value: von Excel-Reports zu verlässlichen Dashboards in Wochen
Mittelständische Unternehmen können es sich selten leisten, sechs bis neun Monate auf die ersten produktiven Ergebnisse zu warten. Ein realistischer Anspruch ist: erste integrierte Dashboards innerhalb weniger Wochen, vollständige Umsetzung eines Kern-Use-Cases in zwei bis drei Monaten.
Dafür braucht es Standards in der technischen Umsetzung und einen klaren Projektansatz: priorisierte Use Cases, definierte Datenquellen, schnelles Prototyping und frühes Feedback aus den Fachbereichen. Je mehr eine Plattform das methodisch unterstützt, desto geringer ist das Projektrisiko.
Compliance by Design: DSGVO, EU AI Act und Datenhoheit
Spätestens mit dem EU AI Act und zunehmenden Datenschutzanforderungen kann Compliance nicht mehr nachträglich „aufgesetzt“ werden. Datenplattformen müssen von Anfang an Rollen, Zugriffsmodelle, Protokollierung, Datenklassifikation und Modellnachvollziehbarkeit unterstützen.
Für viele Unternehmen spielt zudem der Standort eine Rolle: Sie bevorzugen Anbieter aus dem eigenen Rechtsraum, mit Hosting in der EU und klar geregelter Datenhoheit. Laut Bitkom-Studie 2025 bevorzugen 93 % der Unternehmen in Deutschland einen deutschen KI-Anbieter – ein deutliches Signal für das Bedürfnis nach rechtlicher und kultureller Nähe.
Von BI und KI zu CI: Warum Contextual Intelligence der nächste Schritt ist
BI, AI, CI: Begriffe klären – was ist was?
Business Intelligence (BI) beantwortet die Frage „Was ist passiert?“ – anhand historischer Daten, Reports und Dashboards. Künstliche Intelligenz (AI) erweitert diesen Blick um Prognosen und Mustererkennung, also „Wie wird es voraussichtlich weitergehen?“.
Contextual Intelligence (CI) geht einen Schritt weiter: Sie verbindet Kennzahlen und KI-Ergebnisse mit Deinem konkreten Geschäftskontext und erklärt „Warum passiert das – und was solltest Du als Nächstes tun?“. Genau diese Brücke fehlt in vielen klassischen BI- oder KI-Setups.
| Ansatz | Kernfrage | Typisches Ergebnis |
|---|---|---|
| BI | Was ist passiert? | Report, Dashboard, KPI-Verlauf |
| AI | Wie wird es weitergehen? | Prognose, Score, Anomalie-Alarm |
| CI | Warum passiert das – und was tun? | Ursachenanalyse, Handlungsempfehlung im Kontext |
BI zeigt, was passiert – AI, wie es weitergeht – CI erklärt, warum und was zu tun ist
Im Alltag reicht es Führungskräften selten, nur den Ist-Zustand zu sehen oder eine Prognose zu erhalten. Sie müssen verstehen, warum Kennzahlen sich verändern und welche Stellhebel sie konkret beeinflussen können – etwa bei Lieferengpässen, Margenrückgängen oder steigenden Ausschussraten.
CI-Systeme verknüpfen dazu Daten aus verschiedenen Bereichen, machen Regeln, Abhängigkeiten und Annahmen explizit und stellen diese in verständlicher Form bereit. Statt nur einen Churn-Score zu sehen, bekommst Du beispielsweise eine Erklärung, welche Faktoren diesen Score treiben und welche Kundengruppe mit welcher Maßnahme angesprochen werden sollte.
Warum reine Visualisierung nicht mehr reicht
Viele BI-Projekte enden in einem „Dashboard-Zoo“: Es gibt zahlreiche Visualisierungen, aber wenig Guidance, welche Erkenntnisse wirklich handlungsrelevant sind. Fachbereiche verbringen dann viel Zeit damit, die Daten zu interpretieren und mit ihrem Erfahrungswissen zu verknüpfen.
Je komplexer Märkte und Lieferketten werden, desto wichtiger ist es, dass Systeme diese Kontextarbeit unterstützen. Die Plattform muss nicht nur Zahlen anzeigen, sondern helfen, Zusammenhänge zu verstehen und Prioritäten zu setzen – etwa, welche Maßnahmen zuerst ergriffen werden sollten, um ein Ziel zu erreichen.
Wie der Geschäftskontext in die Daten- und KI-Ebene kommt
Technisch entsteht Contextual Intelligence, indem fachliche Regeln, Kennzahlendefinitionen, Prozesswissen und Governance direkt im Datenmodell verankert werden. Dazu gehören zum Beispiel definierte Ursachenbaumstrukturen, Regelwerke für Alerts oder Zuordnungen zwischen Prozessschritten und KPIs.
KI-Modelle arbeiten dann nicht mehr nur auf „rohen“ Daten, sondern innerhalb dieses expliziten Kontextes. Sie können etwa nicht nur Anomalien melden, sondern auch darauf hinweisen, welche Prozessabweichung am wahrscheinlichsten dahintersteckt und welche Maßnahmen in der Vergangenheit erfolgreich waren.
Vertiefung: AI vs. BI vs. CI im Detail
Wenn Du tiefer in den Vergleich zwischen BI, KI und CI einsteigen möchtest, lohnt sich ein Blick auf unsere Übersichtsseite „AI vs. BI vs. CI“. Dort zeigen wir im Detail, wie sich die Ansätze ergänzen, wo ihre Grenzen liegen und wie Du sie sinnvoll kombinierst.
Wichtig ist: CI ist keine komplett neue Technologie, sondern eine andere Art, BI und KI aufzubauen – mit dem Fokus auf Kontext und Handlungsrelevanz. Genau hier setzt bimanu One als Plattform an.
bimanu One als Alternative zu Microsoft Fabric für den Mittelstand
Überblick: Was ist bimanu One und für wen ist die Plattform gedacht?
bimanu One ist eine Contextual-Intelligence-Plattform, die explizit für den deutschen Mittelstand entwickelt wurde. Im Kern kombiniert sie ein vollständig gemanagtes Data Warehouse, automatisierte Datenprozesse, integrierte KI-Module und einen Kontext-Layer, der Ursachen und Handlungsempfehlungen sichtbar macht.
Die Plattform richtet sich an Unternehmen, die eine zentrale Datenbasis für Finance, Vertrieb, Produktion und Management aufbauen wollen – ohne ein eigenes Data-Engineer-Team aufbauen zu müssen. Statt eines Tool-Baukastens erhältst Du eine schlüsselfertige Lösung mit Betrieb, Governance und Enablement.
Drei Ausbaustufen: Foundation, Intelligence, Context
bimanu One ist in drei Stufen aufgebaut, die aufeinander aufbauen. Foundation liefert das zentrale Data Warehouse, harmonisierte Kennzahlen und den laufenden Betrieb als Managed Service. Intelligence ergänzt darauf aufbauend Machine-Learning-Module für Prognosen und Anomalie-Erkennung.
In der Stufe Context kommt schließlich der Contextual-Intelligence-Layer hinzu: Ursachenanalyse, natürliche Sprache zur Interaktion mit Daten und konkrete Handlungsempfehlungen. So kannst Du genau dort einsteigen, wo Dein Unternehmen heute steht, und die Plattform später schrittweise erweitern.
| Stufe | Schwerpunkt | Typische Ergebnisse |
|---|---|---|
| Foundation (ab ca. 6.000 €/Monat) |
Zentrales Data Warehouse, Kennzahlenkatalog, Managed Betrieb | „Eine Wahrheit“ für KPIs, automatisierte Reports, stabile BI-Basis |
| Intelligence (ab ca. 11.000 €/Monat) |
ML-Module für Anomalien, Forecasting, Predictive Analytics | Früherkennung von Abweichungen, belastbare Prognosen |
| Context (auf Anfrage) |
Contextual Layer mit Ursachenanalyse und Handlungsempfehlungen | Datengestützte Entscheidungen mit klaren „Next Best Actions“ |
Cloud ja, Komplexität nein: Snowflake unter der Haube
Technisch setzt bimanu One auf Snowflake als skalierbare Cloud-Datenplattform – allerdings vollständig gemanagt und in der Bedienung abstrahiert. Das heißt: Du profitierst von Performance, Skalierbarkeit und Sicherheit eines marktführenden Systems, ohne Dich mit dessen Komplexität beschäftigen zu müssen.
Die Daten bleiben dabei in Deinem eigenen Snowflake-Konto, was die Datenhoheit sichert und Lock-in-Risiken reduziert. Gleichzeitig stellt bimanu standardisierte Datenmodelle, Low-Code-Oberflächen und Monitoring bereit, sodass Fachbereiche ohne tiefes SQL- oder DAX-Wissen mit der Plattform arbeiten können.
Time-to-Value: Insights ab Woche 5 statt monatelanger Projekte
Durch vorgefertigte Konnektoren, Standard-Modelle und einen klaren Projektansatz liefert bimanu One typischerweise erste produktive Dashboards innerhalb von fünf Wochen. Ein vollständiger Kern-Use-Case – etwa Monatsreporting oder OEE-Controlling – wird in sechs bis acht Wochen umgesetzt.
Dieser Zeitrahmen ist möglich, weil der Aufbau des technischen Fundaments nicht bei Null beginnt, sondern auf erprobten Bausteinen basiert. Das reduziert Architekturdiskussionen, verkürzt Implementierungszeiten und ermöglicht es, früh mit echten Daten zu arbeiten, statt sich in Konzepten zu verlieren.
Beispiele aus der Praxis: Vom Excel-Reporting zum zentralen Data Warehouse
Ein typisches Startprojekt ist der Ersatz manueller Monatsreports aus drei Quellen – etwa ERP, CRM und einem Produktionssystem. Bisher werden dafür Daten per Export zusammengeführt, in Excel aufbereitet und in PowerPoint präsentiert, mit allen bekannten Risiken.
Mit bimanu One werden diese Systeme über fertige Konnektoren angebunden, das Datenmodell harmonisiert und ein zentraler Kennzahlenkatalog aufgebaut. Ab diesem Punkt laufen Daten täglich oder in kürzeren Intervallen in das Warehouse, Dashboards aktualisieren sich automatisch – und alle Beteiligten sehen dieselben Zahlen.
Fabric-Schmerzpunkte systematisch gelöst: Fabric vs. bimanu One im Direktvergleich
Lizenz- und Kostenmodell: F-SKUs vs. klare Preistiers
Während Fabric auf Kapazitäts-SKUs und ein Consumption-Modell setzt, arbeitet bimanu One mit klar definierten Plattformstufen zu festen monatlichen Gebühren. Compute-Kosten sind getrennt sichtbar, aber durch standardisierte Workloads gut planbar.
Das erleichtert Budgetplanung und interne Abstimmung deutlich: Statt eine abstrakte Kapazität zu rechtfertigen, kannst Du konkrete Leistungsversprechen pro Stufe kommunizieren – inklusive Time-to-Value und Funktionsumfang.
Skill-Lücke: Eigenbau-Team vs. Managed Service und Low-Code
Fabric setzt ein internes oder externes Team aus Data Engineers, BI-Entwicklern und Governance-Verantwortlichen voraus. Bei bimanu One werden diese Rollen zum großen Teil vom Anbieter gestellt, der Aufbau, Betrieb und Weiterentwicklung als Managed Service übernimmt.
Zusätzlich stehen Low-Code-Oberflächen zur Verfügung, über die Fachbereiche fachliche Regeln, Mappings und Kennzahlen selbst pflegen können. Das reduziert die Abhängigkeit von knappen Spezialprofilen und sorgt dafür, dass das relevante Prozesswissen dort gepflegt wird, wo es entsteht.
Integration: Connectoren, Anbindungsaufwand und typische Mittelstands-Systeme
bimanu One bringt über 100 vorgefertigte Konnektoren für gängige ERP-, CRM-, IoT- und Datenbanksysteme mit. Fehlende Konnektoren werden ohne Aufpreis ergänzt, sodass der Anbindungsaufwand für typische Mittelstands-Landschaften gering bleibt.
Damit entfällt ein wesentlicher Teil des Projektaufwands, der bei generischen Plattformen häufig anfällt: das individuelle Aufsetzen von Pipelines, das Bauen von Mapping-Logiken und das wiederholte Lösen immer gleicher Integrationsprobleme.
KI-Einsatz: generische Modelle vs. kontextreiche, EU-AI-Act-konforme Intelligenz
Fabric bietet mit Copilot und weiteren Funktionen einen generischen KI-Baukasten, der stark auf Produktivität und Exploration zielt. bimanu One konzentriert sich auf konkrete, kontextreiche KI-Anwendungsfälle im Mittelstand – etwa Anomalie-Erkennung in Fertigungsdaten oder Forecasting in Absatz- und Finanzdaten.
Alle KI-Module werden EU-AI-Act-konform betrieben, mit dokumentierten Datenquellen, nachvollziehbaren Modellen und klaren Zugriffsregeln. Das reduziert regulatorische Risiken und erleichtert Audits oder interne Freigabeprozesse erheblich.
Lock-in und Datenhoheit: Plattform-Abhängigkeit vs. eigenes Snowflake-Konto
In Fabric liegen Daten, Modelle und Workloads vollständig in Microsofts Cloud-Ökosystem. Bei bimanu One hingegen verbleiben Daten in Deinem eigenen Snowflake-Konto, das unabhängig von der Plattform existiert und Dir langfristige Souveränität bietet.
Sollte sich Deine Strategie zukünftig verändern, kannst Du auf diese Datenbasis weiterhin zugreifen. Gleichzeitig minimiert der Ansatz das Risiko, dass ein Plattformwechsel gleichbedeutend mit einem kompletten Neuaufbau der Datenbasis wäre.
Compliance und Standort: Globaler Hyperscaler vs. Made in Germany
Microsoft Fabric wird global aus Hyperscaler-Rechenzentren bereitgestellt, mit umfangreichen Compliance-Zertifizierungen. Dennoch bleibt für viele Unternehmen die Frage, wie Datenflüsse, Rechtsraum und Supportkontext konkret aussehen.
bimanu One setzt auf „Made in Germany“: Hosting in der EU, ISO-27001-Standards, DSGVO-konformes Setup und eine Plattform, die den EU AI Act von Anfang an mitdenkt. Support, Dokumentation und Beratung erfolgen in deutscher Sprache – ein unterschätzter Faktor in kritischen Projektsituationen.
Komplettvergleich in der Übersicht
| Kriterium | Microsoft Fabric | bimanu One |
|---|---|---|
| Primäre Zielgruppe | Enterprise, Konzern, komplexe Analytics-Landschaften | Deutschsprachiger Mittelstand mit hohem Reporting- und KI-Bedarf |
| Kostenmodell | F‑SKUs, CUs, zusätzl. Lizenzen; Verbrauchssteuerung nötig | Klare Stufen (Foundation, Intelligence, Context) mit festen Monatsgebühren |
| Betrieb | Eigenverantwortlich oder mit Partner; hoher Rollenbedarf | Voll gemanagter Betrieb inkl. Monitoring, Wartung, Qualitätssicherung |
| Datenbasis | OneLake in Microsoft-Cloud | Eigenes Snowflake-Konto, Datenhoheit beim Kunden |
| KI-Fokus | Generische Copilot-Funktionen, breites Spektrum | Gezielte ML-Module + Context-Layer, EU-AI-Act-konform |
| Time-to-Value | Abhängig von internem Team und Setup | Erste produktive Insights ab Woche 5, Use Case in 6–8 Wochen |
| Compliance & Standort | Globaler Hyperscaler, EU-Hosting möglich | Made in Germany, DSGVO, ISO 27001, EU AI Act mitgedacht |
bimanu One im Detail: Foundation, Intelligence, Context
Foundation: Data Warehouse, Kennzahlen-Katalog und Betrieb ab Tag 1
In der Foundation-Stufe richtet bimanu One ein zentrales Data Warehouse ein, das alle relevanten Quellen automatisiert integriert. Parallel entsteht ein harmonisierter Kennzahlenkatalog: Begriffe wie Umsatz, Deckungsbeitrag oder OEE werden einmalig definiert und dann unternehmensweit einheitlich verwendet.
Betrieb, Monitoring, Backups und Qualitätssicherung werden von bimanu übernommen. Du erhältst ein stabiles Fundament, auf dem Du Reports und Analysen aufbauen kannst – ohne eigene ETL-Strecken oder Datenmodelle entwickeln und warten zu müssen.
Intelligence: Anomalie-Erkennung, Forecasting und Predictive Analytics
Aufbauend auf dieser Basis fügt die Intelligence-Stufe Machine-Learning-Module hinzu. Typische Anwendungsfälle sind Nachfrageprognosen, Churn- und Risiko-Scoring oder Anomalie-Erkennung in Produktions- und Prozessdaten.
Alle Modelle sind so eingebunden, dass Fachbereiche die Ergebnisse in ihrer gewohnten BI-Umgebung sehen – etwa als zusätzliche Spalte, Score oder Alert – und nicht mit Rohmodell-Output arbeiten müssen. Training, Überwachung und Anpassung der Modelle übernimmt das bimanu-Team.
Context: Ursachenanalyse, natürliche Sprache, Handlungsempfehlungen
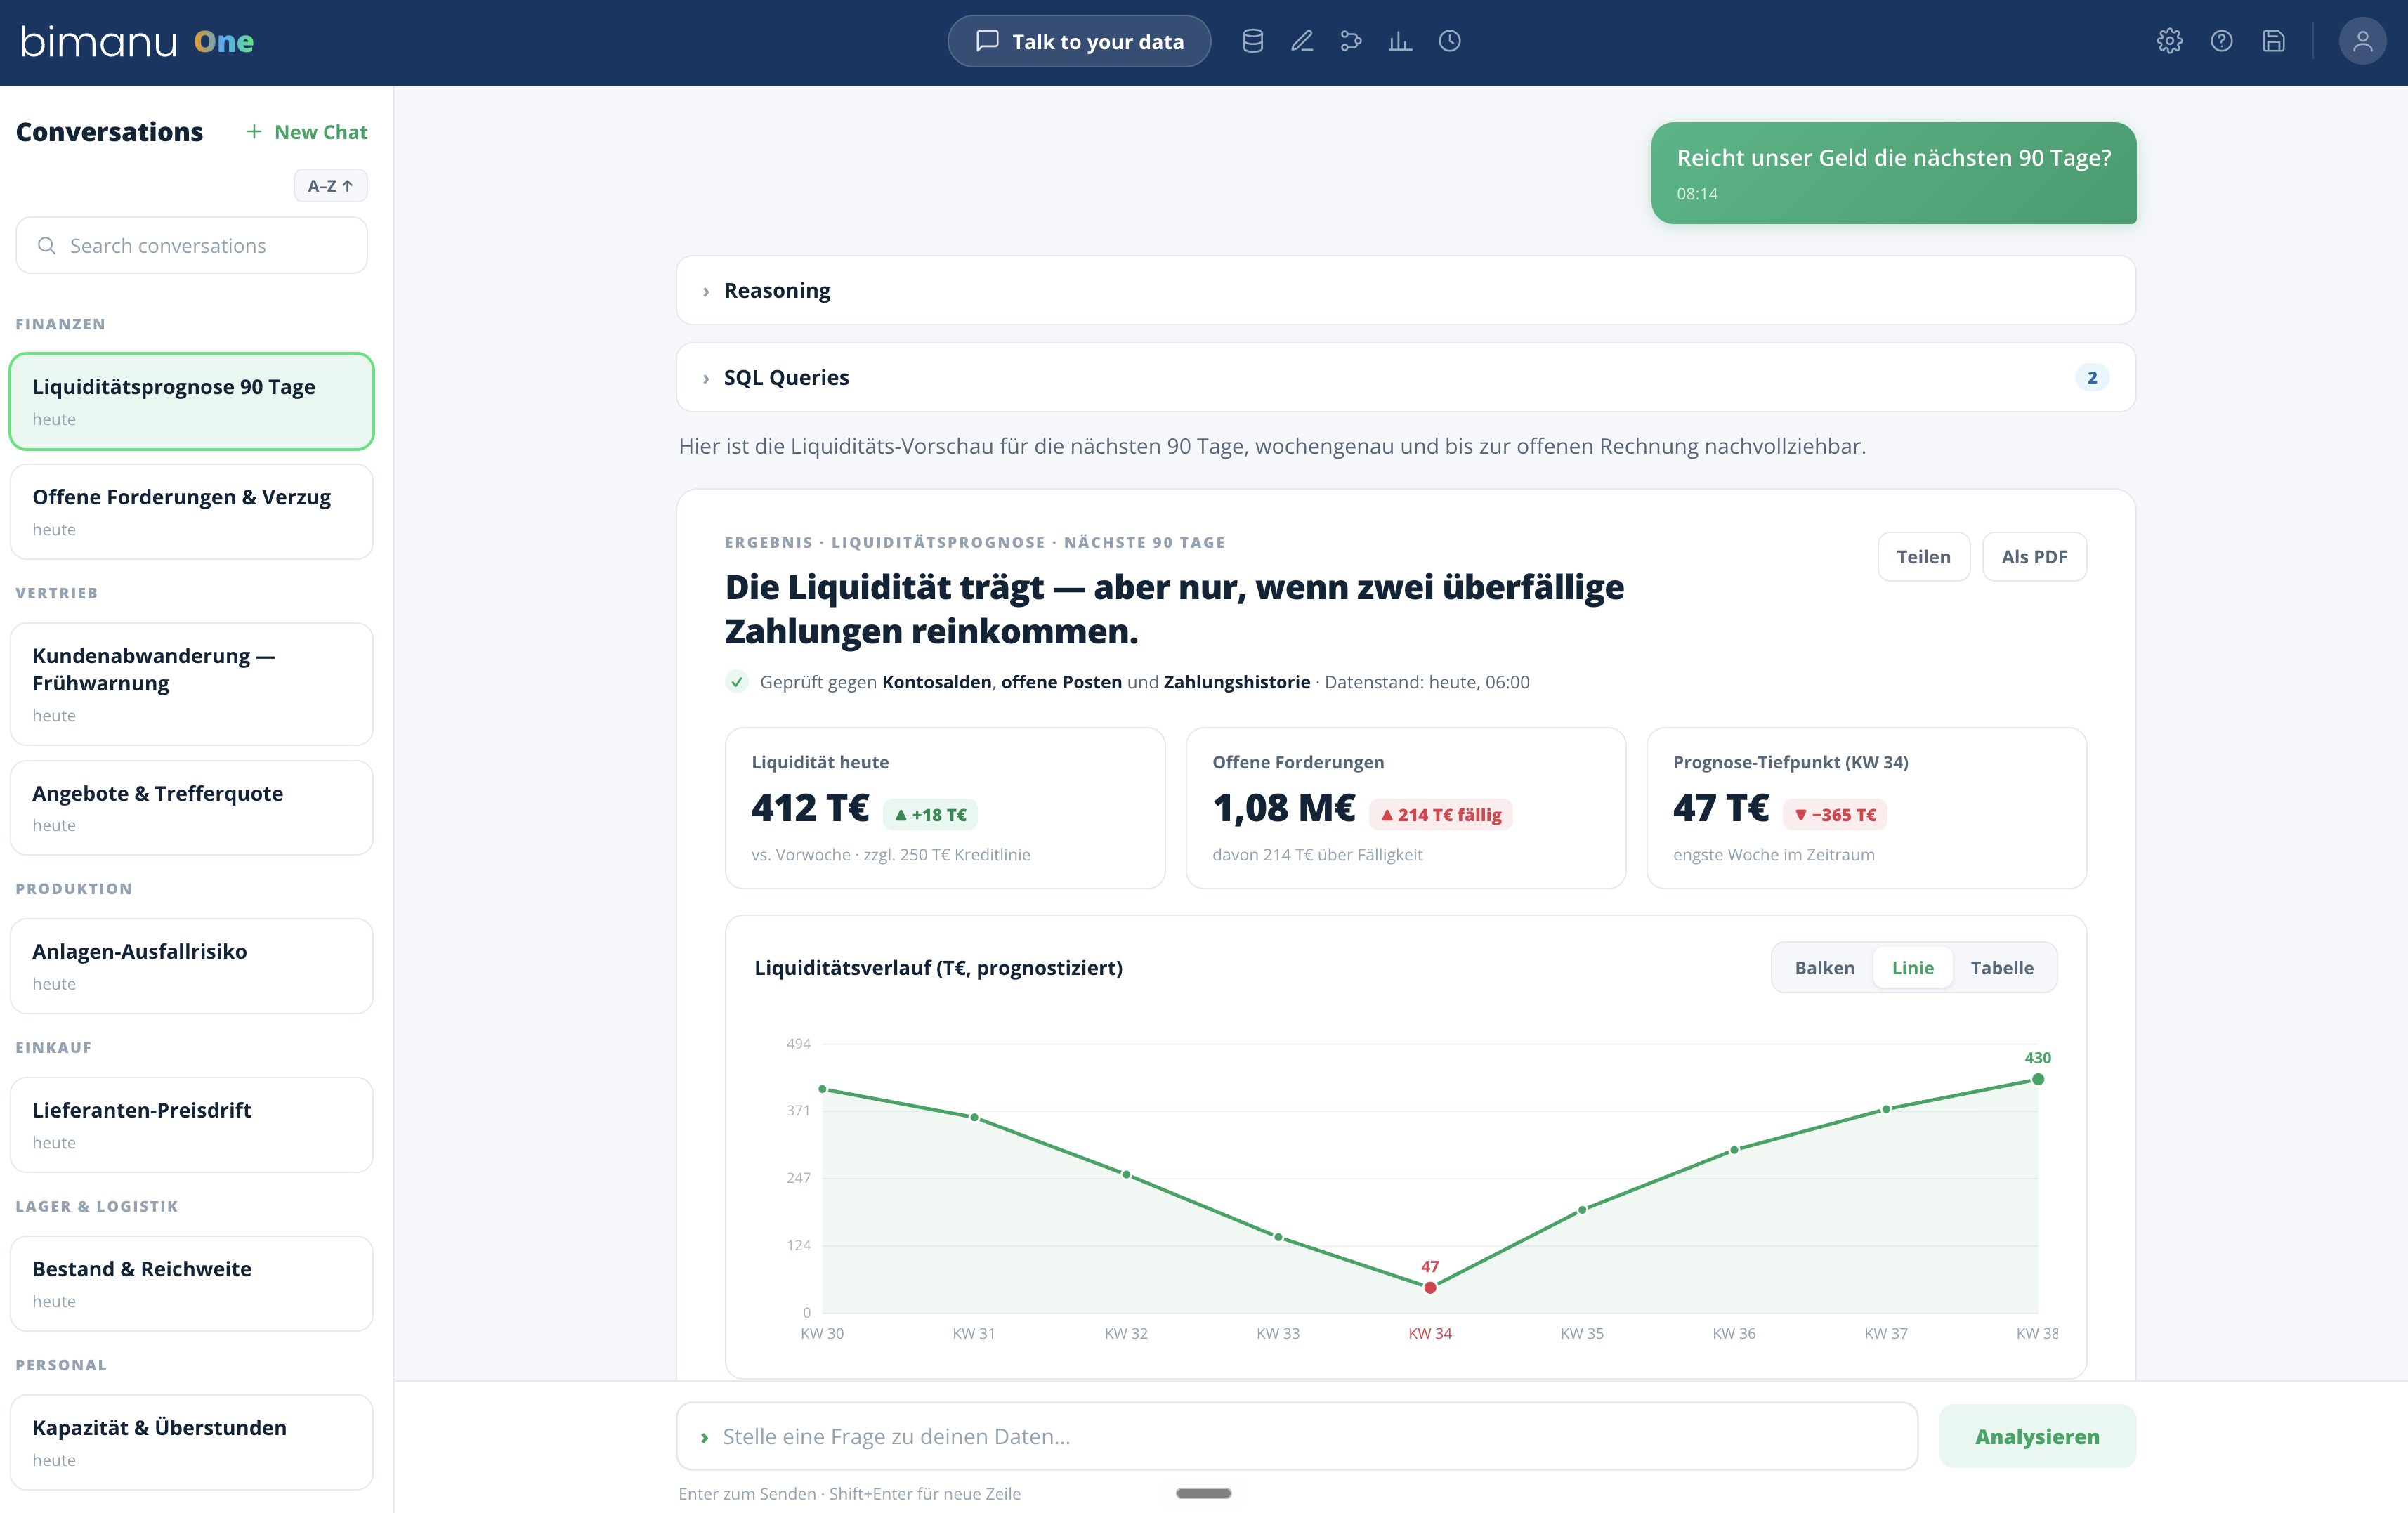
In der Context-Stufe wird der Contextual-Intelligence-Layer aktiviert. Hier werden Zusammenhänge zwischen KPIs, Ursachen und Maßnahmen systematisch erfasst und mit Daten belegt. Das System kann auf natürliche Sprache reagieren und Fragen wie „Warum ist der Deckungsbeitrag in Linie 3 eingebrochen?“ beantworten.
Zusätzlich generiert die Plattform Handlungsempfehlungen, etwa Prioritätenlisten für Maßnahmen oder „Next Best Actions“ im Vertrieb. Damit wird CI vom theoretischen Konzept zum täglichen Entscheidungswerkzeug – ohne, dass Du eigene KI-Teams aufbauen musst.
bimanu Academy: Enablement, Wissenstransfer und Autonomie
Ein zentraler Bestandteil von bimanu One ist die bimanu Academy. Sie vermittelt Deinem Team das Know-how, um die Plattform souverän zu nutzen: von Grundkursen zur Datenmodell-Logik bis hin zu Schulungen für Fachbereiche, die eigene Auswertungen erstellen wollen.
Ziel ist es, dass Du nicht in einer dauerhaften Abhängigkeit vom Anbieter bleibst, sondern intern Kompetenz aufbaust. So kannst Du eigene Use Cases entwickeln, Regeln anpassen und Berichte erweitern – ohne für jede Änderung ein Projekt starten zu müssen.
Transparente Preisgestaltung: Plattform-Fee und Compute-Kosten im Blick
bimanu One trennt klar zwischen Plattform-Fee und Compute-Kosten. Die Stufen Foundation, Intelligence und Context haben definierte monatliche Gebühren, die den Plattformbetrieb, Weiterentwicklung und Support abdecken. Compute-Kosten werden separat und transparent ausgewiesen.
Dieses Modell ermöglicht es Dir, sowohl Investitions- als auch Betriebskosten verlässlich zu planen. Änderungen, etwa durch neue Use Cases oder größere Datenmengen, werden sichtbar und nachvollziehbar – ohne Überraschungen durch intransparente Kapazitätsverbräuche.
Implementierung im Mittelstand: Vom Kick-off zu produktiven Insights in wenigen Wochen
Data Success Sprint: strukturierter Projektansatz statt offenem BI-Vorhaben
Statt eines offenen BI-Projekts arbeitet bimanu One mit einem klar definierten Data Success Sprint. In diesem Rahmen werden Ziele, Datenquellen, KPIs und Verantwortlichkeiten zu Beginn gemeinsam definiert und in einen konkreten Projektplan überführt.
Der Sprint hat eine feste Laufzeit und einen klaren Output: ein produktiver Use Case mit angebundenen Quellen, dokumentiertem Datenmodell und akzeptierten Dashboards. Das schafft Verbindlichkeit und verhindert, dass sich das Vorhaben in Konzeptpapieren verliert.
Typischer Projektablauf: von Quellensichtung bis Go-Live
Ein typischer Ablauf umfasst fünf Phasen: Analyse der Quellsysteme, Entwurf des Datenmodells, technische Anbindung und Modellierung, Aufbau der Dashboards sowie Test und Go-Live. Jede Phase hat klar definierte Ergebnisse und Review-Punkte mit den Fachbereichen.
Während bimanu die technische Umsetzung übernimmt, bringen Deine Teams das fachliche Wissen ein. So entsteht ein Modell, das sowohl technisch sauber als auch fachlich präzise ist – eine Kombination, die in klassischen Projekten oft zu kurz kommt.
Governance und Dokumentation: Datenmodell, Kennzahlen, Verantwortlichkeiten
Parallel zum Aufbau des Modells werden Governance-Elemente etabliert: Wer ist Owner für welche Kennzahl? Welche Datenquelle gilt als führend? Wie werden Änderungen versioniert und kommuniziert? Diese Fragen werden strukturiert beantwortet und dokumentiert.
Die Dokumentation ist integraler Bestandteil des Systems und nicht nur ein separates Wiki. So können neue Mitarbeitende verstehen, wie Kennzahlen definiert sind, und Audit-Anforderungen lassen sich einfacher erfüllen.
Multi-Mandanten-Szenarien: Konzernstrukturen im Mittelstand abbilden
Viele Mittelständler wachsen durch Akquisitionen oder betreiben mehrere Gesellschaften. bimanu One unterstützt Multi-Mandanten-Architekturen, in denen Du sowohl eine konsolidierte Sicht als auch gesellschafts- oder werksspezifische Analysen fahren kannst.
Berechtigungen und Mandantentrennung sind dabei systemseitig geregelt, sodass jede Einheit nur ihre eigenen Detaildaten sieht, während das Management auf einer konsolidierten Sicht arbeitet. Das reduziert manuellen Konsolidierungsaufwand und Fehlerquellen.
Wie Fachbereiche und IT sinnvoll zusammenarbeiten
Ein wesentlicher Erfolgsfaktor ist die Zusammenarbeit zwischen IT und Fachbereichen. In bimanu-Projekten definiert die IT in der Regel Rahmenbedingungen, Sicherheit und Quellsystemzugänge, während Fachbereiche fachliche Anforderungen und Kennzahlendefinitionen liefern.
Durch Low-Code-Elemente können Fachbereiche später selbst Anpassungen vornehmen, ohne in technische Details der Plattform einsteigen zu müssen. Die IT bleibt entlastet und behält gleichzeitig die Kontrolle über zentrale Aspekte wie Sicherheit und Datenfluss.
Compliance & Vertrauen: Warum „Made in Germany“ bei KI und Datenplattform zählt
DSGVO, ISO 27001 und EU AI Act: was Mittelständler beachten müssen
Mit wachsender Datennutzung steigen auch die regulatorischen Anforderungen. Die DSGVO verlangt klare Regeln für Datenverarbeitung, Aufbewahrung und Zugriff, ISO-27001-Standards definieren Anforderungen an Informationssicherheit und der EU AI Act legt zusätzliche Pflichten für KI-Systeme fest.
Unternehmen müssen belegen können, wo Daten liegen, wer Zugriff hat und wie Modelle trainiert wurden. Ad-hoc-Lösungen oder unstrukturierte KI-Experimente lassen sich in diesem Rahmen kaum verantworten – insbesondere nicht in regulierten Branchen oder bei sensiblen Geschäftsbereichen.
Bitkom-Studie 2025: 93 % der deutschen Unternehmen bevorzugen deutsche KI-Anbieter
Eine aktuelle Bitkom-Studie zeigt, dass 93 % der befragten Unternehmen in Deutschland einen deutschen KI-Anbieter bevorzugen. Die Gründe sind klar: Vertrauen in den Rechtsraum, Nähe des Supports, Sprach- und Kulturkompatibilität sowie größere Transparenz in Fragen der Datenverarbeitung.
Diese Präferenz ist kein reines „Bauchgefühl“, sondern eine Reaktion auf die wachsende Komplexität regulatorischer Anforderungen. Wer sich bei Infrastruktur- und KI-Partnern für Lösungen aus dem eigenen Rechtsraum entscheidet, reduziert Abstimmungs- und Prüfaufwand spürbar.
Datenhoheit und Souveränität: wer hat Zugriff, wer entscheidet?
Ein Kernaspekt von Vertrauen ist Datenhoheit: Wer kann technisch auf Daten zugreifen, wer ist vertraglich verantwortlich und wie leicht lässt sich der Anbieter wechseln? Cloud-Lösungen sind hier nicht per se problematisch – entscheidend ist die Architektur.
Das Modell von bimanu One – eigenes Snowflake-Konto, klare Auftragsverarbeitungsverträge, Hosting in der EU – ist darauf ausgelegt, Dir langfristige Souveränität zu sichern. Gleichzeitig bleibt die Plattform in der Lage, moderne KI- und Analytics-Funktionen bereitzustellen.
Wie bimanu One Compliance-Anforderungen technisch abbildet
Technisch unterstützt bimanu One Rollen- und Rechtekonzepte, Audit-Logs, Versionierung von Modellen und Konfigurationen sowie Datenklassifikation. Alle KI-Module werden mit nachvollziehbaren Trainings- und Einsatzdaten betrieben und können bei Bedarf auditiert werden.
Zusätzlich werden Backup- und Wiederherstellungsprozesse regelmäßig getestet, um auch im Störungsfall Datensicherheit zu gewährleisten. So entsteht ein Setup, das nicht nur „formal compliant“, sondern auch im Alltag robust ist.
Vertrauen durch Nähe: Support, Sprache, Rechtsraum
Neben technischen und rechtlichen Aspekten spielt die Zusammenarbeit eine wichtige Rolle. bimanu One wird von einem deutschsprachigen Team betreut, Support und Beratung erfolgen in derselben Sprache und Zeitzone – ohne zwischengeschaltete internationale Ticketschichten.
Das erleichtert nicht nur die Abstimmung in Projekten, sondern schafft auch im laufenden Betrieb Vertrauen. Gerade wenn es um kritische Finanz- oder Produktionsdaten geht, ist dieser Faktor nicht zu unterschätzen.
Entscheidung treffen: Wann Fabric sinnvoll ist – und wann bimanu One besser passt
Checkliste: Typische Signale für eine Enterprise-Plattform wie Fabric
Eine Plattform wie Microsoft Fabric spielt ihre Stärken aus, wenn Du eine Vielzahl verteilter Daten- und Analytics-Systeme konsolidieren willst und bereits heute dedizierte Teams für Data Engineering, Governance und BI-Betrieb hast. Auch große, internationale Nutzerzahlen und komplexe Compliance-Landschaften sprechen für einen Enterprise-Ansatz.
Wenn Du mehrere Azure-Services, Data Lakes und BI-Werkzeuge parallel betreibst und das Zielbild eine einheitliche Analytics-Plattform im Microsoft-Ökosystem ist, ist Fabric eine naheliegende Option – vorausgesetzt, Budget und Ressourcen sind langfristig gesichert.
Checkliste: Typische Signale, dass eine CI-Plattform wie bimanu One die bessere Wahl ist
Wenn Deine Ausgangslage eher so aussieht: wenige, aber wichtige Quellsysteme; knappe IT-Ressourcen; hoher Druck auf verlässliches Reporting und erste KI-Anwendungen – dann spricht vieles für eine fokussierte, gemanagte Plattform. Besonders, wenn Du planbare Kosten und schnelle Ergebnisse benötigst.
Auch der Wunsch, langfristig unabhängig zu bleiben und internes Know-how aufzubauen, passt zur Logik von bimanu One und der bimanu Academy. Statt eine große Plattform zu verwalten, nutzt Du eine spezialisierte Lösung, die auf die Realität des Mittelstands zugeschnitten ist.
Risikoabwägung: Budget, Ressourcen, Verantwortung für Datenqualität
Am Ende ist die Plattformentscheidung immer auch eine Risikoabwägung. Mit einer Enterprise-Plattform gehst Du in Vorleistung: hohe Flexibilität, aber auch hoher Steuerungsaufwand und die Notwendigkeit, passende Teams aufzubauen. Der Nutzen kommt, wenn Du diese Komplexität aktiv managst.
Mit einer CI-Plattform wie bimanu One verteilst Du Risiken anders: Du nutzt Standards, Managed Service und klare Tiers, um schneller zu Ergebnissen zu kommen. Im Gegenzug verzichtest Du bewusst auf Funktionen, die Du in den nächsten Jahren realistisch nicht nutzen würdest.
Hero statt Sündenbock: wie Entscheider sich mit der richtigen Plattform absichern
Viele Verantwortliche für Daten- und Digitalprojekte stehen unter Druck: Sie sollen Innovation ermöglichen, aber zugleich sicherstellen, dass Projekte nicht aus dem Ruder laufen. Die Wahl einer überdimensionierten Plattform birgt hier das Risiko, später für zu hohe Kosten oder ausufernde Komplexität verantwortlich gemacht zu werden.
Eine Plattform, die zur eigenen Organisation passt, macht Dich dagegen zum Enabler: Du schaffst in kurzer Zeit ein stabiles Datenfundament, entlastest Teams und baust eine Basis, auf der KI- und Automatisierungsprojekte sicher aufsetzen können. Genau das ist der Anspruch von bimanu One.

Weiterführende Ressourcen und Autorenschaft
Vertiefende Inhalte auf bimanu.de: Vergleich, Contextual Intelligence, Preise, Kunden
Wenn Du tiefer in das Thema Contextual Intelligence einsteigen möchtest, findest Du auf bimanu.de/contextual-intelligence/ eine ausführliche Einführung. Dort zeigen wir, wie CI im Alltag funktioniert und welche Use Cases sich besonders eignen.
Einen Überblick über Pakete und Preise von bimanu One erhältst Du unter bimanu.de/preise/, Kundenstimmen und Praxisbeispiele findest Du auf bimanu.de/kunden/.
Snowflake als Fundament: warum Cloud nicht das Problem ist
Cloud ist nicht per se teuer oder unsicher – kritisch ist, wie sie eingesetzt wird. Unser Beitrag „Die Top 10 Snowflake-Partner“ erklärt, warum Snowflake als Fundament für Mittelstands-Lösungen sinnvoll ist und welche Vorteile eine saubere Architektur bringt.
Wichtig ist dabei immer: Die technische Komplexität gehört unter die Haube, nicht auf den Schreibtisch der Fachbereiche. Genau nach diesem Prinzip ist bimanu One aufgebaut.
Buch „33 Impulse für einfache Datenstrategien im Mittelstand“
Für einen breiteren Blick auf Datenstrategien im Mittelstand empfehlen wir das Buch „33 Impulse für einfache Datenstrategien im Mittelstand“. Es zeigt anhand praxisnaher Beispiele, wie Unternehmen schrittweise von ersten Reports zu datengetriebenen Entscheidungen kommen – ohne sich in Großprojekten zu verlieren.
Viele der dort beschriebenen Prinzipien – etwa Fokus auf Use Cases, pragmatische Governance und klare Verantwortlichkeiten – spiegeln sich in der Konzeption von bimanu One wider.
Podcast „Wertgeschätzt“: Praxisgeschichten aus dem Mittelstand
Im Podcast „Wertgeschätzt“ spricht Swen Göllner mit Verantwortlichen aus dem Mittelstand über ihre Erfahrungen mit Digitalisierung, Daten und Führung. Die Gespräche zeigen, wie unterschiedlich Unternehmen an das Thema herangehen – und welche Muster sich in erfolgreichen Projekten wiederholen.
Wenn Du Entscheidungsdruck rund um Datenplattformen spürst, kann es hilfreich sein zu hören, wie andere Verantwortliche mit genau diesem Druck umgehen und welche Wege sie gewählt haben.
Microsoft Fabric und bimanu One – Häufige Fragen aus dem Mittelstand
Was ist Microsoft Fabric und wofür eignet sich die Plattform am besten?
Microsoft Fabric ist eine integrierte Daten- und Analytics-Plattform von Microsoft, die Data Lake, Data Warehouse, Data Engineering, Data Science, Echtzeit-Analytik und Power BI in einer Umgebung bündelt. Am besten eignet sie sich für größere Organisationen, die viele verteilte Daten- und BI-Systeme konsolidieren und zentral steuern wollen.
Wie viel kostet Microsoft Fabric wirklich – und warum sind die Kosten so schwer planbar?
Die Kosten von Fabric setzen sich aus Kapazitäts-SKUs (F‑SKUs), dem Verbrauch von Capacity Units, Speicher-, Netzwerk- und optionalen KI-Kosten sowie Nutzerlizenzen für Power BI zusammen. Sie sind schwer planbar, weil sie stark von Nutzungsmustern, Workload-Spitzen und Governance abhängen – ohne konsequentes Monitoring kannst Du die spätere Ausgabenkurve nur schwer abschätzen.
Welche Skills brauche ich intern, um Microsoft Fabric sinnvoll zu betreiben?
Du brauchst Data Engineers für Integration und Pipelines, BI-Entwickler:innen mit DAX- und Datenmodellierungs-Know-how, jemanden für Governance und Security sowie Kapazitäts- und Kostensteuerung. In größeren Setups kommen oft noch Data Scientists und Architekten hinzu, die die Gesamtarchitektur verantworten.
Wir nutzen bereits Power BI – brauchen wir zusätzlich Fabric oder eher ein sauberes Data Warehouse?
Wenn Deine aktuellen Probleme vor allem aus inkonsistenten Daten, manuellem Reporting und fehlender Governance stammen, ist ein sauberes Data Warehouse mit zentralem Kennzahlenkatalog meist der wichtigere nächste Schritt als der Umstieg auf Fabric. Fabric kann diese Rolle übernehmen, erfordert aber deutlich mehr Setup- und Betriebsaufwand als eine fokussierte Plattform wie bimanu One.
Worin unterscheidet sich bimanu One konkret von Microsoft Fabric?
bimanu One ist eine für den Mittelstand zugeschnittene Contextual-Intelligence-Plattform mit klarem Stufenmodell, Managed Service und eigenem Snowflake-Fundament. Im Unterschied zu Fabric kaufst Du keine generische Kapazität, sondern eine schlüsselfertige Lösung mit Data Warehouse, KI-Modulen, Kontext-Layer und Betrieb – inklusive Academy für Enablement und mit Fokus auf planbare Kosten.
Wie schnell können wir mit bimanu One erste aussagekräftige Dashboards produktiv nutzen?
In der Regel stehen erste produktive Dashboards innerhalb von etwa fünf Wochen, wenn Quellsysteme zugänglich sind und KPIs definiert werden können. Ein vollständiger Kern-Use-Case – etwa Monatsabschluss oder ein zentrales Produktions-Cockpit – wird typischerweise in sechs bis acht Wochen umgesetzt.
Wie stellt bimanu One Datenschutz, DSGVO und EU-AI-Act-Konformität sicher?
bimanu One wird in der EU betrieben, setzt auf ISO-27001-konforme Prozesse und arbeitet mit klaren Rollen- und Rechtekonzepten, Audit-Logs und Datenklassifikation. KI-Module werden so ausgelegt, dass Trainingsdaten, Modelle und Ausgaben nachvollziehbar sind und die Anforderungen des EU AI Act an Transparenz, Governance und Risikoabwägung erfüllen.
Bleiben unsere Daten im eigenen Besitz – oder landen sie komplett beim Anbieter?
Deine Daten bleiben in Deinem eigenen Snowflake-Konto und damit in Deinem Besitz; bimanu erhält ausschließlich die für Betrieb und Weiterentwicklung nötigen Zugriffsrechte im Rahmen klarer vertraglicher Regelungen. Dieser Ansatz reduziert Lock-in-Risiken und sichert Dir langfristige Datenhoheit, auch wenn sich Deine Plattformstrategie einmal ändern sollte.
Ist bimanu One mit bestehenden Tools wie Power BI oder Tableau kompatibel?
Ja, bimanu One liefert eine saubere, zentral gemanagte Datenbasis, auf die Du mit Tools wie Power BI, Tableau oder Qlik zugreifen kannst. Die Plattform ersetzt damit nicht zwingend Dein Frontend, sondern stellt sicher, dass alle diese Tools auf dieselbe, verlässliche Datenbasis zugreifen.
Wie erkenne ich, ob wir eher eine Enterprise-Plattform wie Fabric oder eine CI-Plattform wie bimanu One brauchen?
Wenn Du internationale Strukturen, viele dezentrale Analytics-Teams und zahlreiche bestehende Azure-Services konsolidieren möchtest, ist eine Enterprise-Plattform wie Fabric sinnvoll. Wenn Dein Hauptziel dagegen schnelle, verlässliche Insights, planbare Kosten und Entlastung knapper IT-Ressourcen im Mittelstand sind, spricht Vieles für eine Contextual-Intelligence-Plattform wie bimanu One – insbesondere, wenn Du keinen großen Data-Engineer-Stab aufbauen möchtest.