
In vielen Unternehmen steht das Thema Daten aktuell ganz oben auf der Agenda. Es wird in Dashboards investiert, erste KI-Anwendungen getestet und Prozesse sollen durch Automatisierung effizienter werden. Die Erwartungen sind hoch: bessere Entscheidungen, schnellere Abläufe, mehr Transparenz.
In der Praxis zeigt sich jedoch häufig ein anderes Bild.
Berichte liefern widersprüchliche Kennzahlen, Forecasts ändern sich je nach Abteilung, und KI-Modelle produzieren Ergebnisse, die schwer nachvollziehbar oder schlicht unbrauchbar sind. Statt Klarheit entsteht neue Unsicherheit – trotz moderner Tools und steigender Investitionen.
Der Reflex ist oft, das eingesetzte Werkzeug infrage zu stellen:
Ist das BI-Tool leistungsfähig genug? Brauchen wir eine andere KI-Lösung? Müssen wir stärker automatisieren?
Doch genau hier liegt der Denkfehler.
Der eigentliche Engpass liegt nur selten im Tool selbst.
Er liegt fast immer eine Ebene darunter – in der Art und Weise, wie Daten im Unternehmen organisiert, integriert und strukturiert sind. Fehlt eine saubere, zentrale Datenbasis, arbeiten selbst die besten Analyse- oder KI-Werkzeuge zwangsläufig mit unvollständigen, inkonsistenten oder veralteten Informationen.
Viele Organisationen haben über Jahre hinweg punktuelle Lösungen aufgebaut:
ein Reporting hier, ein Data Lake dort, Excel-Auswertungen in den Fachabteilungen. Diese gewachsenen Strukturen funktionieren isoliert oft gut, ergeben in Summe jedoch kein konsistentes Gesamtbild. Statt eines „Single Point of Truth“ entstehen Datensilos, unterschiedliche Kennzahlendefinitionen und manuelle Abstimmungen zwischen Bereichen.
Genau an diesem Punkt wird deutlich, warum Datenplattformen heute neu gedacht werden müssen.
Eine moderne Datenplattform ist kein weiteres Tool im Stack und auch kein rein technisches Infrastrukturprojekt. Sie ist das strukturelle Fundament, auf dem Business Intelligence, Automatisierung und KI erst sinnvoll aufbauen können.
Ohne dieses Fundament bleiben datengetriebene Initiativen Stückwerk.
Mit ihm entsteht eine belastbare Grundlage, auf der Unternehmen ihre Daten nicht nur auswerten, sondern strategisch nutzen können – konsistent, skalierbar und zukunftsfähig.
Passend zum Blog gibt es auch eine Podcastfolge. Hör gerne rein.
Was ist eine Datenplattform – und was nicht?
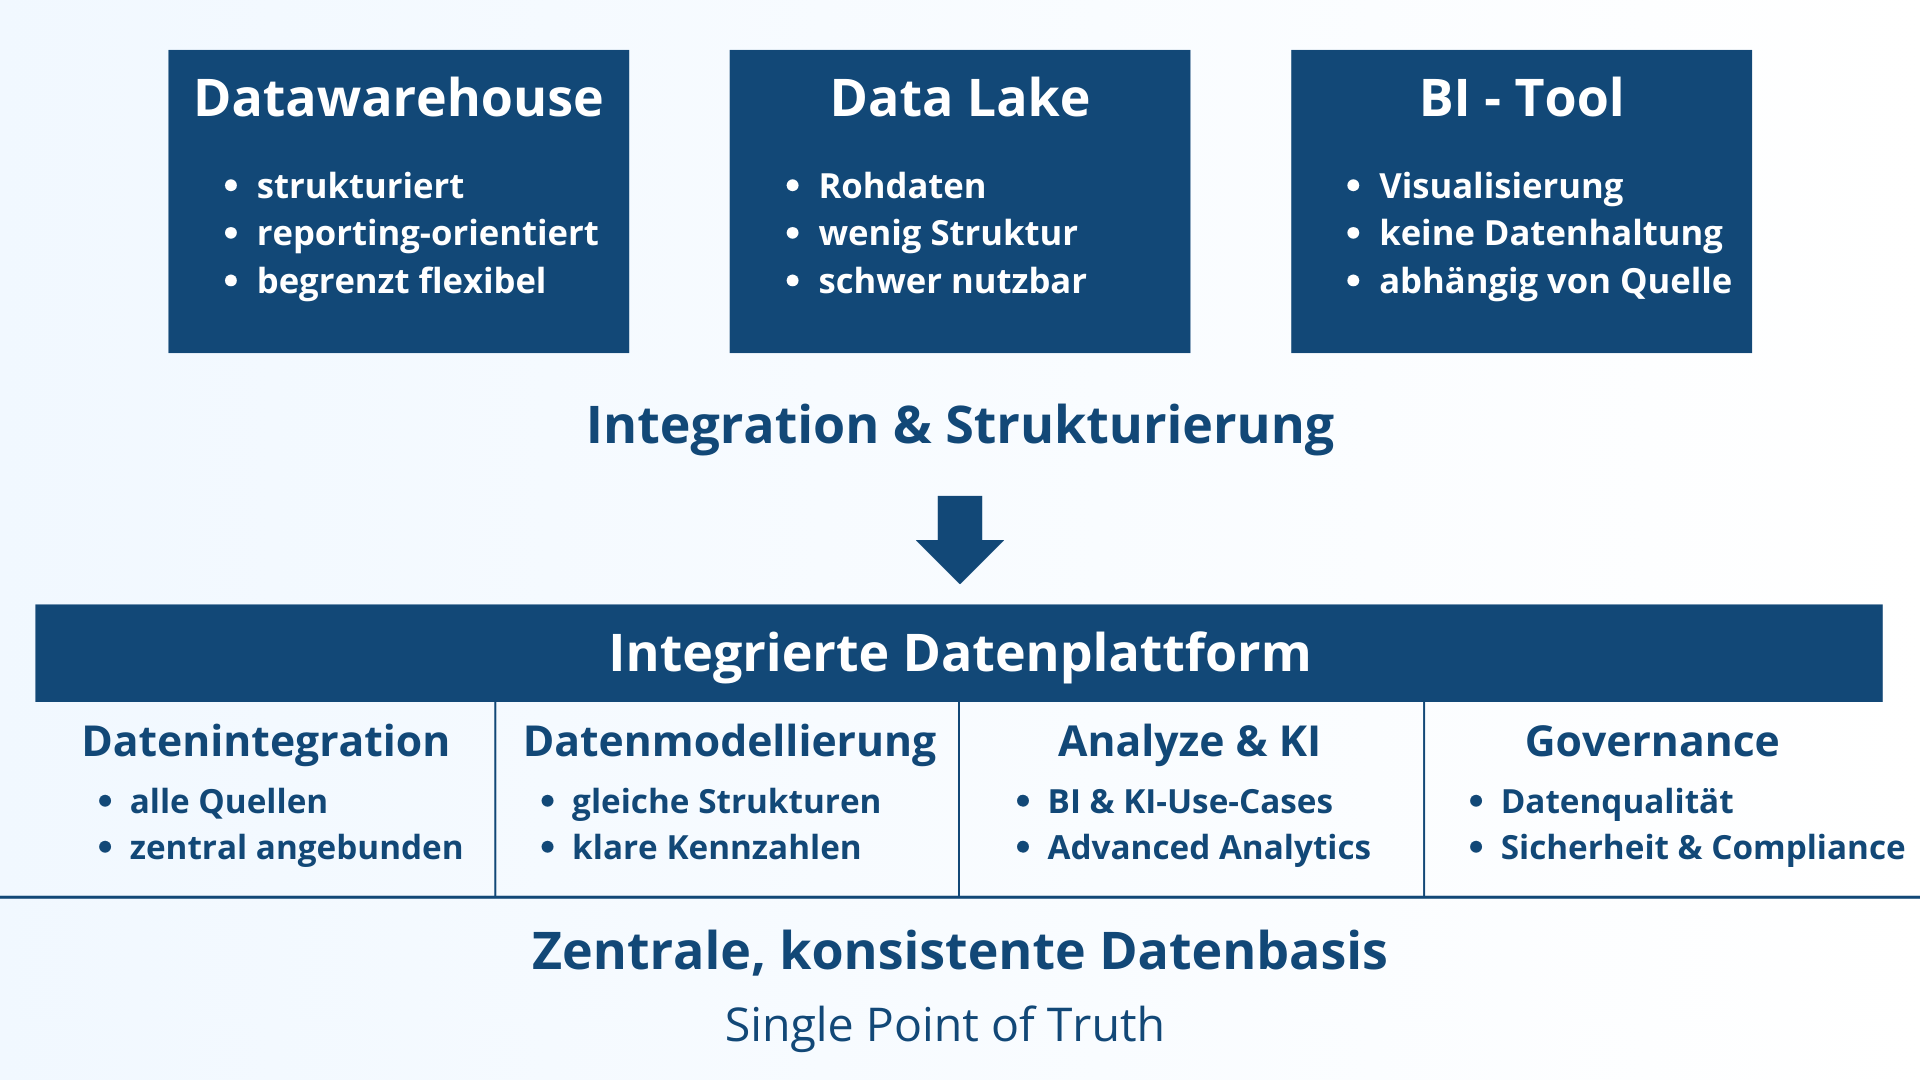
Eine Datenplattform ist eine technische und konzeptionelle Umgebung, die Unternehmen dabei unterstützt, Daten aus unterschiedlichsten Quellen zentral zu erfassen, strukturiert zu organisieren, kontinuierlich aufzubereiten und systematisch für Analysen bereitzustellen. Ihr Ziel ist es nicht nur, Daten verfügbar zu machen, sondern sie konsistent, nachvollziehbar und entscheidungsrelevant zu halten.
Dabei geht es explizit nicht um eine einzelne Technologie oder ein bestimmtes Produkt. Eine Datenplattform beschreibt vielmehr einen ganzheitlichen Ansatz, der mehrere Funktionen und Ebenen der Datenverarbeitung miteinander verbindet – von der Integration über die Modellierung bis hin zur Nutzung in Fachbereichen.
Gerade hier entstehen in der Praxis häufig Missverständnisse. Denn viele Unternehmen setzen bereits seit Jahren auf einzelne Datenlösungen und gehen davon aus, damit automatisch über eine Datenplattform zu verfügen. Ein genauer Blick zeigt jedoch deutliche Unterschiede.
Abgrenzung zu klassischen Einzelkomponenten
Data Warehouses
Data Warehouses sind stark strukturierte Systeme, die Daten aus verschiedenen Quellen zusammenführen und für Reporting und Analysen optimieren. Sie liefern verlässliche Ergebnisse, sind jedoch oft:
-
auf fest definierte Fragestellungen ausgelegt
-
relativ unflexibel bei neuen Anforderungen
-
mit hohem Modellierungs- und Pflegeaufwand verbunden
Sie sind ein wichtiger Baustein – aber keine vollständige Datenplattform.
Data Lakes
Data Lakes ermöglichen die flexible Speicherung großer Datenmengen in ihrem Rohformat. Sie sind besonders geeignet für:
-
unstrukturierte oder semistrukturierte Daten
-
explorative Analysen
-
große Volumina und hohe Varianz
Ohne zusätzliche Strukturierungs- und Governance-Mechanismen entstehen hier jedoch schnell sogenannte Data Swamps: Daten sind zwar vorhanden, aber schwer auffindbar, nicht vergleichbar und kaum produktiv nutzbar.
BI-Tools
Business-Intelligence-Werkzeuge konzentrieren sich auf die Visualisierung und Analyse von Daten. Sie liefern Dashboards, Berichte und Self-Service-Funktionen für Anwender. Was sie jedoch nicht leisten:
-
zentrale Datenhaltung
-
konsistente Datenmodellierung
-
Steuerung von Datenqualität und Historisierung
BI-Tools arbeiten immer auf einer Datenbasis – sie schaffen diese nicht.
Die Rolle der Datenplattform
Eine Datenplattform verbindet genau diese isolierten Ansätze zu einem übergreifenden System. Sie kombiniert:
-
Integration: Anbindung verschiedenster Datenquellen aus IT und Fachbereichen
-
Strukturierung: Einheitliche Modelle, Kennzahlendefinitionen und Historisierung
-
Analysefähigkeit: Bereitstellung der Daten für BI, Advanced Analytics und KI
-
Governance: Regeln für Qualität, Zugriff, Nachvollziehbarkeit und Compliance
Damit entsteht eine zentrale, verlässliche Datenbasis, auf die alle weiteren Anwendungen zugreifen können.
Eine zentrale Erkenntnis aus der Podcastfolge bringt diesen Zusammenhang auf den Punkt:
Ein Berichtswerkzeug ist nie die Lösung – es ist nur die Darstellungsschicht.
Ohne eine vorgelagerte, konsolidierte Datenplattform bleibt jede neue Oberfläche genau das: eine neue Sicht auf alte, fragmentierte Daten. Unterschiedliche Abteilungen arbeiten weiterhin mit eigenen Definitionen, Abstimmungen erfolgen manuell, und Vertrauen in Zahlen entsteht nur bedingt.
Erst mit einer gemeinsamen Datenplattform wird ein echter „Single Point of Truth“ möglich – nicht als theoretisches Zielbild, sondern als operative Grundlage für datengetriebene Entscheidungen.
Der konkrete Nutzen einer Datenplattform für Unternehmen
Zentralisierung: Eine gemeinsame Datenbasis statt verteilter Datensilos
In vielen Unternehmen liegen Daten heute über zahlreiche Systeme verteilt: ERP, CRM, Produktionssysteme, Fachanwendungen, Excel-Dateien, Cloud-Tools. Jede Abteilung greift auf „ihre“ Daten zu, oft mit eigenen Kopien und eigenen Logiken. Das Ergebnis ist kein Überblick, sondern ein Nebeneinander unterschiedlicher Datenstände.
Eine Datenplattform schafft hier einen grundlegenden Perspektivwechsel. Sie führt relevante Daten zentral zusammen, unabhängig davon, wo sie ursprünglich entstanden sind. Diese Zentralisierung bedeutet nicht, dass operative Systeme ersetzt werden, sondern dass ihre Daten in einer gemeinsamen Struktur verfügbar gemacht werden.
Der konkrete Nutzen zeigt sich schnell:
-
Fachbereiche greifen auf dieselbe Datenbasis zu
-
Abstimmungen über „richtige Zahlen“ nehmen ab
-
Analysen müssen nicht mehrfach aufgebaut werden
Zentralisierung ist damit weniger ein technisches Ziel als eine organisatorische Entlastung. Daten werden nicht mehr verteilt gesucht, sondern gezielt genutzt.
Anbindung: Wachstum ermöglichen, ohne die Architektur zu destabilisieren
Unternehmen verändern sich kontinuierlich. Neue Tools werden eingeführt, Standorte kommen hinzu, Prozesse werden digitalisiert. Jede Veränderung erzeugt neue Daten – und erhöht den Integrationsaufwand.
Ohne Datenplattform werden neue Datenquellen häufig isoliert angebunden: ein zusätzlicher Report hier, eine neue Schnittstelle dort. Die Architektur wächst ungeplant und wird zunehmend fragil.
Eine Datenplattform verfolgt einen anderen Ansatz. Sie stellt standardisierte Mechanismen zur Datenanbindung bereit, sodass neue Quellen strukturiert integriert werden können, ohne bestehende Logiken zu gefährden. Das gilt für operative Systeme ebenso wie für externe Daten oder IoT-Quellen.
Der Nutzen liegt in der Zukunftsfähigkeit:
-
neue Systeme lassen sich schneller einbinden
-
Integrationen folgen klaren Regeln
-
technische Schulden werden vermieden
Damit wird Wachstum nicht zum Risiko, sondern zu einer beherrschbaren Entwicklung.
Konsistenz: Vertrauen in Zahlen durch gemeinsame Definitionen
Eines der größten praktischen Probleme in datengetriebenen Organisationen ist nicht der Mangel an Daten, sondern der Mangel an Konsistenz. Dieselbe Kennzahl wird in unterschiedlichen Berichten unterschiedlich berechnet. Begriffe wie Umsatz, Kunde oder Marge sind nicht eindeutig definiert.
Ohne zentrale Struktur entsteht ein permanenter Klärungsbedarf. Meetings drehen sich um Zahlenabweichungen statt um Entscheidungen. Vertrauen in Analysen sinkt.
Eine Datenplattform adressiert dieses Problem auf struktureller Ebene. Sie ermöglicht es, Kennzahlen, Berechnungslogiken und Definitionen zentral festzulegen und für alle Auswertungen verbindlich bereitzustellen. Änderungen erfolgen nachvollziehbar und versioniert.
Der Mehrwert ist erheblich:
-
einheitliche Sicht auf das Geschäft
-
vergleichbare Auswertungen über Abteilungen hinweg
-
belastbare Entscheidungsgrundlagen für das Management
Konsistenz ist damit keine Detailfrage, sondern eine Voraussetzung für Steuerungsfähigkeit.
Echtzeitfähigkeit: Handlungsfähigkeit statt Rückspiegel-Analyse
Viele klassische Berichtssysteme arbeiten mit zeitlicher Verzögerung. Daten werden gesammelt, aufbereitet und in festen Zyklen bereitgestellt. Entscheidungen basieren dadurch häufig auf Vergangenheitswerten, nicht auf aktuellen Entwicklungen.
Moderne Datenplattformen ermöglichen es, Daten nahezu in Echtzeit zu verarbeiten und bereitzustellen. Das bedeutet nicht, dass jede Analyse live sein muss, sondern dass Unternehmen flexibel entscheiden können, wann Aktualität kritisch ist.
Der Nutzen zeigt sich besonders in dynamischen Bereichen:
-
Vertrieb erkennt Veränderungen frühzeitig
-
Logistik kann auf Engpässe reagieren
-
Produktion sieht Abweichungen sofort
Echtzeitfähigkeit erhöht damit nicht nur die Geschwindigkeit von Analysen, sondern die Reaktionsfähigkeit des gesamten Unternehmens.
Governance & Sicherheit: Daten kontrollieren, statt Risiken zu verwalten
Mit wachsender Datenmenge steigen die Anforderungen an Datenschutz, Sicherheit und Nachvollziehbarkeit. Ohne zentrale Steuerung entstehen schnell unübersichtliche Berechtigungen, manuelle Exporte und unklare Verantwortlichkeiten.
Eine Datenplattform bietet die Möglichkeit, Governance als integralen Bestandteil der Datenarchitektur zu etablieren. Zugriffsrechte, Datenqualität, Historisierung und Compliance-Regeln werden nicht nachträglich ergänzt, sondern systematisch berücksichtigt.
Das hat mehrere Effekte:
-
klare Regelungen, wer welche Daten sehen darf
-
nachvollziehbare Änderungen und Datenhistorien
-
bessere Vorbereitung auf Prüfungen und Audits
Governance wird damit vom reaktiven Kontrollmechanismus zu einem stabilisierenden Faktor der Datenstrategie.
Ergebnis: Von Datenverwaltung zu steuerbarer Informationsnutzung
In der Gesamtsicht führt eine Datenplattform dazu, dass Daten nicht länger isoliert erzeugt und verwaltet werden, sondern als zusammenhängende Informationsbasis dienen. Prozesse werden klarer, Analysen belastbarer und neue Anwendungsfälle – etwa Automatisierung oder KI – realistisch umsetzbar.
Aus einem operativen Nebeneinander von Tools und Datenständen entsteht eine steuerbare, strategisch nutzbare Informationslandschaft. Genau darin liegt der nachhaltige Nutzen einer Datenplattform für Unternehmen.
Wie funktioniert eine moderne Datenplattform?
Damit eine Datenplattform ihre Vorteile tatsächlich entfalten kann, muss sie auf bestimmten technischen Grundprinzipien aufbauen. Diese Prinzipien unterscheiden moderne Plattformen grundlegend von klassischen On-Premises-Systemen oder historisch gewachsenen BI-Landschaften.
Im Kern lassen sich zwei Prinzipien identifizieren, die heute als Standard für leistungsfähige und zukunftssichere Datenplattformen gelten:
die Trennung von Speicher und Rechenleistung sowie die elastische Nutzung von Cloud-Ressourcen.
Verfügbarkeit durch die Trennung von Speicher und Rechenleistung
In klassischen IT-Architekturen waren Datenspeicherung und Rechenleistung eng miteinander verbunden. Daten lagen auf bestimmten Servern, und genau dort musste auch die Rechenleistung bereitgestellt werden. Wuchsen die Datenmengen oder stieg die Anzahl der Analysen, musste die gesamte Infrastruktur erweitert werden – oft mit hohen Investitionskosten und langen Planungszyklen.
Moderne Datenplattformen lösen dieses starre Modell auf. Sie entkoppeln Storage und Compute konsequent voneinander:
-
Storage dient ausschließlich der kosteneffizienten, skalierbaren Speicherung großer Datenmengen
-
Compute stellt Rechenleistung für Transformationen, Abfragen und Analysen bereit
Diese Trennung hat mehrere entscheidende Vorteile. Daten können langfristig und vergleichsweise günstig gespeichert werden, unabhängig davon, wie häufig oder intensiv sie genutzt werden. Rechenleistung wird hingegen nur dann aktiviert, wenn sie tatsächlich benötigt wird – etwa für einen Monatsabschluss, eine komplexe Analyse oder ein KI-Training.
Für Unternehmen bedeutet das:
-
keine Überdimensionierung der Infrastruktur
-
bessere Planbarkeit der Kosten
-
jederzeitige Verfügbarkeit aller historischen Daten
Die Datenplattform wird damit zu einer stabilen Basis, auf der Analysen jederzeit gestartet werden können, ohne zuvor Kapazitäten dauerhaft vorhalten zu müssen.
Elastizität durch Cloud-Architektur
Eng verbunden mit der Trennung von Storage und Compute ist das Prinzip der Elastizität. Moderne Datenplattformen nutzen cloudbasierte Infrastrukturen, die sich dynamisch an den tatsächlichen Bedarf anpassen.
Statt fixer Serverkapazitäten stehen skalierbare Ressourcen zur Verfügung, die automatisch hoch- oder heruntergefahren werden können. Das ist insbesondere in Szenarien relevant, in denen der Daten- oder Analysebedarf stark schwankt.
Typische Beispiele sind:
-
Monats-, Quartals- oder Jahresabschlüsse
-
saisonale Spitzen wie Black Friday oder Kampagnenstarts
-
umfangreiche Ad-hoc-Analysen oder Simulationen
In diesen Phasen kann die Plattform ihre Rechenleistung kurzfristig erhöhen, um große Datenmengen schnell zu verarbeiten. Sinkt der Bedarf, werden die Ressourcen wieder reduziert.
Der Nutzen liegt auf mehreren Ebenen:
-
Kostenkontrolle: Es wird nur das bezahlt, was tatsächlich genutzt wird
-
Performance: Analysen laufen auch bei hoher Last stabil
-
Nachhaltigkeit: Energieverbrauch sinkt durch bedarfsgerechte Nutzung
Elastizität macht die Datenplattform damit nicht nur leistungsfähig, sondern auch wirtschaftlich und ressourcenschonend.
Zusammenspiel der Prinzipien im Unternehmensalltag
Erst im Zusammenspiel entfalten diese beiden Prinzipien ihre volle Wirkung. Die dauerhafte Verfügbarkeit großer Datenmengen trifft auf flexibel abrufbare Rechenleistung. Unternehmen können historische Daten jederzeit analysieren, neue Fragestellungen prüfen und zusätzliche Use Cases aufsetzen, ohne ihre Infrastruktur grundlegend umbauen zu müssen.
Damit wird die Datenplattform zu einem adaptiven System, das sich dem Geschäft anpasst – und nicht umgekehrt. Neue Anforderungen, zusätzliche Nutzer oder steigende Datenvolumina führen nicht mehr automatisch zu Engpässen oder Kostenexplosionen, sondern lassen sich kontrolliert abbilden.
Grundlage für BI, Automatisierung und KI
Diese Architektur ist nicht nur eine technische Optimierung, sondern die Voraussetzung für weiterführende Anwendungsfälle. Business Intelligence profitiert von stabiler Performance, Automatisierungen von verlässlicher Datenverfügbarkeit und KI-Anwendungen von der Möglichkeit, große Datenmengen flexibel zu verarbeiten.
Ohne die beschriebenen Grundprinzipien bleiben moderne Analytics- und KI-Vorhaben theoretisch oder teuer. Mit ihnen entsteht eine Datenplattform, die skalierbar, wirtschaftlich und langfristig tragfähig ist.
Der Datenstack einer modernen Datenplattform – Schicht für Schicht erklärt
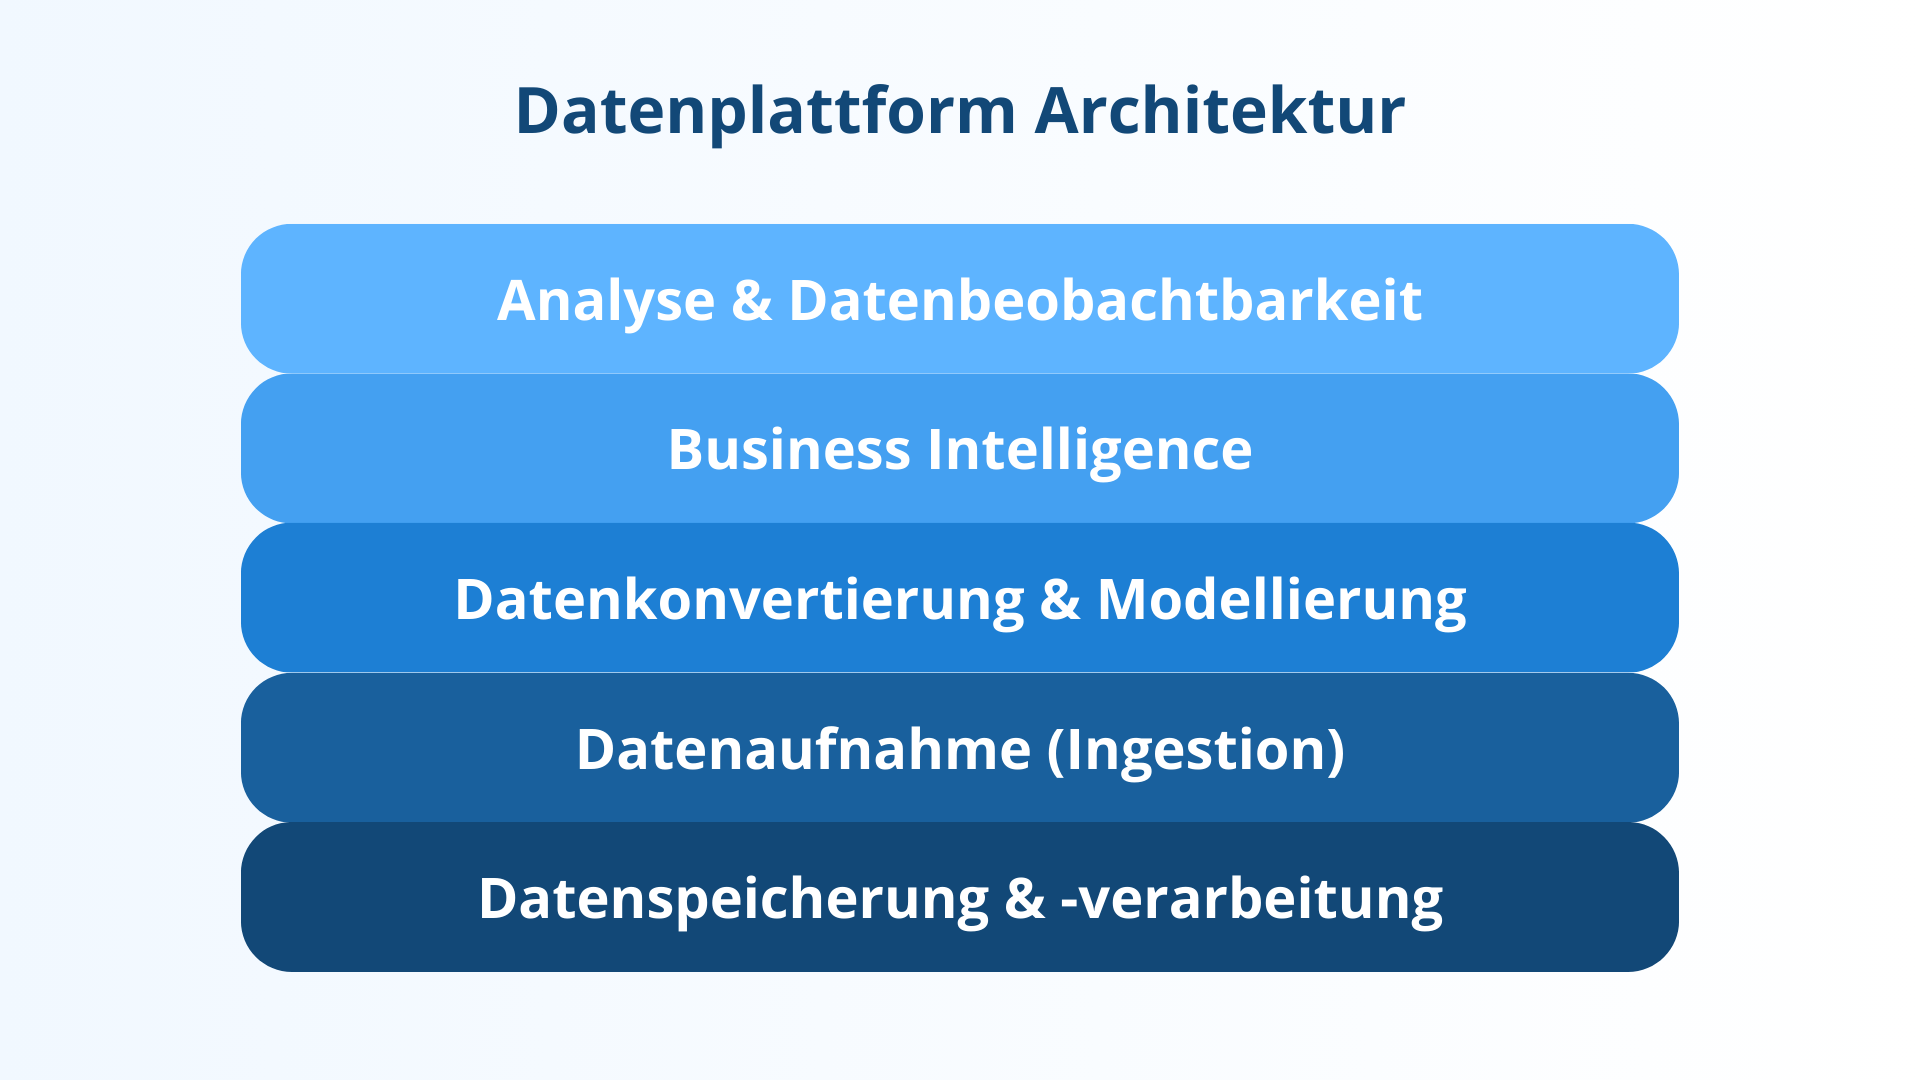
Eine moderne Datenplattform lässt sich sinnvoll als klar strukturierter Datenstack verstehen. Jede Schicht übernimmt eine definierte Aufgabe im Lebenszyklus der Daten. Erst das Zusammenspiel aller Ebenen ermöglicht stabile Analysen, Automatisierung und den Einsatz von KI.
Wichtig dabei: Die Schichten sind logisch getrennt, aber nicht isoliert. Daten fließen entlang des Stacks und werden mit jeder Ebene weiter veredelt.
1. Datenspeicherung & -verarbeitung: Das technische Rückgrat der Plattform
Die unterste Schicht bildet die zentrale Datenspeicherung und -verarbeitung. Hier werden große Datenmengen dauerhaft abgelegt und für nachgelagerte Prozesse verfügbar gemacht. Typische Ausprägungen sind Data Lakes, Data Warehouses oder hybride Konzepte wie Lakehouses.
Diese Schicht erfüllt mehrere zentrale Aufgaben:
- Speicherung großer Datenvolumina aus unterschiedlichen Quellen
- Historisierung von Daten über lange Zeiträume
- Grundlage für alle weiteren Verarbeitungsschritte
Moderne Plattformen trennen hier bewusst Speicher und Rechenleistung. Daten können kostengünstig vorgehalten werden, während Rechenkapazitäten flexibel zugeschaltet werden. Dadurch bleibt die Plattform auch bei stark wachsenden Datenmengen performant und wirtschaftlich.
Diese Schicht ist bewusst fachlich neutral. Sie kennt noch keine Kennzahlen oder Geschäftslogiken, sondern stellt Roh- und Basisdaten stabil bereit.
2. Datenaufnahme (Ingestion): Der kontrollierte Zufluss von Daten
Die nächste Schicht regelt, wie Daten überhaupt in die Plattform gelangen. Unternehmen erzeugen Daten in sehr unterschiedlichen Systemen: ERP, CRM, Produktionsanlagen, Sensoren, Webanwendungen oder externen Datenquellen.
Die Datenaufnahme sorgt dafür, dass diese Informationen:
- zuverlässig
- reproduzierbar
- nachvollziehbar
in die Plattform integriert werden.
Dabei kommen unterschiedliche Verfahren zum Einsatz:
- Batch-Verarbeitung für periodische Daten (z. B. tägliche Buchungen)
- Echtzeit- oder Near-Realtime-Verarbeitung für zeitkritische Informationen
Eine saubere Ingestion ist entscheidend, um spätere Probleme zu vermeiden. Fehlerhafte, unvollständige oder doppelte Daten entstehen häufig bereits an dieser Stelle. Eine moderne Datenplattform etabliert deshalb klare Regeln, wann, wie und in welcher Qualität Daten übernommen werden.
3. Datenkonvertierung & Modellierung: Von Rohdaten zu nutzbarer Information
In dieser Schicht findet der entscheidende Schritt von Daten zu Information statt. Rohdaten aus verschiedenen Quellen sind selten direkt vergleichbar oder analysierbar. Sie unterscheiden sich in Formaten, Strukturen und Bedeutungen.
Die Datenkonvertierung umfasst:
- Bereinigung fehlerhafter oder unvollständiger Daten
- Harmonisierung von Formaten, Einheiten und Bezeichnungen
- Zusammenführung zusammengehöriger Datensätze
Darauf aufbauend erfolgt die fachliche Modellierung. Hier werden Daten in Strukturen überführt, die den Geschäftslogiken des Unternehmens entsprechen. Begriffe wie Kunde, Auftrag, Umsatz oder Maschine erhalten eine eindeutige Bedeutung.
Diese Schicht ist zentral für:
- konsistente Kennzahlen
- Wiederverwendbarkeit von Daten
- Skalierbarkeit von Analysen
Ohne saubere Modellierung entstehen zwar Datenmengen, aber keine verlässlichen Entscheidungsgrundlagen.
4. Business Intelligence: Daten für Fachbereiche nutzbar machen
Erst in dieser Schicht werden Daten sichtbar und nutzbar für Anwender:innen. Business Intelligence umfasst Dashboards, Standardberichte und Self-Service-Analysen, die Fachbereiche im Alltag unterstützen.
Die Stärke dieser Ebene liegt darin, dass sie:
- komplexe Datenmodelle verständlich aufbereitet
- unterschiedliche Nutzergruppen adressiert
- schnelle Einblicke in Entwicklungen ermöglicht
Wichtig ist: BI ist nicht der Ursprung, sondern ein Verbraucher der Daten. Ihre Qualität hängt vollständig von den vorgelagerten Schichten ab. Eine stabile Datenplattform sorgt dafür, dass BI-Werkzeuge nicht mit individuellen Datenlogiken arbeiten müssen, sondern auf eine konsistente Basis zugreifen.
So wird BI vom individuellen Auswertungswerkzeug zur unternehmensweiten Steuerungskomponente.
5. Analyse & Datenbeobachtbarkeit: Von Beschreibung zu Prognose
Die oberste Schicht erweitert klassische BI um fortgeschrittene Analysefunktionen. Hier geht es nicht mehr nur darum, was passiert ist, sondern warum es passiert ist und was wahrscheinlich passieren wird.
Typische Funktionen dieser Ebene sind:
- Monitoring von Datenflüssen und Datenqualität
- Erkennung von Anomalien und Ausreißern
- Forecasts und Szenarien
- Vorbereitung und Versorgung von KI- und ML-Modellen
Diese Schicht macht Datenplattformen zukunftsfähig. Sie ermöglicht es, aus stabilen Datenstrukturen heraus neue Fragestellungen zu beantworten, ohne die Architektur jedes Mal neu zu denken.
Sicherheits- und Datenschutzmechanismen: Schichtübergreifende Leitplanken
Sicherheit, Datenschutz und Governance sind keine eigene Schicht, sondern wirken über den gesamten Datenstack hinweg. Zugriffsrechte, Verschlüsselung, Protokollierung und Compliance-Anforderungen müssen auf jeder Ebene berücksichtigt werden.
Eine moderne Datenplattform stellt sicher, dass:
- sensible Daten geschützt sind
- Zugriffe nachvollziehbar bleiben
- gesetzliche Vorgaben eingehalten werden
So entsteht Vertrauen – intern bei den Anwender:innen und extern bei Partnern, Kunden oder Prüfern.
Zusammengefasst: Struktur schafft Skalierbarkeit
Der Datenstack macht deutlich: Eine Datenplattform ist kein monolithisches System, sondern ein klar strukturiertes Zusammenspiel spezialisierter Ebenen. Jede Schicht erfüllt eine eigene Aufgabe, trägt aber zum gemeinsamen Ziel bei: Daten zuverlässig, konsistent und strategisch nutzbar zu machen.
Anwendungsfälle aus der Praxis
Datenplattformen entfalten ihren eigentlichen Wert dort, wo Daten nicht nur ausgewertet, sondern aktiv zur Steuerung von Prozessen eingesetzt werden. Die folgenden Praxisbeispiele zeigen typische Szenarien, in denen Unternehmen durch eine integrierte Datenbasis messbare Verbesserungen erzielen.
Lieferketten steuern statt nur beobachten
In vielen Logistik- und Handelsunternehmen existieren relevante Informationen entlang der Lieferkette in getrennten Systemen. GPS-Daten aus Fahrzeugen, Lagerbestände aus Warenwirtschaftssystemen und Auftragsdaten aus ERP oder Shopsystemen werden jeweils isoliert betrachtet. Entscheidungen basieren dadurch oft auf zeitverzögerten oder unvollständigen Informationen.
Ein Logistikunternehmen hat diese Situation durch den Aufbau einer zentralen Datenplattform verändert. In der Plattform wurden unter anderem folgende Datenquellen integriert:
- Echtzeit-GPS-Daten aus der Fahrzeugflotte
- aktuelle Lagerbestände aus mehreren Standorten
- Auftrags- und Lieferdaten aus dem ERP-System
Durch die Zusammenführung dieser Daten entstand erstmals ein durchgängiges Bild der gesamten Lieferkette – vom Auftragseingang bis zur Zustellung.
Der konkrete Nutzen zeigte sich auf mehreren Ebenen:
- Echtzeit-Prognosen zu Lieferzeiten: Statt statischer Liefertermine konnten voraussichtliche Ankunftszeiten dynamisch berechnet und aktualisiert werden.
- Dynamische Routenoptimierung: Verzögerungen durch Staus oder Engpässe wurden frühzeitig erkannt, alternative Routen automatisch berücksichtigt.
- Reduktion von Kosten und Verspätungen: Leerfahrten, unnötige Umlagerungen und Expresslieferungen nahmen messbar ab.
Entscheidend war dabei nicht ein einzelnes Optimierungstool, sondern die gemeinsame Datenbasis, auf der operative Entscheidungen automatisiert oder unterstützt getroffen werden konnten. Die Lieferkette wurde nicht länger nur rückblickend analysiert, sondern aktiv gesteuert.
Marketing datenbasiert zuschneiden statt pauschal ausspielen
Auch im Marketing zeigt sich der Nutzen einer Datenplattform besonders deutlich. Viele Unternehmen erfassen Kampagnendaten zwar detailliert, werten sie jedoch getrennt nach Kanälen, Standorten oder Systemen aus. Ein Gesamtbild entsteht selten, und Entscheidungen beruhen häufig auf Erfahrungswerten oder Einzelbeobachtungen.
Ein Autohaus mit mehreren Standorten stand vor genau dieser Herausforderung. Marketingaktivitäten liefen über unterschiedliche Kanäle – Online-Anzeigen, regionale Aktionen, Events vor Ort – und wurden jeweils separat bewertet. Die Vergleichbarkeit fehlte.
Mit Hilfe einer Datenplattform wurden unter anderem folgende Daten integriert:
- Kampagnendaten aus Online- und Offline-Kanälen
- Standortbezogene Verkaufszahlen
- Demografische und regionale Strukturdaten
Auf dieser Basis konnten Marketing- und Vertriebsdaten erstmals standortübergreifend konsistent analysiert werden.
Die Ergebnisse waren deutlich:
- Lokale Zielgruppenansprache: Kampagneninhalte und Budgets wurden an regionale Unterschiede angepasst, statt zentral verteilt.
- Messbare Wirkung statt Bauchgefühl: Entscheidungen über Kampagnen basierten auf klaren Kennzahlen und Vergleichswerten.
- Einheitliche Kennzahlenbasis für Marketing und Vertrieb: Beide Bereiche arbeiteten mit denselben Definitionen und Zielgrößen, was Abstimmungsaufwand reduzierte.
Die Datenplattform diente hier als verbindendes Element zwischen Marketing und Vertrieb. Sie machte Zusammenhänge sichtbar, die zuvor im Tagesgeschäft verborgen blieben, und schuf eine gemeinsame Grundlage für datenbasierte Entscheidungen.
Gemeinsamkeit der Anwendungsfälle
Beide Beispiele zeigen ein zentrales Muster:
Der eigentliche Mehrwert entsteht nicht durch einzelne Analysen, sondern durch die Integration verschiedener Datenperspektiven in einer Plattform. Erst dadurch werden operative Prozesse steuerbar, Zusammenhänge erkennbar und Optimierungspotenziale realisierbar.
Datenplattformen sind damit kein Selbstzweck. Sie sind das Fundament, auf dem Unternehmen Daten aus der Vergangenheit, Gegenwart und Zukunft sinnvoll miteinander verbinden können – unabhängig von Branche oder Unternehmensgröße.
Die 6 häufigsten Hürden bei der Einführung einer Datenplattform
Die Einführung einer Datenplattform ist für viele Unternehmen ein strategischer Schritt – gleichzeitig aber auch ein komplexer Veränderungsprozess. In der Praxis zeigen sich immer wieder ähnliche Herausforderungen, unabhängig von Branche oder Unternehmensgröße. Diese Hürden sind selten überraschend, werden jedoch häufig unterschätzt oder zu spät adressiert.
1. Heterogene Systemlandschaften
Die meisten Unternehmen arbeiten mit einer über Jahre gewachsenen IT-Landschaft. ERP-Systeme, CRM-Lösungen, Fachanwendungen, Eigenentwicklungen und Excel-Dateien existieren parallel. Oft wurden diese Systeme für spezifische Anforderungen eingeführt – ohne übergreifende Datenstrategie.
Die Herausforderung besteht weniger darin, Daten technisch anzubinden, sondern darin, ihre Unterschiede zu beherrschen:
- unterschiedliche Datenmodelle und Formate
- fehlende oder uneinheitliche Schnittstellen
- historisch gewachsene Sonderlogiken
Ohne klare Integrationsstrategie entsteht schnell ein Flickenteppich aus Schnittstellen. Eine Datenplattform muss daher nicht nur integrieren, sondern auch Ordnung in die Vielfalt bringen – was Planung und methodisches Vorgehen erfordert.
2. Schlechte Datenqualität
Ein häufiger Stolperstein ist die Erwartung, dass eine neue Plattform automatisch die Datenqualität verbessert. In Wirklichkeit macht eine Datenplattform Probleme oft erst sichtbar, die zuvor verborgen waren.
Typische Symptome schlechter Datenqualität sind:
- doppelte oder widersprüchliche Datensätze
- fehlende Pflichtfelder
- veraltete oder falsch gepflegte Informationen
Die Bereinigung dieser Probleme ist selten ein rein technischer Akt. Sie erfordert fachliche Entscheidungen: Welche Daten sind maßgeblich? Wer trägt Verantwortung? Welche Regeln gelten?
Unternehmen, die diese Fragen nicht klären, riskieren, dass die Plattform zwar technisch funktioniert, aber inhaltlich kein Vertrauen erzeugt.
3. Unklare Nutzung durch Fachbereiche
Eine weitere Hürde liegt in der fehlenden Klarheit darüber, wie und von wem die Datenplattform genutzt werden soll. Häufig wird sie als IT-Projekt gestartet, ohne konkrete Use Cases für Fachbereiche zu definieren.
Die Folgen sind absehbar:
- geringe Akzeptanz
- parallele Auswertungen außerhalb der Plattform
- Rückfall in alte Arbeitsweisen
Damit eine Datenplattform Wirkung entfaltet, müssen Fachbereiche von Anfang an eingebunden werden. Sie benötigen verständliche Strukturen, klare Mehrwerte und Schulungen. Ohne diesen Schritt bleibt die Plattform ein technisches Konstrukt ohne organisatorische Verankerung.
4. Cloud- und Datenschutzbedenken
Gerade bei cloudbasierten Datenplattformen spielen Datenschutz und Compliance eine zentrale Rolle. Unsicherheiten betreffen unter anderem:
- Speicherorte der Daten
- Zugriffsrechte und Mandantentrennung
- gesetzliche Anforderungen wie DSGVO oder branchenspezifische Vorgaben
Diese Bedenken sind berechtigt, werden jedoch häufig zu pauschal betrachtet. Statt einer differenzierten Bewertung führen sie entweder zu übervorsichtigen Entscheidungen oder zu Verzögerungen im Projekt.
Eine erfolgreiche Einführung erfordert daher frühzeitige Einbindung von Datenschutz, IT-Security und Compliance, um klare Rahmenbedingungen zu schaffen. Governance muss von Beginn an Teil der Architektur sein – nicht ein nachträglicher Zusatz.
5. Fehlende Datenhistorie
Viele Unternehmen stellen im Projektverlauf fest, dass historische Daten nur eingeschränkt oder gar nicht verfügbar sind. Frühere Systeme wurden abgelöst, Daten wurden überschrieben oder nicht konsistent archiviert.
Das wirkt sich unmittelbar auf:
- Trendanalysen
- Forecasts
- Ursachenanalysen
aus. Eine Datenplattform kann historische Daten nur dann sinnvoll nutzen, wenn sie vorhanden und korrekt strukturiert sind. Fehlt diese Basis, müssen Unternehmen entweder mit Einschränkungen leben oder gezielt Maßnahmen zur Rekonstruktion und Anreicherung ergreifen.
6. Unrealistischer Zeitdruck
Nicht selten wird erwartet, dass eine Datenplattform innerhalb weniger Wochen vollständig einsatzbereit ist und sofort alle Probleme löst. Dieser Zeitdruck entsteht häufig durch operative Engpässe oder strategische Erwartungen des Managements.
In der Praxis führt er jedoch zu:
- verkürzten Konzeptionsphasen
- unklaren Zielbildern
- technischer Schnellschüsse
Erfolgreiche Projekte setzen stattdessen auf schrittweises Vorgehen. Erste Anwendungsfälle liefern schnell sichtbaren Nutzen, während die Plattform im Hintergrund systematisch ausgebaut wird. Geschwindigkeit entsteht nicht durch Abkürzungen, sondern durch klare Priorisierung.
Zentrales Learning aus der Praxis
Ein zentrales Learning aus vielen Projekten lässt sich klar formulieren:
Technik ist selten das Hauptproblem.
Die entscheidenden Faktoren sind:
- klare Struktur
- verbindliche Governance
- realistische Erwartungen
- frühzeitige Einbindung der Fachbereiche
Unternehmen, die diese Aspekte berücksichtigen, erhöhen die Erfolgschancen ihrer Datenplattform erheblich – unabhängig von der konkreten Technologie.
Warum KI ohne Datenplattform scheitert
Künstliche Intelligenz gilt in vielen Unternehmen als nächster großer Hebel für Effizienz, Automatisierung und Wettbewerbsvorteile. Entsprechend hoch ist der Druck, KI-Anwendungen schnell einzuführen – von Chatbots über Prognosemodelle bis hin zu automatisierten Entscheidungsprozessen.
In der Praxis bleiben die Ergebnisse jedoch häufig hinter den Erwartungen zurück. KI-Modelle liefern widersprüchliche, nicht nachvollziehbare oder schlicht falsche Antworten. Prognosen schwanken stark, und das Vertrauen in die Systeme sinkt schnell.
Ein zentrales Statement aus der Podcastfolge bringt die Ursache auf den Punkt:
Ohne saubere, konsolidierte Daten wird KI nur eines liefern: falsche Antworten.
KI ist kein Erkenntnisgenerator, sondern ein Mustererkenner
Ein grundlegendes Missverständnis besteht darin, KI als „intelligentes System“ zu betrachten, das fehlende Strukturen oder inhaltliche Unklarheiten selbstständig ausgleicht. Tatsächlich arbeiten KI-Modelle ausschließlich mit den Daten, die ihnen zur Verfügung gestellt werden.
KI erkennt Muster, Korrelationen und Wahrscheinlichkeiten – sie bewertet jedoch nicht, ob Daten:
- vollständig
- konsistent
- fachlich korrekt
sind. Fehler, Inkonsistenzen oder widersprüchliche Definitionen werden nicht behoben, sondern skaliert. Je größer und komplexer das Modell, desto größer ist der Schaden durch schlechte Daten.
Warum konsistente Daten unverzichtbar sind
KI-Modelle benötigen eine stabile, widerspruchsfreie Datenbasis. Wenn identische Sachverhalte in verschiedenen Systemen unterschiedlich abgebildet sind, lernt das Modell falsche Zusammenhänge.
Typische Probleme ohne Datenplattform sind:
- mehrere Versionen derselben Kennzahl
- uneinheitliche Begriffe für Kunden, Produkte oder Zeiträume
- nicht synchronisierte Datenstände
Eine Datenplattform sorgt dafür, dass KI-Modelle auf eine konsistente Sicht der Realität zugreifen – nicht auf fragmentierte Teilbilder.
Historisierte Strukturen als Grundlage für Lernen
KI lebt von historischen Daten. Prognosen, Anomalieerkennung oder Simulationen setzen voraus, dass Veränderungen über die Zeit nachvollziehbar sind. In vielen operativen Systemen werden Daten jedoch überschrieben oder nur als aktueller Stand gespeichert.
Ohne strukturierte Historisierung kann KI:
- keine belastbaren Trends erkennen
- Ursachen nicht von Zufällen unterscheiden
- kurzfristige Schwankungen nicht einordnen
Eine Datenplattform stellt sicher, dass Daten versioniert, historisiert und reproduzierbar vorliegen. Erst dadurch wird maschinelles Lernen überhaupt sinnvoll einsetzbar.
Klare Kennzahlendefinitionen statt impliziter Logiken
KI-Modelle benötigen eindeutige Zielgrößen. Wenn Kennzahlen nicht klar definiert sind oder ihre Berechnung implizit in Reports oder Skripten verborgen liegt, entstehen falsche Optimierungsziele.
Beispiele aus der Praxis:
- Umsatz wird brutto und netto vermischt
- Kunden werden je nach Bereich unterschiedlich gezählt
- Zeiträume sind nicht eindeutig abgegrenzt
Eine Datenplattform verankert Kennzahlen zentral und transparent. KI-Modelle lernen damit auf einer klaren fachlichen Grundlage – nicht auf Annahmen oder impliziten Logiken.
Warum reine Automatisierungs- und Integrations-Tools nicht ausreichen
Im Zuge des KI-Hypes entstehen zunehmend Lösungen, die versprechen, Daten „einfach von A nach B zu schieben“ und darauf KI-Logiken aufzusetzen. Diese Tools automatisieren zwar Prozesse, ersetzen aber keine Datenplattform.
Die Risiken solcher Ansätze sind erheblich:
- Aufbau neuer Schatten-IT
- fehlende Governance und Zugriffskontrolle
- nicht nachvollziehbare Datenflüsse
- rechtliche und sicherheitsrelevante Probleme
Statt Ordnung zu schaffen, wird die Komplexität erhöht. KI-Anwendungen greifen dann auf Daten zu, deren Herkunft, Qualität und Bedeutung unklar ist.
Datenplattform als Voraussetzung für verantwortungsvolle KI
Eine Datenplattform ist keine Garantie für erfolgreiche KI – aber sie ist eine zwingende Voraussetzung. Sie stellt sicher, dass KI-Modelle auf einer stabilen, konsistenten und nachvollziehbaren Datenbasis arbeiten.
Erst wenn:
- Daten zentral konsolidiert
- historisiert
- fachlich eindeutig definiert
sind, kann KI ihr Potenzial entfalten. Alles andere führt zu scheinbarer Automatisierung mit hohem Risiko.
Fazit: KI ist kein Shortcut
KI ist kein Abkürzungsweg um fehlende Datenstrukturen. Sie verstärkt, was bereits vorhanden ist – im Guten wie im Schlechten. Unternehmen, die ohne Datenplattform auf KI setzen, laufen Gefahr, falsche Entscheidungen schneller und automatisierter zu treffen.
Eine saubere Datenplattform ist daher kein Hindernis auf dem Weg zu KI, sondern ihr notwendiges Fundament.
Lösungsperspektive: Datenplattformen strategisch aufbauen
Nach der Analyse der typischen Herausforderungen wird deutlich: Der Erfolg einer Datenplattform entscheidet sich weniger an einzelnen Features, sondern an der Art und Weise, wie sie aufgebaut und in die Gesamtstrategie eingebettet wird. Unternehmen benötigen keinen weiteren isolierten Technologiestack, sondern eine Plattform, die strukturiertes Vorgehen ermöglicht und gleichzeitig flexibel genug ist, um mit dem Geschäft zu wachsen.
Eine Lösungsperspektive besteht darin, den Aufbau der Datenplattform methodisch, schrittweise und use-case-orientiert anzugehen. Plattformen wie bimanu setzen genau an dieser Stelle an, indem sie technische Komplexität reduzieren und zugleich eine saubere Datenarchitektur fördern.
Strukturierter Aufbau einer zentralen Datenbasis
Ein zentraler Erfolgsfaktor ist der strukturierte Aufbau einer gemeinsamen Datenbasis. Statt Daten punktuell für einzelne Reports oder Projekte aufzubereiten, wird von Beginn an eine konsistente Grundlage geschaffen, die langfristig tragfähig ist.
Das bedeutet:
- zentrale Ablage relevanter Unternehmensdaten
- klare Trennung zwischen Rohdaten, modellierten Daten und Auswertungsschichten
- einheitliche Definitionen für zentrale Geschäftsobjekte
Ein solcher Aufbau verhindert, dass mit jedem neuen Anwendungsfall neue Datensilos entstehen. Die Datenbasis wächst kontrolliert und bleibt auch bei steigender Komplexität überschaubar.
Automatisierte Datenmodellierung statt manueller Einzellösungen
Ein häufiger Engpass klassischer Datenplattform-Projekte ist die manuelle Datenmodellierung. Sie ist zeitintensiv, fehleranfällig und stark von spezialisiertem IT-Know-how abhängig. Gleichzeitig ist sie essenziell für Konsistenz, Historisierung und Wiederverwendbarkeit von Daten.
Moderne Plattformansätze unterstützen daher eine automatisierte, methodisch geführte Datenmodellierung. Fachliche Anforderungen werden strukturiert in Datenmodelle überführt, ohne dass jede Änderung ein individuelles Entwicklungsprojekt auslöst.
Der Nutzen liegt auf der Hand:
- kürzere Implementierungszeiten
- weniger Abhängigkeit von Spezialwissen
- bessere Nachvollziehbarkeit von Änderungen
Datenarchitektur wird so nicht zum Engpass, sondern zu einem stabilen Fundament für weiteres Wachstum.
Klare Trennung von Datenarchitektur und BI-Frontend
Ein weiterer strategischer Aspekt ist die saubere Trennung zwischen Datenarchitektur und Frontend-Werkzeugen. In vielen Unternehmen sind Datenlogik und Visualisierung eng miteinander verknüpft. Kennzahlen entstehen direkt im BI-Tool, Berechnungen sind schwer nachvollziehbar und kaum wiederverwendbar.
Eine Datenplattform verfolgt bewusst einen anderen Ansatz. Die fachliche Logik liegt unterhalb der Visualisierung – zentral, dokumentiert und versionierbar. BI-Tools greifen lediglich auf diese vorbereiteten Strukturen zu.
Das bringt mehrere Vorteile:
- Austausch oder Ergänzung von BI-Tools ohne Architekturbruch
- einheitliche Kennzahlen über alle Auswertungen hinweg
- geringerer Pflegeaufwand bei Änderungen
BI wird damit vom Datenlieferanten zum reinen Nutzungskanal.
Schnelle erste Use Cases ohne langfristige IT-Projekte
Strategischer Aufbau bedeutet nicht, monatelang zu planen, bevor erste Ergebnisse sichtbar werden. Im Gegenteil: Erfolgreiche Datenplattform-Projekte kombinieren langfristige Architekturziele mit schnellen, greifbaren Use Cases.
Plattformen wie bimanu unterstützen diesen Ansatz, indem sie:
- einen schnellen Einstieg mit klar abgegrenzten Anwendungsfällen ermöglichen
- technische Grundstrukturen im Hintergrund vorbereiten
- iterative Erweiterung ohne Neuentwicklung erlauben
So entstehen früh messbare Mehrwerte, während die Plattform im Hintergrund systematisch wächst. Der Aufbau erfolgt evolutionär statt als Großprojekt.
Datenplattform als Enabler, nicht als Strategieersatz
Ein entscheidender Punkt bleibt dabei zentral:
Eine Plattform ersetzt keine Datenstrategie.
Sie kann keine fachlichen Ziele definieren, keine Verantwortlichkeiten festlegen und keine Governance-Entscheidungen treffen. Was sie jedoch leisten kann, ist die konsequente Umsetzung einer bestehenden Strategie – strukturiert, skalierbar und technisch sauber.
Unternehmen, die ihre Datenplattform als strategisches Werkzeug begreifen, schaffen damit die Voraussetzung, datengetriebene Initiativen dauerhaft und kontrolliert umzusetzen – unabhängig davon, ob der Fokus auf Reporting, Automatisierung oder KI liegt.
Fazit und Ausblick
Die zentrale Erkenntnis dieses Beitrags lässt sich klar zusammenfassen:
Eine Datenplattform ist kein IT-Projekt, sondern eine strategische Investition.
Unternehmen, die den Aufbau einer Datenplattform ausschließlich als technische Aufgabe verstehen, laufen Gefahr, ihre eigentlichen Potenziale zu verfehlen. Es geht nicht primär um Server, Cloud-Services oder Werkzeuge, sondern um die Frage, wie Informationen im Unternehmen entstehen, genutzt und weiterentwickelt werden. Datenplattformen bilden das strukturelle Rückgrat dieser Entwicklung.
Die Kernthese: Datenplattformen schaffen Steuerungsfähigkeit
Eine funktionierende Datenplattform ermöglicht es Unternehmen, Daten konsistent, nachvollziehbar und skalierbar zu nutzen. Sie schafft Ordnung in gewachsenen Systemlandschaften, verbindet Fachbereiche über gemeinsame Definitionen hinweg und legt die Grundlage für fundierte Entscheidungen.
Damit wird die Datenplattform zu einem strategischen Steuerungsinstrument – vergleichbar mit einem modernen ERP-System oder einer tragfähigen Prozessarchitektur. Ihr Nutzen entfaltet sich nicht punktuell, sondern über Jahre hinweg.
Die Gegenposition: „Für uns reicht ein BI-Tool“
In vielen Organisationen ist dennoch die Ansicht verbreitet, dass ein leistungsfähiges BI-Tool ausreicht. Dashboards liefern schnelle Einblicke, Reports lassen sich flexibel gestalten, und erste Erfolge sind oft schnell sichtbar.
Diese Sichtweise ist nachvollziehbar – greift jedoch zu kurz. BI-Tools beantworten in erster Linie die Frage, wie Daten dargestellt werden. Sie lösen jedoch nicht das zugrunde liegende Problem einer fragmentierten Datenbasis. Ohne konsistente Datenarchitektur bleibt jedes Dashboard abhängig von individuellen Datenlogiken, manuellen Aufbereitungen oder impliziten Annahmen.
Solange sich der Fokus auf reine Visualisierung beschränkt, mag dieser Ansatz funktionieren. Spätestens dann, wenn Unternehmen mehr wollen als rückblickendes Reporting, zeigen sich die Grenzen.
Warum das zu kurz greift
Sobald Themen wie Automatisierung, Advanced Analytics oder KI ins Spiel kommen, wird eine stabile Datenplattform zur Voraussetzung. Diese Anwendungsfälle benötigen:
- konsistente, zentral gepflegte Daten
- historisierte Strukturen
- klar definierte Kennzahlen und Geschäftslogiken
Ohne diese Grundlage entstehen hohe Risiken: falsche Prognosen, nicht nachvollziehbare Entscheidungen und wachsende Komplexität. Der vermeintliche Zeitgewinn durch das Überspringen der Datenplattform kehrt sich dann schnell in zusätzlichen Aufwand und Vertrauensverlust um.
Eine Datenplattform ist damit kein „Overengineering“, sondern die notwendige Basis für Skalierung – technisch wie organisatorisch.
Ausblick: Wettbewerbsvorteile durch saubere Datenarchitektur
Der Blick nach vorn zeigt, dass Datenlandschaften weiter an Bedeutung gewinnen werden. Neue Datenquellen, steigende Anforderungen an Transparenz und der zunehmende Einsatz von KI werden Unternehmen vor immer komplexere Aufgaben stellen.
Unternehmen, die heute in eine saubere, methodisch aufgebaute Datenarchitektur investieren, verschaffen sich einen nachhaltigen Vorteil:
- sie können neue Anforderungen schneller umsetzen
- sie bleiben unabhängig von einzelnen Tools oder Trends
- sie schaffen Vertrauen in datenbasierte Entscheidungen
Der eigentliche Wettbewerbsvorteil entsteht dabei nicht durch die jeweils neueste Technologie, sondern durch die Fähigkeit, Daten strukturiert, konsistent und strategisch zu nutzen.
Eine Datenplattform ist damit kein kurzfristiges Projekt, sondern eine langfristige Grundlage für unternehmerische Handlungsfähigkeit – heute und in Zukunft.

Häufige Fragen – Datenplattformen als Fundament für BI und KI
Was ist eine Datenplattform – und woran erkennt man, dass man (noch) keine hat?
Eine Datenplattform ist die technische und organisatorische Umgebung, mit der Unternehmen Daten aus verschiedenen Quellen zentral erfassen, strukturiert speichern, qualitätsgesichert aufbereiten und für Analysen, Automatisierung und KI nutzbar machen. Entscheidend ist: Eine Datenplattform ist nicht „ein Tool“, sondern ein durchgängiger Ansatz vom Datenzufluss bis zur Nutzung.
Dass ein Unternehmen noch keine echte Datenplattform hat, erkennt man oft an typischen Symptomen:
- Es gibt mehrere „Wahrheiten“ für dieselbe Kennzahl (z. B. Umsatz, Marge, Kundenanzahl).
- Reports entstehen durch manuelle Exporte und Excel-Zusammenführungen.
- Datenlogik steckt im BI-Tool (Measures, Transformationen), nicht in einer zentralen Datenbasis.
- Neue Anforderungen dauern lange, weil jede Abteilung eigene Datenwege aufgebaut hat.
- KI-Projekte scheitern an Datenqualität, fehlender Historie oder unklaren Definitionen.
Eine echte Datenplattform schafft eine Single-Point-of-Truth-Logik: Daten und Definitionen werden zentral gepflegt und sind für verschiedene Auswertungen wiederverwendbar.
Worin unterscheidet sich eine Datenplattform von Data Warehouse, Data Lake und BI-Tool?
Die Begriffe werden häufig vermischt. Der Unterschied liegt im Umfang und im Zweck:
- Data Warehouse: Stark strukturiert, optimiert für Reporting und analytische Abfragen. Sehr wertvoll, aber meist nur ein Teil der Gesamtlösung.
- Data Lake: Flexibel, kann große Mengen Rohdaten speichern (auch unstrukturiert). Ohne zusätzliche Struktur und Governance wird er schnell zum „Data Swamp“ (Daten sind da, aber schwer nutzbar).
- BI-Tool: Visualisiert und analysiert Daten, speichert sie aber nicht als zentrale, konsistente Basis. Es ist die Darstellungsschicht.
Eine Datenplattform verbindet diese Bausteine und ergänzt sie um kritische Fähigkeiten:
- Datenintegration und Datenpipelines
- Datenmodellierung und Historisierung
- Qualitätsmanagement und Governance
- Bereitstellung für BI, Advanced Analytics und KI
Kurz gesagt: Warehouse/Lake/BI sind Bauteile – die Datenplattform ist das System, das diese Bauteile in einen stabilen Prozess überführt.
Warum liefern Unternehmen oft widersprüchliche Reports – obwohl sie „gute Tools“ einsetzen?
Widersprüche entstehen selten, weil ein BI-Tool „schlecht“ ist. Sie entstehen, weil die zugrunde liegende Datenbasis nicht konsolidiert und nicht standardisiert ist. Häufige Ursachen:
- Unterschiedliche Datenquellen: Vertrieb nutzt CRM, Controlling nutzt ERP, Marketing nutzt Plattformdaten – ohne gemeinsame Harmonisierung.
- Unterschiedliche Definitionen: „Kunde“ kann je nach System etwas anderes bedeuten (aktive Kunden, Rechnungsempfänger, Leads).
- Transformationen im BI-Tool: Wenn Datenbereinigung, Joins und Kennzahlenberechnung in jedem Dashboard anders gebaut sind, entstehen zwangsläufig Abweichungen.
- Keine Historie: Wenn Daten überschrieben werden, kann niemand mehr nachvollziehen, warum Zahlen sich geändert haben.
Eine Datenplattform reduziert diese Risiken, indem sie Datenlogik zentralisiert, Kennzahlen standardisiert und Daten versionierbar/historisiert bereitstellt.
Welche konkreten Geschäftsvorteile bringt eine Datenplattform – jenseits von „besseren Dashboards“?
Der Nutzen geht deutlich über Reporting hinaus. Typische Effekte:
- Schnellere Entscheidungen: Aktuelle, vergleichbare Kennzahlen reduzieren Abstimmungen und Entscheidungsloops.
- Weniger manuelle Arbeit: Weniger Excel-Pipelines, weniger Copy/Paste, weniger „Report-Basteln“.
- Stabilere Prozesse: Automatisierte Datenflüsse verringern Fehler durch manuelle Übergaben.
- Skalierbarkeit: Neue Standorte, Gesellschaften oder Systeme können strukturiert angebunden werden.
- Bessere Zusammenarbeit: Fachbereiche sprechen über dieselben Begriffe und Kennzahlen.
- Voraussetzung für Automatisierung/KI: KI benötigt konsistente, historisierte Daten und klare Zielgrößen.
Der eigentliche Wert entsteht, wenn Daten nicht nur „sichtbar“, sondern steuerungsrelevant werden – z. B. in Logistik, Vertrieb, Produktion oder Finance.
Was bedeuten „Storage & Compute getrennt“ und „Elastizität“ – und warum ist das wichtig?
Moderne Datenplattformen entkoppeln Speicher (Storage) und Rechenleistung (Compute):
- Daten können kostengünstig und langfristig gespeichert werden.
- Rechenleistung wird nur dann genutzt, wenn Transformationen oder Analysen laufen.
Elastizität heißt: Die Plattform kann Rechenkapazitäten dynamisch hoch- oder herunterfahren, je nach Bedarf. Das ist wichtig, weil Datenlast nicht konstant ist:
- Monats-/Jahresabschluss, Kampagnen, Peak-Zeiten erzeugen hohe Last.
- Dazwischen ist weniger Bedarf.
Der Vorteil: bessere Performance bei Bedarf, ohne dauerhaft teure Infrastruktur vorzuhalten. Gleichzeitig verbessert das Kostenkontrolle und Ressourcennutzung.
Welche Schichten hat ein moderner Datenstack – und welche Rolle spielt jede Schicht?
Ein Datenstack lässt sich als fünf Schichten verstehen:
- Speicherung & Verarbeitung: Data Lake/Warehouse/Lakehouse als Rückgrat, inkl. Historie.
- Ingestion: Anbindung von ERP, CRM, IoT, Dateien, APIs (Batch oder Echtzeit).
- Konvertierung & Modellierung: Bereinigung, Harmonisierung, fachliche Struktur (z. B. Geschäftsobjekte, Kennzahlen).
- Business Intelligence: Dashboards, Reports, Self-Service – auf konsistenter Basis.
- Analyse & Observability: Monitoring der Datenqualität, Forecasts, Anomalien, Vorbereitung für KI.
Wichtig: Sicherheit, Datenschutz und Governance wirken schichtübergreifend – nicht als „Add-on“ am Ende.
Welche typischen Use Cases profitieren besonders schnell von einer Datenplattform?
Besonders schnell profitieren Use Cases, die viele Datenquellen verbinden und operative Entscheidungen beeinflussen, zum Beispiel:
- Lieferkettensteuerung: GPS + Lager + Aufträge → Lieferzeitprognosen, Routenoptimierung, weniger Verspätungen.
- Marketing & Vertrieb: Kampagnendaten + Standort-Performance + CRM → bessere Zielgruppenansprache, messbare Wirkung.
- Finance/Controlling: ERP + Kostenstellen + Planung → schnellere Abschlüsse, konsistente KPI-Kataloge.
- Produktion/IoT: Maschinendaten + Wartung + Qualität → Anomalieerkennung, Predictive Maintenance.
Der gemeinsame Nenner: Ohne zentrale Datenbasis bleiben diese Use Cases fragmentiert, manuell oder nicht skalierbar.
Was sind die häufigsten Hürden bei der Einführung – und wie lassen sie sich entschärfen?
Die sechs Klassiker:
- Heterogene Systeme: Viele Quellen, verschiedene Formate. → Entschärfung: Priorisierung (Top-Quellen), standardisierte Schnittstellen, iteratives Onboarding.
- Schlechte Datenqualität: Dubletten, Fehlwerte. → Entschärfung: Data Profiling, klare Regeln, Verantwortlichkeiten („Data Owner“).
- Unklare Nutzung: Kein klarer Use Case. → Entschärfung: Use-Case-Backlog, Pilotprojekte, Einbindung der Fachbereiche.
- Cloud & Datenschutz: Unsicherheit über Compliance. → Entschärfung: frühe Einbindung von Datenschutz/IT-Security, Berechtigungskonzepte, Audit-Logs.
- Fehlende Historie: Daten wurden überschrieben. → Entschärfung: früh klären, welche Historie nötig ist; ggf. Altsystem-Exporte/Archive integrieren.
- Zeitdruck: „In Wochen fertig“. → Entschärfung: Quick Wins + langfristige Roadmap; Erwartungen aktiv managen.
Ein zentrales Learning: Technik ist selten der Hauptgrund für Scheitern – entscheidend sind Struktur, Governance und Change Management.
Warum scheitert KI ohne Datenplattform besonders häufig?
KI ist kein „Wissensgenerator“, sondern verarbeitet Datenmuster. Wenn Daten inkonsistent sind, lernt das Modell inkonsistente Regeln und produziert unzuverlässige Ergebnisse.
KI braucht:
- konsistente Daten: gleiche Definitionen, gleiche Schlüssel, gleiche Semantik
- historisierte Strukturen: damit Modelle Trends lernen und Ereignisse einordnen können
- klare Kennzahlen: damit Optimierungsziele eindeutig sind
Wenn Unternehmen stattdessen Daten „nur von A nach B schieben“, entstehen oft neue Datenkopien und Schatten-IT – und das erhöht Risiken (Sicherheit, Compliance, Nachvollziehbarkeit). Eine Datenplattform ist deshalb kein „Nice-to-have“ für KI, sondern die Voraussetzung für belastbare Resultate.
Wie gelingt ein pragmatischer Einstieg, ohne ein Großprojekt daraus zu machen?
Ein guter Einstieg ist weder „Big Bang“ noch Tool-Aktionismus. Bewährt hat sich ein Vorgehen in Etappen:
- Zielbild & Use Cases definieren: 2–3 priorisierte Anwendungsfälle, klare Erfolgskriterien.
- Datenquellen fokussieren: Start mit den Quellen, die den größten Nutzen liefern (oft ERP + CRM + eine weitere Quelle).
- Modellierung & Kennzahlen standardisieren: zentraler KPI-Katalog statt Kennzahlenwildwuchs.
- Quick Win liefern: erstes Dashboard/Reporting auf konsolidierter Basis – als Vertrauensanker.
- Iterativ ausbauen: weitere Quellen, Historie, Datenqualität, Observability und später KI-Use Cases.
So entsteht schnell ein sichtbarer Nutzen, während die Plattform im Hintergrund strukturiert wächst. Entscheidend ist: Die Plattform wird als langfristiges Fundament verstanden – nicht als einmaliges Projekt.