
Semantic Layer oder RAG? So bekommt KI verlässlichen Kontext aus Deinem Data Warehouse
Warum KI ohne Unternehmenskontext falsche Antworten liefert
Viele Unternehmen testen aktuell KI-Assistenten, die Fragen wie „Wie hoch war unser Umsatz im letzten Quartal in Werk 3?“ direkt aus den Unternehmensdaten beantworten sollen. In der Demo wirkt das beeindruckend, in der Praxis kommt aber schnell Ernüchterung auf, wenn dieselbe Frage in zwei Tools zwei verschiedene Zahlen liefert.
Die Ursache liegt meist nicht an der KI selbst, sondern am fehlenden Kontext. Ein Sprachmodell weiß weder, wie Dein Unternehmen „Umsatz“ definiert, noch welche Tabellen wie zusammengehören oder welche Stornos, Boni und Währungen zu berücksichtigen sind.
Typische Fehlerszenarien: falsche Kennzahlen, widersprüchliche Reports
Ein klassisches Szenario: Der Vertrieb fragt den KI-Assistenten nach dem Auftragseingang im DACH-Gebiet, das Controlling fragt nach derselben Kennzahl im BI-Tool – die Ergebnisse weichen um mehrere Prozent ab. Beide Antworten basieren auf demselben Data Warehouse, aber auf unterschiedlichen Filtern, Zeitbezügen und Stornobehandlungen.
In einem anderen Fall berechnet ein LLM aus MES-Daten die OEE pro Anlage, interpretiert aber jede Wartungspause als ungeplanten Stillstand. Das führt zu künstlich schlechten Kennzahlen und hektischen Optimierungsmaßnahmen an eigentlich stabil laufenden Linien.
Warum Sprachmodelle Tabellen, Joins und Berechnungen falsch interpretieren
Sprachmodelle sind darauf trainiert, Muster in Texten zu erkennen und plausible Antworten zu formulieren. Sie verstehen aber nicht automatisch, welche Join-Pfade in Deinem Data Warehouse korrekt sind, wie sich Auftrag, Position, Lieferung und Rechnung zueinander verhalten oder welches Granularitätsniveau für eine Kennzahl zulässig ist.
Wenn ein LLM ohne vordefinierte Semantik SQL generiert, entstehen schnell doppelte Zählungen, falsche Aggregationen oder versteckte Filterfehler. Das Modell macht nichts „Böses“ – es rät sich die passende Logik zusammen, weil ihm die fachlich korrekte Bedeutung der Daten fehlt.
Kontextarten im Überblick: Wissenskontext vs. Zahlen- und Strukturkontext
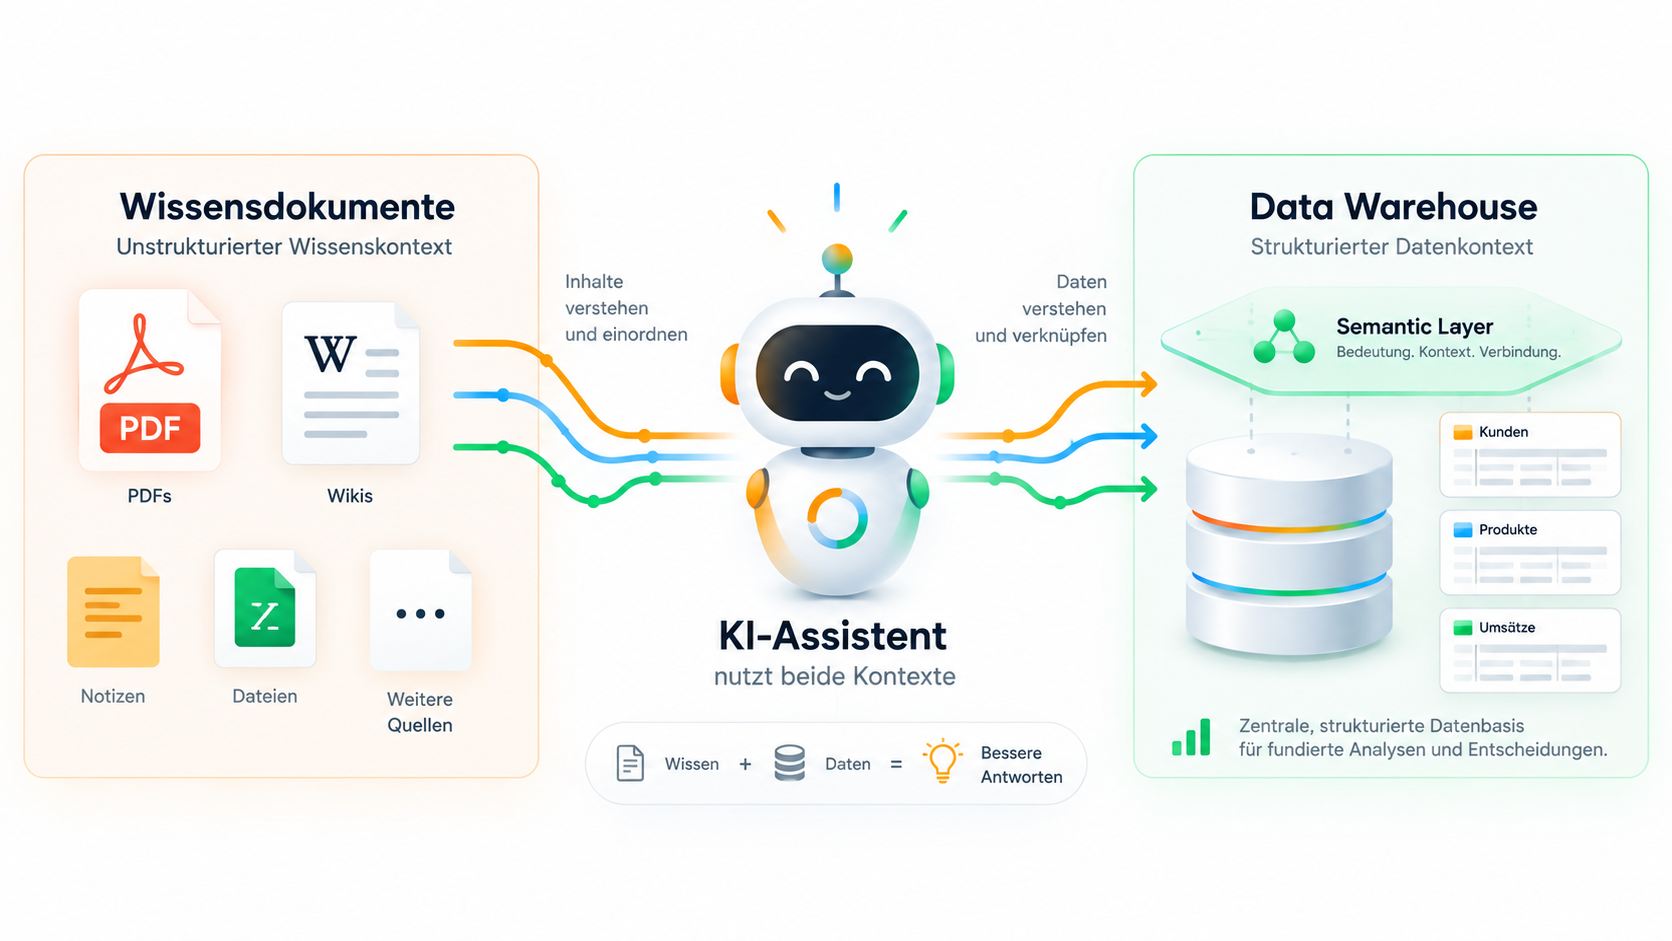
Für KI in Unternehmen gibt es zwei grundlegend verschiedene Arten von Kontext. Der erste ist Wissenskontext: Richtlinien, Anleitungen, Produktbeschreibungen, Prozessdokumentation. Hier geht es darum, Textwissen auffindbar zu machen und Antworten mit Quellen zu untermauern.
Der zweite ist Zahlen- und Strukturkontext: Wie werden KPIs definiert, wie hängen Entitäten wie Kunde, Auftrag, Werk oder Maschine zusammen, welche Zeitlogik gilt? Nur diese Art von Kontext erlaubt es, belastbare Zahlen und Kennzahlen zu berechnen.
Grundlagen: Was bedeutet „semantisch“ in Daten- und KI-Projekten?
Was heißt „semantic“ im Unternehmenskontext?
„Semantisch“ bedeutet nichts anderes als „bedeutungsbezogen“. Im Unternehmenskontext geht es darum, technische Strukturen so zu beschreiben, dass sie Deine Geschäftsrealität korrekt abbilden und von verschiedenen Teams gleich verstanden werden.
Wenn das Controlling unter „Umsatz“ etwas anderes versteht als der Vertrieb, hast Du kein gemeinsames semantisches Verständnis – selbst wenn beide auf dieselbe Tabelle zugreifen. Semantik schließt genau diese Lücke.
Was ist ein Semantik-Modell?
Ein Semantik-Modell beschreibt, welche Geschäftskonzepte es gibt, wie sie zusammenhängen und wie Kennzahlen berechnet werden. Dazu gehören Entitäten wie Kunde, Werk, Produkt oder Auftrag, ihre Beziehungen sowie Metriken wie Umsatz, Deckungsbeitrag oder OEE samt Formeln und Filtern.
Wichtig ist: Ein Semantik-Modell ist nicht nur Dokumentation in einem Wiki. In modernen Umgebungen ist es ausführbar – also so hinterlegt, dass BI-Tools, APIs oder KI-Assistenten direkt darauf zugreifen und Zahlen konsistent berechnen können.
Abgrenzung: Semantic Layer, Datenmodell und Data Catalog
Das Datenmodell im Warehouse legt fest, wie Tabellen strukturiert sind und welche Schlüssel sie verbinden. Es arbeitet auf technischer Ebene und beantwortet die Frage, wo welche Daten liegen und wie sie gespeichert werden.
Ein Data Catalog verwaltet Metadaten, beschreibt Tabellen und Felder, dokumentiert Verantwortlichkeiten und Datenherkunft. Er schafft Transparenz, ändert aber an der Berechnung einer Kennzahl noch nichts.
Der Semantic Layer sitzt darüber. Er verbindet das technische Modell mit der Geschäftssicht, definiert Kennzahlen, Dimensionen, Joins und Filterlogiken und stellt sie konsistent über verschiedene Tools bereit.
Was ist ein Semantic Layer – und wie funktioniert er im Data Warehouse?
Definition: Semantische Schicht über strukturierten Unternehmensdaten
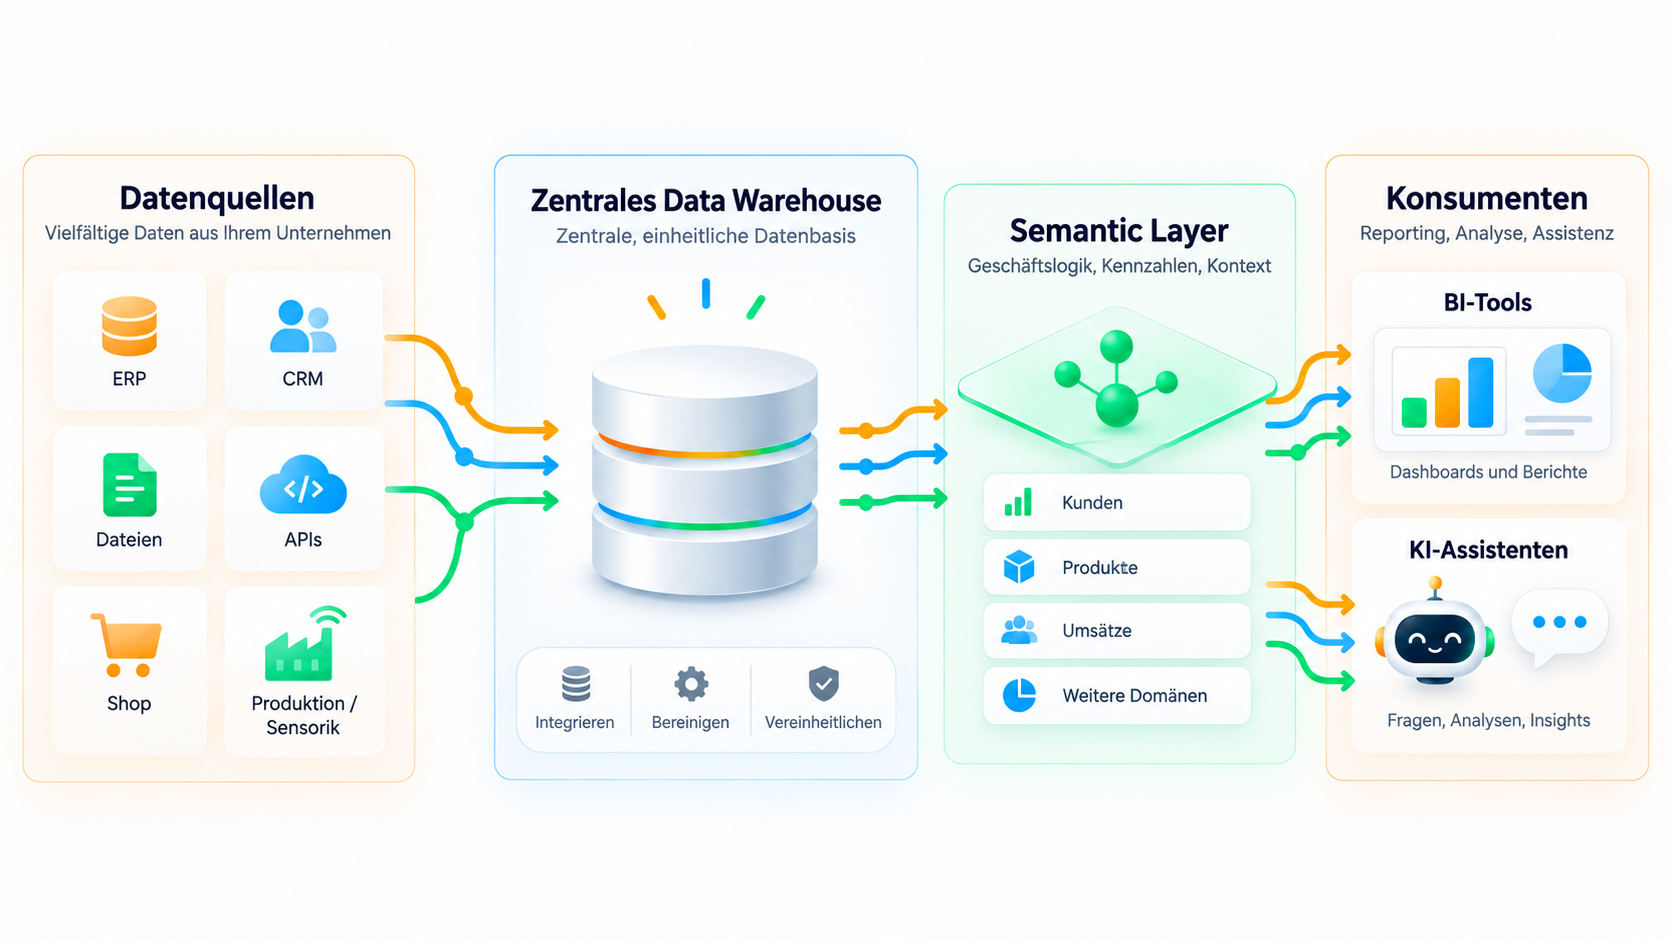
Ein Semantic Layer ist eine Schicht zwischen Deinem Data Warehouse und den konsumierenden Anwendungen wie BI-Tools, Fachanwendungen oder KI-Assistenten. In dieser Schicht werden fachliche Begriffe, Kennzahlen, Dimensionen und Berechnungen zentral definiert.
Statt dass jedes Dashboard seine eigene Umsatzformel enthält, gibt es genau eine Definition im Semantic Layer. Alle Tools, die darauf zugreifen, bekommen dieselbe Logik – unabhängig davon, ob die Abfrage aus Power BI, einem Notebook oder einem Chatbot kommt.
Kernaufgaben: Kennzahlen, Berechnungen und Geschäftslogik zentral definieren
Der Semantic Layer kümmert sich darum, dass Kennzahlen eindeutig und belastbar sind. Er legt fest, welche Basisdaten verwendet werden, wie gefiltert wird, welche Zeitbezüge gelten und wie Währungen, Stornos oder interne Verrechnungen berücksichtigt werden.
Darüber hinaus regelt er, welche Dimensionen zur Verfügung stehen, wie sie miteinander verknüpft werden dürfen und auf welchem Granularitätsniveau Auswertungen zulässig sind. So wird verhindert, dass beliebige Joins zu scheinbar plausiblen, aber falschen Ergebnissen führen.
Architektur: Semantic Layer in der modernen Datenlandschaft
In einer typischen Architektur liegt unter dem Semantic Layer ein Data Warehouse oder Lakehouse, das Daten aus ERP, MES, CRM, Webshop und weiteren Systemen integriert. Darüber sitzen BI-Tools, Fachanwendungen und KI-Services, die ihre Fragen an den Semantic Layer stellen.
Technisch kann der Semantic Layer in einem BI-Tool integriert sein, als eigenständige Middleware laufen oder direkt im Analytics-Engineering-Stack (zum Beispiel über einen Metrics Store) umgesetzt werden. Entscheidend ist, dass er als zentrale Stelle für Kennzahlenlogik fungiert.
Relation zu BI-Tools: Warum der Semantic Layer unterhalb von Power BI & Co. sitzt
Viele Unternehmen definieren Kennzahlen direkt im BI-Tool, etwa in Power BI, Qlik oder Tableau. Das funktioniert für einzelne Dashboards, führt aber schnell zu Parallelwelten, wenn mehrere Teams eigene Versionen derselben Kennzahl pflegen.
Ein Semantic Layer rückt diese Logik eine Ebene nach unten. BI-Tools visualisieren weiterhin, greifen aber auf zentrale Definitionen zu. Damit wird vermieden, dass KI-Assistenten und Reports unterschiedliche Berechnungen verwenden, obwohl beide „Umsatz“ anzeigen.
Vorteile für Governance, Self-Service BI und KI-Anwendungen
Aus Governance-Sicht schafft der Semantic Layer klare Zuständigkeiten für Kennzahlen, Versionierung von Definitionen und nachvollziehbare Änderungen. Fachbereiche wissen, welche Kennzahl ab wann mit welcher Logik gilt.
Für Self-Service BI bedeutet das: Fachanwender können flexibel analysieren, ohne versehentlich neue KPI-Varianten zu erfinden. KI-Anwendungen wiederum nutzen denselben Pool an zertifizierten Kennzahlen und liefern dadurch reproduzierbare Antworten.
| Aspekt | Ohne Semantic Layer | Mit Semantic Layer |
|---|---|---|
| KPI-Definition | In jedem Report separat gepflegt, oft abweichend. | Zentral definiert, einmal gepflegt, überall genutzt. |
| KI-Antworten auf Zahlenfragen | Nicht reproduzierbar, je nach Abfrage anders. | Reproduzierbar, da die Berechnung immer auf derselben Metrikdefinition basiert. |
| Governance | Kaum nachvollziehbar, wer was geändert hat. | Versioniert, mit Verantwortlichen und Change-Historie. |
| Self-Service BI | Viele Varianten derselben Kennzahl, „Zahlenkriege“. | Gemeinsame Basis, Diskussion über Inhalte statt über Definitionen. |
Was ist RAG (Retrieval-Augmented Generation) – und wofür ist es gemacht?
Funktionsweise: Ähnlichkeitssuche plus generatives Sprachmodell
RAG steht für Retrieval-Augmented Generation. Vereinfacht gesagt: Ein System sucht zunächst in einem Dokumentenbestand nach relevanten Textpassagen und übergibt diese dann an ein Sprachmodell, das daraus eine Antwort formuliert.
Die Suche erfolgt typischerweise über Vektoren, also numerische Repräsentationen von Textbedeutungen. Das ermöglicht es, inhaltlich passende Stellen zu finden, auch wenn Begriffe nicht wortgleich vorkommen.
Stärken von RAG: Wissensfragen, Dokumentation, Richtlinien
RAG ist ideal, wenn Du Fragen zu unstrukturiertem Wissen beantworten willst: „Welche Sicherheitsvorschriften gelten an Anlage X?“, „Was steht im Servicevertrag zu Reaktionszeiten?“ oder „Wie ist unser Reklamationsprozess definiert?“.
Hier spielt RAG seine Stärke aus, weil es direkt in Handbüchern, Richtlinien, Verträgen oder Wikis nachschlagen kann und Antworten mit konkreten Textstellen untermauert. Das reduziert Halluzinationen bei Wissensfragen deutlich.
Typische Quellen: PDFs, Wikis, Handbücher, E-Mails
In der Praxis indexieren Unternehmen mit RAG vor allem PDFs (Verträge, technische Datenblätter, Betriebsanleitungen), Intranet-Artikel, Wiki-Seiten und teilweise auch E-Mail- oder Ticketsysteme. All diese Quellen liegen überwiegend in Textform vor.
Für solche Inhalte ist RAG oft besser geeignet als reine Volltextsuche, weil es Bedeutungen statt nur Stichworte abgleicht und damit auch semantisch ähnliche Formulierungen findet.
Warum RAG mit Tabellen, Metriken und Berechnungen kämpft
Sobald es um konkrete Zahlen aus Tabellen, Kennzahlenberechnungen oder zeitliche Aggregationen geht, stößt RAG an Grenzen. Zwar lassen sich auch Tabellen in Vektoren abbilden, doch Ähnlichkeitssuche sagt nichts darüber aus, ob die gefundenen Zeilen korrekt aggregiert oder gefiltert werden.
Ein RAG-System kann Dir beispielsweise die Definition von „Deckungsbeitrag“ aus einem Controlling-Handbuch liefern. Für die konkrete Berechnung in Deinem aktuellen Datenstand braucht es aber Zugriff auf strukturierte Daten und eine klare Semantik – genau dort kommt der Semantic Layer ins Spiel.
Semantic Layer vs. RAG: Der systematische Vergleich
Welche Fragen welcher Ansatz besser beantwortet
Wenn Du „Wie viel?“, „Wie oft?“, „Seit wann?“ oder „Mit welcher Entwicklung?“ fragst, bist Du fast immer im Bereich des Semantic Layers. Hier geht es um Zahlen, Kennzahlen, Zeitreihen und Vergleiche, die sauber aus strukturierten Daten berechnet werden müssen.
Wenn Du „Wie ist geregelt, dass…?“, „Wo steht, dass…?“ oder „Welche Schritte sind vorgesehen?“ fragst, arbeitet RAG auf dokumentiertem Wissen. Hier geht es weniger um Berechnung, sondern darum, Textstellen zu finden, zusammenzufassen und verständlich zu formulieren.
Vergleichstabelle: Datenarten, Genauigkeit, Governance, typische Use Cases
| Kriterium | Semantic Layer | RAG |
|---|---|---|
| Datenart | Strukturierte Daten im DWH/Lakehouse (Tabellen, KPIs). | Unstrukturierte oder halbstrukturierte Texte (PDFs, Wikis, E-Mails). |
| Typische Fragen | „Wie hoch ist der Umsatz Q2 nach Werk und Produktgruppe?“ | „Welche Qualitätsrichtlinien gelten in Werk 3?“ |
| Genauigkeit bei Kennzahlen | Hoch, da auf definierter KPI-Logik basierend. | Begrenzt, da nur Definitionen gefunden, aber nicht berechnet werden. |
| Governance | Versionierbare KPIs, klare Owner, Freigabeprozesse. | Versionierung von Dokumenten, aber keine KPI-Historisierung. |
| Rolle im KI-Stack | Verlässliche Zahlengrundlage für KI-Antworten. | Zusätzlicher Textkontext und Erklärungen. |
Performance und Skalierung: Verlangsamt ein Semantic Layer die Abfrage?
Ein sauber implementierter Semantic Layer muss Abfragen nicht langsamer machen. In vielen Fällen kann die Performance sogar besser werden, weil wiederverwendbare Joins, voroptimierte Aggregationen und einheitliche Filterlogiken genutzt werden, statt immer wieder neue, ineffiziente Queries zu erzeugen.
Entscheidend ist die technische Umsetzung im Zusammenspiel mit Deinem Data Warehouse. Wenn der Semantic Layer eng an das physische Modell angebunden ist und Caching sinnvoll eingesetzt wird, bleibt auch ein KI-Chat performant.
Kann man mehrere Semantic Layer parallel betreiben?
In der Praxis existieren oft mehrere semantische Schichten nebeneinander, etwa eine im BI-Tool und eine im Analytics-Stack. Technisch ist das möglich, erhöht aber die Komplexität und das Risiko widersprüchlicher Definitionen.
Für den Mittelstand ist meist sinnvoller, ein zentrales, domänenübergreifendes Semantik-Fundament zu etablieren und dieses dann über verschiedene Tools hinweg zu nutzen, statt mehrere konkurrierende Schichten aufzubauen.
Praxisorientierte Leitfragen: Welcher Ansatz passt zu meinem Unternehmen?
Wenn Deine dringendsten Probleme in der Beantwortung von Kennzahlenfragen, im Reportingdruck und in „Zahlenkriegen“ zwischen Fachbereichen liegen, solltest Du mit einem Semantic Layer beginnen und RAG später für Wissensfragen ergänzen.
Wenn Du bereits eine hohe BI-Reife hast, aber Wissen aus Verträgen, Richtlinien oder technischen Dokumentationen schwer zugänglich ist, kann RAG schnell Mehrwert liefern – vorausgesetzt, Zahlenfragen bleiben weiterhin dem Data Warehouse und dem Semantic Layer vorbehalten.
Warum RAG bei Kennzahlen und Berechnungen an Grenzen stößt
Ähnlichkeitssuche auf Tabellen: Warum semantische Nähe keine korrekten Zahlen garantiert
Vektorsuche bewertet, wie ähnlich sich Inhalte inhaltlich sind. Für freie Texte ist das hilfreich, bei Tabellen ist es gefährlich. Nur weil zwei Zeilen oder Spalten semantisch ähnlich wirken, heißt das nicht, dass sie gemeinsam aggregiert oder verglichen werden dürfen.
Ein Beispiel: Auftragspositionen und Rechnungspositionen können sich sehr ähnlich lesen. Wenn ein KI-System diese ohne klar definierte Struktur zusammenfasst, werden Umsätze doppelt gezählt oder Stornos falsch behandelt – mit direkten Auswirkungen auf Deine Steuerung.
Text-to-SQL ohne Semantik: falsche Joins, Filter und Aggregationen
Viele „Chat with your data“-Ansätze lassen das LLM direkt SQL-Statements generieren. Ohne Semantic Layer kennt das Modell aber nur Tabellen- und Spaltennamen, nicht die gültigen Join-Pfade, Kardinalitäten oder zulässigen Filter.
Das Ergebnis sind häufig Queries, die zwar syntaktisch korrekt, aber fachlich falsch sind. Gerade im Mittelstand mit vielen Spezialfällen, Sonderregelungen und historisch gewachsenen Strukturen ist das Risiko hier besonders hoch.
Unterschiedliche Kennzahlendefinitionen in Reports: das stille Risiko für KI
Wenn Kennzahlen in jedem Report separat definiert sind, kann ein KI-Assistent keine einheitliche Wahrheit liefern. Er greift je nach Datenquelle auf unterschiedliche Logiken zu, ohne dass Nutzer das auf den ersten Blick erkennen.
Das führt zu Situationen, in denen ein CFO aus dem Dashboard eine Zahl abliest, der KI-Assistent eine andere nennt und beide formal recht haben – aber auf verschiedenen Definitionen basieren. Vertrauen in datenbasierte Entscheidungen geht so schnell verloren.
Versionierung und Historie: warum RAG keine saubere Zeitlogik ersetzt
Kennzahlen ändern sich im Laufe der Zeit: neue IFRS-Regeln, veränderte Kostenstellenstrukturen, angepasste OEE-Definitionen. Ein Semantic Layer kann diese Änderungen versionieren und klar markieren, ab wann welche Definition gilt.
RAG kann zwar frühere Dokumente zitieren, aber es kann keine konsistente Historisierung von Kennzahlen über Datenstände hinweg garantieren. Für Audits, regulatorische Anforderungen und Trendanalysen ist das ein wesentliches Risiko.
Warum ein Semantic Layer für KI-Anwendungen im Mittelstand unverzichtbar wird
KI muss dieselben Kennzahlen verstehen wie Controlling und Geschäftsführung
Wenn ein KI-Assistent andere Umsatzzahlen liefert als Dein Monatsabschluss, wird er sich nie im Management etablieren. Die Grundlage für Akzeptanz ist, dass KI dieselben Kennzahlen nutzt wie Controlling, Vertrieb und Produktion.
Ein Semantic Layer sorgt dafür, dass alle – Menschen wie Systeme – auf dieselben Definitionen zugreifen. So wird KI zu einer zusätzlichen Oberfläche für bestehende Logik, nicht zu einer parallel laufenden Welt mit eigenen Regeln.
Von Rohdaten zu Geschäftsbegriffen: Wie der Semantic Layer Modelle übersetzbar macht
Ein LLM kann mit Tabellen wie „FACT_ORD_01“ oder „DIM_CUST_OLD“ wenig anfangen. Es braucht Begriffe wie Auftrag, Kunde, Region oder Werk, um Fragen sinnvoll zu formulieren und Daten korrekt zu nutzen.
Der Semantic Layer übersetzt technische Strukturen in diese Geschäftsbegriffe. So versteht ein KI-Assistent, dass „Auftragseingang nach Region“ eine Abfrage auf einer bestimmten Faktentabelle mit klar definierten Dimensionen und Filtern bedeutet.
Risikoreduktion: Falsche KPIs, Compliance-Brüche und Fehlentscheidungen vermeiden
Falsch berechnete KPIs sind nicht nur ein Schönheitsfehler. Sie führen zu falschen Investitionsentscheidungen, fehlerhaften Bonusabrechnungen oder unpassenden Produktionsanpassungen. In regulierten Bereichen können sie außerdem Compliance-Risiken erzeugen.
Mit einem Semantic Layer kannst Du nachweisen, wie eine Zahl entstanden ist, welche Datenquellen und Definitionen dahinterstehen und wer die Logik zuletzt geändert hat. Das ist auch im Kontext wachsender Transparenz- und Dokumentationspflichten wichtig.
Beispiele für KI-Fragen, die ohne Semantic Layer schieflaufen
Eine typische Frage aus dem Vertrieb lautet: „Wie hoch ist der durchschnittliche Auftragswert im Neukundengeschäft der letzten 12 Monate in der DACH-Region?“ Ohne Semantic Layer entscheidet das LLM selbst, was „Neukunde“ bedeutet, welche Regionen dazugehören und welche Währungskurse anzusetzen sind.
In der Produktion fragen Werksleiter: „Welche Anlagen hatten im letzten Quartal die größte OEE-Verbesserung?“ Ohne klar standardisierte OEE-Definition zählt das Modell möglicherweise nur Verfügbarkeitszeiten, ignoriert aber Qualitätskomponenten – und Du optimierst auf die falsche Kennzahl.
Aufkommende Trends: Semantic Layer als Bindeglied für generative KI
In der Branche ist zunehmend von „AI Context Layers“ die Rede, die genau diese Aufgaben übernehmen: Metriken führen, unterschiedliche Sichten sichtbar machen und KI-Anwendungen mit verlässlicher Semantik versorgen. Der Semantic Layer ist der Kern dieser Schicht.
Generative KI wird damit nicht zum Ersatz für Datenmodellierung, sondern zum zusätzlichen Zugang zu einer gut gepflegten Semantik. Unternehmen, die diese Grundlage legen, können KI-Assistenten deutlich schneller und sicherer ausrollen.
Praxisbeispiel: Semantic Layer und RAG sinnvoll kombinieren
Ausgangssituation: Heterogene Systeme, manuelle Reports, KI-Pilotprojekte
Stell Dir einen industriellen Mittelständler mit mehreren Werken vor. ERP, MES, CRM und ein Shopsystem sind vorhanden, Reports entstehen aber noch stark manuell in Excel und einzelnen Power-BI-Berichten. Parallel laufen erste KI-Piloten im Service und im Vertrieb.
Der Service möchte Anleitungen und Wartungshinweise schneller finden, der Vertrieb wünscht sich einen Assistenten für Pipeline- und Umsatzfragen. Ohne klare Trennung der Kontexte droht ein KI-Projekt, das zwar nett aussieht, aber keine verlässlichen Zahlen liefert.
Use-Case 1: KI beantwortet KPI-Fragen auf Basis des Semantic Layers
Im ersten Schritt werden zentrale Kennzahlen wie Umsatz, Auftragseingang, OEE und Reklamationsquote im Semantic Layer definiert. Basis dafür ist ein harmonisiertes Data Warehouse, das die relevanten Systeme integriert.
Ein KI-Assistent wird so angebunden, dass er für Zahlenfragen ausschließlich vordefinierte Metriken nutzt. Wenn jemand „Wie entwickelt sich unser Auftragseingang im Automotive-Segment?“ fragt, ruft das System die entsprechende Kennzahl ab und gibt zusätzlich die Definition mit aus.
Use-Case 2: KI erklärt Kennzahlen mit Dokumentenwissen via RAG
Parallel wird ein RAG-System aufgebaut, das Qualitätsrichtlinien, Controlling-Handbücher und Prozessbeschreibungen indexiert. Fragt jemand „Was zählt bei uns genau in die Reklamationsquote?“, liefert der KI-Assistent sowohl die aktuelle Zahl aus dem Semantic Layer als auch einen erklärenden Auszug aus der Richtlinie.
So entsteht eine Kombination aus „Was ist die Zahl?“ und „Wie kommt sie zustande?“, ohne dass beide Logiken vermischt werden. Kennzahlen bleiben im Semantic Layer, textuelles Wissen im RAG-Index.
End-to-End-Szenario: Von der Frage im Chat bis zur geprüften Zahl im Dashboard
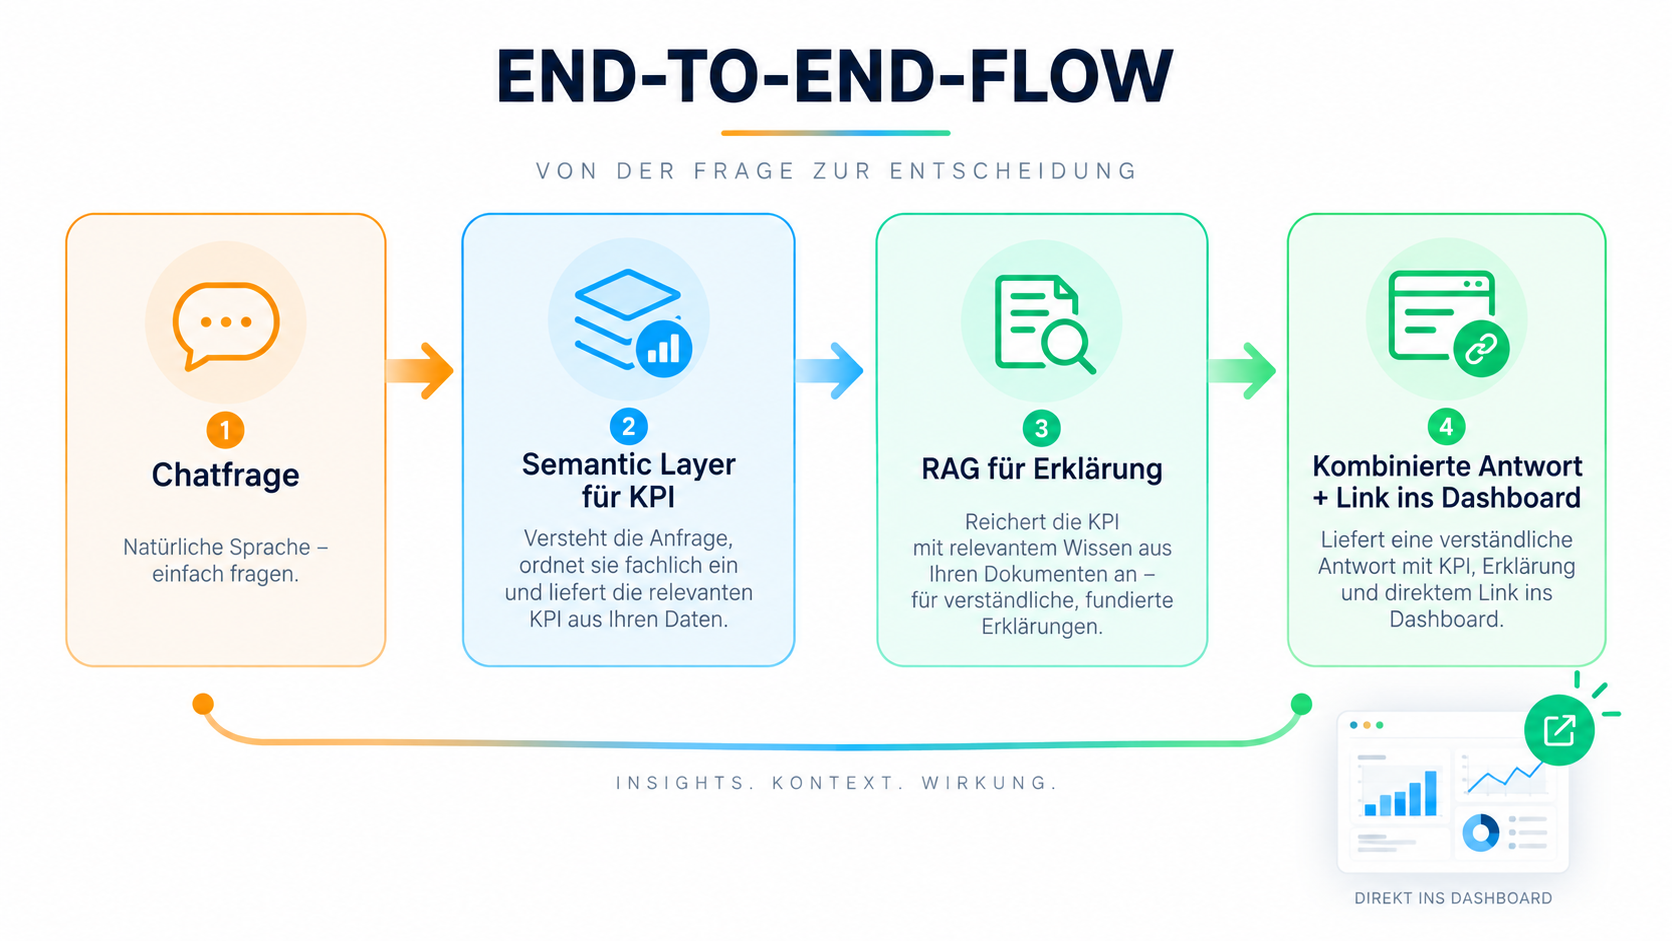
Ein Werksleiter fragt im Chat: „Zeig mir bitte die OEE-Entwicklung der letzten drei Monate für Linie 4 und erkläre die größten Abweichungen.“ Der Assistent greift zunächst auf den Semantic Layer zu, berechnet die OEE je Woche und stellt sie als Zeitreihe bereit.
Parallel durchsucht RAG Wartungsprotokolle und Schichtberichte, um Textstellen zu finden, die Stillstände oder Qualitätsprobleme erklären. Das Ergebnis ist eine Zahl mit Begründung – und ein direkter Link ins Dashboard, das auf derselben Metrikdefinition basiert.
Lernkurven und typische Stolpersteine bei der Einführung
In frühen Projekten wird RAG oft überschätzt und versucht, auch Kennzahlenprobleme über Dokumentensuche zu lösen. Hier ist es wichtig, früh eine klare Trennung zu etablieren: Zahlen kommen aus dem Data Warehouse, Erklärungen aus Dokumenten.
Ein weiterer Stolperstein ist die fehlende KPI-Governance. Ohne definierte Owner und Freigabeprozesse für Kennzahlen kann auch ein technisch sauberer Semantic Layer keine Stabilität schaffen. KI macht solche Unklarheiten nur schneller sichtbar.
Wie bimanu One den Semantic Layer für Deine KI vorbereitet
Zentrale Datenbasis: ERP, MES, CRM, Webshop & mehr automatisiert integrieren
Ein Semantic Layer kann nur so gut sein wie das Datenfundament darunter. bimanu One verbindet Deine zentralen Systeme – von ERP über MES und CRM bis zum Webshop – über vorgefertigte Konnektoren und führt sie in einem automatisierten Data Warehouse zusammen.
Damit entfällt weitgehend der Aufwand, manuell Exporte zu ziehen, Tabellen zu mappen oder Datenmodelle per Hand zu pflegen. Die technische Basis für eine semantische Schicht ist stabil und reproduzierbar vorhanden.
Einmalige Definition von Kennzahlen und Strukturen statt dutzender Einzelreports
In bimanu One werden fachliche und technische Datenmodelle per Low-Code aufgebaut und zentral verwaltet. Kennzahlenlogik liegt nicht mehr verstreut in einzelnen BI-Berichten, sondern dort, wo sie hingehört: nahe an den harmonisierten Fakten- und Dimensionstabellen.
Dashboards in Power BI, Qlik oder Tableau greifen anschließend auf dieselben Strukturen zu. So entsteht faktisch ein Semantic Layer über Deinem Data Warehouse, ohne dass jedes Tool seine eigene Semantik pflegt.
Versionierung von Stammdaten, Strukturen und Kennzahlen für saubere Historie
Änderungen an Stammdaten, Kennzahlendefinitionen oder Datenstrukturen werden in bimanu One versioniert und dokumentiert. Du kannst nachvollziehen, ab wann eine neue Logik gilt und wie sich das auf historische Auswertungen auswirkt.
Gerade im Zusammenspiel mit KI und wachsenden Regulatorik-Anforderungen ist diese Nachvollziehbarkeit entscheidend. Sie ermöglicht es, Auswertungen auch später noch sauber zu erklären.
KI- und ML-Modelle automatisiert mit produktiven Daten versorgen
bimanu One liefert nicht nur Daten für Reports, sondern auch für KI- und ML-Modelle. Modelle können direkt auf harmonisierte Fakten zugreifen und ihre Ergebnisse wieder in das Warehouse zurückschreiben, etwa in Form von Scores oder Vorhersagen.
Für einen KI-Assistenten bedeutet das: Er kann sowohl aktuelle Kennzahlen abrufen als auch Prognosen, Anomaliescores oder Churn-Wahrscheinlichkeiten nutzen – ohne zusätzliche Integrationsprojekte.
Abgrenzung zu klassischer BI-Software: Mehr als nur Visualisierung
Klassische BI-Software konzentriert sich vor allem auf Visualisierung und Reporting. bimanu One setzt tiefer an: Sie automatisiert den gesamten Weg von der Datenintegration über die Modellierung bis zur Bereitstellung für BI und KI.
Dashboards bleiben dort, wo Deine Teams sie gewohnt sind. Der Unterschied ist, dass die zugrunde liegende Semantik zentral, konsistent und KI-fähig ist – ohne zusätzliche Spezialteams für jeden neuen Use Case.
Low-Code Data Modeling und deutsche, ISO-konforme Cloud für DSGVO-Sicherheit
Gerade im Mittelstand ist Zeit das knappste Gut. bimanu One setzt deshalb auf Low-Code-Modellierung, damit auch Fachbereiche mitarbeiten können, ohne SQL-Spezialisten zu sein. Das beschleunigt den Aufbau einer semantischen Schicht deutlich.
Hosting in einer deutschen, ISO-konformen Cloud erleichtert Dir zudem die DSGVO-konforme Nutzung von BI und KI. Sensible Daten bleiben kontrollierbar, ohne auf die Vorteile moderner Plattformtechnologie zu verzichten.

Implementierung: Schritt für Schritt zum KI-fähigen Semantic Layer
1. Ziele und Fragen klären: Welche Entscheidungen soll KI unterstützen?
Bevor Du Technik auswählst, solltest Du klären, welche geschäftskritischen Fragen KI beantworten soll. Geht es um Finanzkennzahlen, Produktionsleistung, Servicequalität oder Vertriebspipeline?
Für diese Kernfragen definierst Du die wichtigsten KPIs und entscheidest, welche davon zuerst im Semantic Layer abgebildet werden müssen. So vermeidest Du, Dich in Detailkennzahlen zu verlieren.
2. Datenquellen konsolidieren und harmonisieren
Im nächsten Schritt bringst Du relevante Datenquellen in ein zentrales Data Warehouse, etwa mit einer Plattform wie bimanu One. Wichtig ist, dass IDs, Zeitachsen und Stammdaten harmonisiert werden, damit spätere Kennzahlen sauber rechnen.
Ohne diese Basis nutzt Dir der beste Semantic Layer wenig, weil er dann nur auf inkonsistenten Rohdaten aufsetzt. Die Zusammenführung sollte so weit wie möglich automatisiert und überwacht sein.
3. Zentrale Kennzahlen und Geschäftslogik definieren
Gemeinsam mit Controlling, Fachbereichen und IT legst Du fest, wie zentrale Kennzahlen berechnet werden. Dazu gehören Formeln, Filter, Zeitbezüge, Währungen und Sonderfälle wie Stornos oder interne Verrechnungen.
Diese Definitionen werden nicht nur textlich dokumentiert, sondern als ausführbare Logik im Semantic Layer hinterlegt. Jede Kennzahl bekommt einen Owner, der für Änderungen und Freigaben verantwortlich ist.
4. Semantic Layer aufbauen und mit BI-Tools verbinden
Nun implementierst Du den Semantic Layer technisch, entweder direkt im Daten-Stack oder als separate Komponente. Wichtig ist, dass BI-Tools, Notebooks und KI-Services auf dieselbe Semantik zugreifen können.
In diesem Schritt lohnt es sich, bestehende Reports schrittweise auf die neue Logik umzustellen. So stellst Du sicher, dass alte und neue Welt konsistent werden und Nutzer Vertrauen aufbauen.
5. KI-Use-Cases auf Semantic Layer und RAG abbilden
Erst wenn die Basis steht, startest Du mit KI-Use-Cases. Für Zahlenfragen nutzt Du den Semantic Layer als primäre Quelle und stellst sicher, dass das LLM nur zertifizierte Metriken verwendet.
Parallel implementierst Du RAG für Wissensfragen und erklärende Texte. Beide Stränge werden in der Nutzeroberfläche zusammengeführt, aber technisch klar voneinander getrennt.
6. Governance, Monitoring und kontinuierliche Weiterentwicklung
Ein Semantic Layer ist kein einmaliges Projekt, sondern ein lebendes System. Neue Produkte, Märkte oder Prozesse erfordern angepasste Kennzahlen, neue Datenquellen müssen integriert werden.
Etabliere deshalb einen klaren Governance-Prozess, regelmäßige Reviews und Monitoring für KPIs und KI-Antworten. So stellst Du sicher, dass Dein Kontext mit dem Geschäft mitwächst.
Fazit: Wann Semantic Layer, wann RAG – und warum die Basis im Data Warehouse liegt
Semantic Layer und RAG lösen zwei unterschiedliche, aber komplementäre Probleme. Der Semantic Layer sorgt dafür, dass Kennzahlen aus Deinem Data Warehouse konsistent, nachvollziehbar und KI-fähig sind. RAG macht Dein textbasiertes Unternehmenswissen zugänglich und erklärt, was hinter Zahlen und Prozessen steht.
Für den Mittelstand mit heterogenen Systemen und hohem Reportingdruck ist klar: Ohne stabiles Data Warehouse und Semantic Layer wird KI bei Zahlenfragen zum Risiko. Wenn die Basis steht, kannst Du RAG gezielt ergänzen und so einen Assistenten aufbauen, der beides kann – korrekte Zahlen liefern und sie verständlich erklären.
Semantic Layer, RAG und KI im Mittelstand – Häufige Fragen und Antworten
Was ist ein Semantic Layer in einfachen Worten erklärt?
Ein Semantic Layer ist eine Art Übersetzungsschicht zwischen Deinem Data Warehouse und den Fachanwendern. Er legt fest, wie Kennzahlen wie Umsatz, Deckungsbeitrag oder OEE genau berechnet werden und stellt diese Definitionen zentral für BI-Tools und KI bereit.
Statt dass jede Auswertung ihre eigene Logik mitbringt, gibt es eine gemeinsame, ausführbare Wahrheit für alle. So entstehen weniger Missverständnisse und mehr Vertrauen in Zahlen.
Worin unterscheidet sich ein Semantic Layer von einem klassischen Datenmodell?
Das Datenmodell beschreibt Tabellen, Spalten und Beziehungen auf technischer Ebene, also wie Daten gespeichert sind. Der Semantic Layer baut darauf auf und beschreibt, was diese Daten fachlich bedeuten und wie daraus Kennzahlen werden.
Du kannst ein gutes Datenmodell ohne Semantic Layer haben, aber dann entstehen Kennzahlenlogiken oft verteilt in Reports. Mit einem Semantic Layer bündelst Du diese Logik an einem zentralen Ort.
Für welche Fragen eignet sich RAG – und wann sollte ich es nicht verwenden?
RAG eignet sich für Wissensfragen zu Dokumenten: Verträge, Richtlinien, Anleitungen, Prozessbeschreibungen. Es hilft Dir, Textwissen schnell zu finden, zusammenzufassen und zu erklären.
Für konkrete Kennzahlenfragen („Wie hoch ist…?“) solltest Du RAG nicht als primäre Quelle nutzen. Hier ist der Semantic Layer im Zusammenspiel mit Deinem Data Warehouse die richtige Wahl.
Verlangsamt ein Semantic Layer die Performance meiner BI-Reports oder KI-Abfragen?
Richtig umgesetzt muss ein Semantic Layer Deine Abfragen nicht verlangsamen. Oft verbessert er die Performance, weil Abfragen standardisiert und optimiert werden, statt jedes Mal neu und ineffizient formuliert zu werden.
Wichtig ist, dass Semantic Layer und Data Warehouse abgestimmt sind und Caching oder Voraggregationen sinnvoll genutzt werden. Dann bleibt auch ein KI-Chat mit vielen Nutzern performant.
Können wir mehrere Semantic Layer für unterschiedliche Bereiche betreiben?
Du kannst für verschiedene Domänen (z. B. Finance, Produktion, Vertrieb) eigene Teilmodelle haben, die auf einem gemeinsamen Fundament aufsetzen. Technisch sind das oft Bausteine eines größeren Semantic Layers.
Mehrere komplett getrennte Semantic Layer mit eigenen Definitionen derselben Kennzahlen solltest Du vermeiden, weil sie Inkonsistenzen fördern. Besser ist eine gemeinsame Basis mit klar gekennzeichneten Sichten.
Wie starte ich mit einem Semantic Layer, wenn unsere BI-Reife noch gering ist?
Starte mit einem schlanken Data Warehouse und wenigen, klar definierten Use Cases, etwa Monatsreporting und einer zentralen OEE-Auswertung. Darauf aufbauend definierst Du eine Handvoll Kernkennzahlen im Semantic Layer.
Mit einer Plattform wie bimanu One kannst Du diesen Weg schrittweise gehen, ohne direkt ein großes Projekt aufzusetzen. Wichtig ist, früh Ownership und Governance zu klären.
Welche Voraussetzungen braucht mein Data Warehouse, damit KI verlässliche Zahlen liefert?
Dein Data Warehouse sollte zentrale Systeme integrieren, saubere IDs und Zeitachsen enthalten und eine klare Trennung zwischen Fakten und Dimensionen haben. Ohne diese strukturelle Qualität wird es schwer, Kennzahlen korrekt zu rechnen.
Außerdem brauchst Du eine minimale Daten-Governance: Verantwortliche für Datenquellen, definierte Qualitätsregeln und eine klare Linie, wie mit Änderungen an Strukturen und Stammdaten umgegangen wird.
Wie unterstützt bimanu One konkret den Aufbau eines Semantic Layers für KI?
bimanu One automatisiert die Integration Deiner Kernsysteme in ein zentrales Data Warehouse und stellt darauf strukturierte, harmonisierte Datenmodelle bereit. Auf dieser Basis kannst Du Kennzahlen und Geschäftslogik zentral definieren und für BI sowie KI verfügbar machen.
Durch Low-Code-Modellierung, integrierte Versionierung und deutsches Cloud-Hosting reduziert sie sowohl technischen Aufwand als auch regulatorische Hürden. So kommst Du schneller zu einem KI-fähigen Semantic Layer, ohne ein großes internes Data-Team aufbauen zu müssen.