
Data Warehouse & KI: Warum Dein Data Warehouse im KI-Zeitalter wichtiger ist denn je
Warum KI das Data Warehouse nicht ersetzt, sondern noch wichtiger macht
In vielen Unternehmen entsteht gerade der Eindruck, dass klassische Datenarchitekturen überholt sind und generative KI wie ChatGPT, Copilot oder andere Modelle alles ersetzen können. In der Realität ist das Gegenteil der Fall: Je mehr Du auf KI setzt, desto härter werden die Anforderungen an Deine Datenbasis.
Auch die Fraunhofer-Gesellschaft betont: Die Qualität eines KI-Modells hängt von der Qualität seiner Trainingsdaten ab (Fraunhofer-Studie „Maschinelles Lernen“). Große Datenmengen allein reichen nicht aus, wenn die Daten unvollständig oder fehlerhaft sind. KI-Modelle übernehmen, was in den Daten steckt – Stärken ebenso wie Fehler und Verzerrungen.
„Garbage in, garbage out“: Warum Datenqualität über KI-Erfolg entscheidet
KI-Modelle lernen aus Mustern in Deinen Daten. Wenn Vertriebsumsätze mal brutto, mal netto erfasst sind oder Produktionsstillstände je Werk unterschiedlich codiert werden, erkennt das Modell Muster – aber eben falsche. Fraunhofer betont explizit, dass geringe Datenqualität auch bei großen Datenmengen keine zuverlässigen ML-Systeme ermöglicht.
Ein Data Warehouse sorgt genau hier für Ordnung: Dubletten werden bereinigt, Felder vereinheitlicht, Definitionen geklärt und historische Verläufe sauber abgelegt. Die KI greift dann nicht mehr auf Rohdaten mit Zufallsfehlern zu, sondern auf eine geprüfte, konsistente Datengrundlage.
Typische Erwartungen an KI – und wo sie ohne Datenbasis ins Leere laufen
Viele Management-Teams erwarten, dass KI-Tools „einfach sagen, was zu tun ist“: welche Kunden abzuspringen drohen, welche Maschine ausfallen wird oder welche Lieferanten kritisch sind. Ohne klares Datenfundament verlagert sich das Problem nur ins Modell.
Wenn zum Beispiel Kündigungen im CRM nicht sauber erfasst sind oder Servicefälle im Ticketsystem unterschiedlich dokumentiert werden, prognostiziert die KI trotzdem irgendetwas – aber niemand weiß, ob das Ergebnis auf Fakten oder auf Zufällen basiert. Das Ergebnis sind scheinbar präzise, aber nicht prüfbare Empfehlungen.
Wie sich KI-Projekte im Mittelstand heute oft aufstellen – und warum das riskant ist
Im Mittelstand starten viele KI-Projekte als isolierte Pilotvorhaben: ein Data-Science-Projekt hier, ein Copilot-Prototyp dort, oft auf CSV-Exports oder direkten Datenbankabzügen. Das spart am Anfang Zeit, schafft aber eine Schattenwelt parallel zu Reporting und Steuerung.
Die Folge: KPIs aus dem KI-Projekt weichen von Berichten im Controlling ab, niemand weiß genau, woher welche Zahl kommt, und spätestens bei Audits oder regulatorischen Fragen fehlen Nachweise. Ein Data Warehouse verhindert genau dieses Auseinanderdriften, weil es die verbindliche Datenbasis für BI, Planung und KI bereitstellt.
Was ist ein Data Warehouse? (Einfach erklärt für Entscheider)
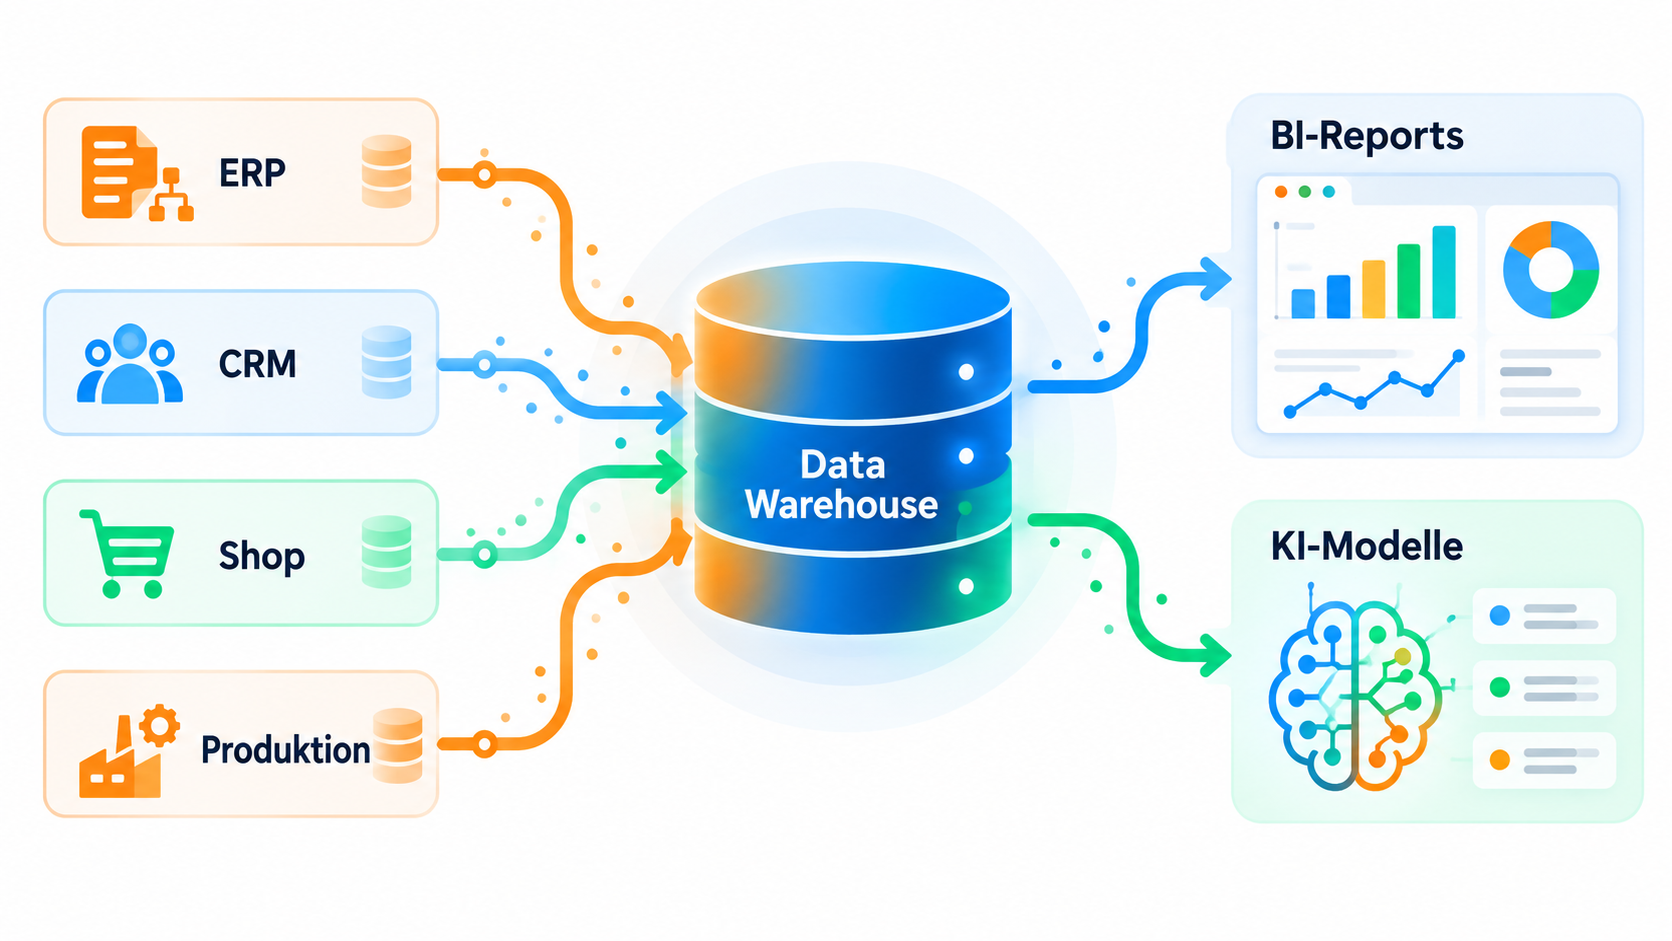
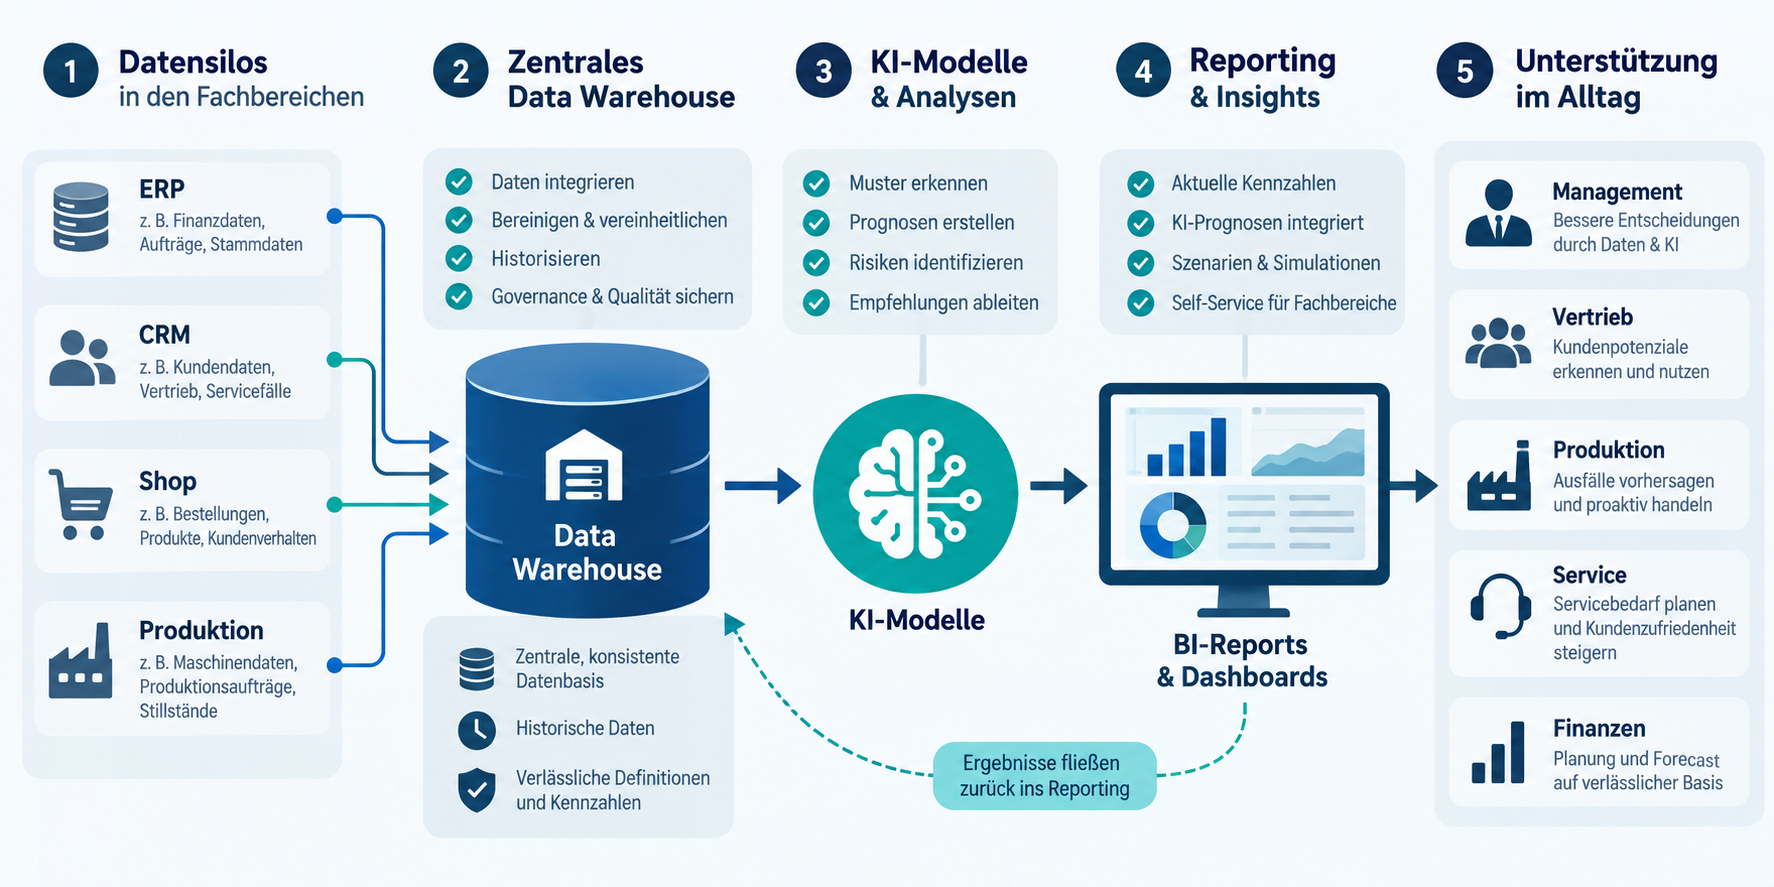
Ein Data Warehouse ist die zentrale Datenspeicher- und Auswertungsschicht für Dein Unternehmen. Es sammelt Daten aus unterschiedlichen Systemen, bereinigt und vereinheitlicht sie und stellt sie so bereit, dass Du verlässlich analysieren und berichten kannst.
Während operative Systeme wie ERP oder CRM für den täglichen Prozessbetrieb optimiert sind, ist das Data Warehouse für Auswertungen, Historien und Entscheidungsunterstützung optimiert. Es bildet damit die „Single Source of Truth“ für Kennzahlen, auf die sich Fachbereiche und Management verlassen.
Kurze Definition: Data Warehouse im Unternehmenskontext
Im Kern ist ein Data Warehouse eine zentrale, strukturierte Datenbank, die Daten aus verschiedenen Quellen integriert, historisiert und für Analysen vorbereitet. Die Daten werden so modelliert, dass sie für Berichte, Dashboards, Simulationen und KI-Modelle einfach und konsistent nutzbar sind.
Ein gutes Data Warehouse beantwortet jederzeit drei Fragen: Welche Daten haben wir? In welcher Qualität liegen sie vor? Und mit welchen Definitionen und Regeln wurden sie erzeugt? Genau diese Transparenz fehlt in vielen Ad-hoc-KI-Projekten.
Wie funktioniert ein Data Warehouse technisch? Kurz erklärt
Technisch betrachtet werden Daten aus Quellsystemen wie ERP, CRM, Shop oder MES regelmäßig extrahiert, transformiert und in das Data Warehouse geladen (ETL oder ELT). Auf dieser Basis entstehen logisch modellierte Tabellen, etwa in Stern- oder Snowflake-Schemata, die Fakten (z. B. Bestellungen, Produktionsaufträge) mit Dimensionen wie Kunde, Produkt oder Werk verknüpfen.
Moderne Data-Warehouse-Plattformen laufen meist in der Cloud, skalieren automatisch und können große Datenmengen performant verarbeiten. Wichtiger als die Technologie ist jedoch, dass Prozesse für Datenqualität, Historisierung und Governance von Anfang an mitgedacht werden.
Typische Aufgaben eines Data Warehouse im Mittelstand
Im Mittelstand übernimmt das Data Warehouse meist mehrere Rollen zugleich. Es dient als Basis für Management-Reporting, Finanzkennzahlen, Produktions- und Qualitätsberichte und zunehmend auch für Energie- und Nachhaltigkeitsauswertungen.
Gleichzeitig versorgt es BI-Tools wie Power BI, Qlik oder Tableau mit einheitlichen Datensichten und wird mehr und mehr zur Datenquelle für KI-Modelle, etwa für Absatzprognosen, Churn-Analysen oder Anomalieerkennung in Maschinendaten.
Abgrenzung zu operativen Systemen (ERP, CRM, Shop, MES …)
Operative Systeme sind dafür da, Prozesse sicher laufen zu lassen: Bestellungen erfassen, Rechnungen schreiben, Maschinen steuern, Kontakte pflegen. Sie sind meist nicht dafür ausgelegt, über Jahre hinweg große Datenmengen für Analysen historisiert, bereinigt und mit anderen Quellen verknüpft zu halten.
Ein Data Warehouse übernimmt genau diese Rolle. Es entlastet die operativen Systeme von komplexen Analysen, sorgt für konsistente Definitionen über Systemgrenzen hinweg und trennt den stabilen Prozessbetrieb von der flexiblen, analytischen Nutzung der Daten.
Kostenloses Erstgespräch vereinbaren
Warum ein Data Warehouse für KI unverzichtbar ist
KI-Projekte scheitern seltener an Algorithmen als an der Datenbasis. Ob Du einen Copilot für Managementfragen, ein Churn-Modell im Vertrieb oder eine Anomalie-Erkennung in der Produktion aufbauen willst: Ohne verlässliches Data Warehouse bleibst Du im Experimentiermodus stecken.
Ein modernes Data Warehouse liefert der KI drei zentrale Voraussetzungen: saubere Daten, klare Historien und nachvollziehbare Regeln. Damit wird aus einem PoC (Proof of Concept) ein tragfähiger Bestandteil der Unternehmenssteuerung.
Datenqualität und Konsistenz: Saubere Basis statt Datenchaos
KI reagiert extrem sensibel auf unsaubere Daten. Wenn derselbe Kunde in drei Systemen unterschiedlich geführt wird oder wenn Produktkategorien je Land anders gepflegt sind, lernt das Modell diese Widersprüche mit. Die Folge sind verzerrte Scores, unplausible Empfehlungen und aufwendige Nacharbeiten.
Im Data Warehouse werden Daten über Konnektoren automatisiert geladen, bereinigt und harmonisiert. Plausibilitätsregeln, Dublettenprüfungen und feste Felddefinitionen sorgen dafür, dass alle darauf aufbauenden Modelle mit derselben, geprüften Datenbasis arbeiten – egal ob BI-Report oder KI-Modell.
Single Source of Truth: Eine zentrale Wahrheit für Mensch und Maschine
Ein zentrales Problem in KI-Projekten ist die Frage: „Welche Zahl stimmt eigentlich?“ Wenn der Vertrieb andere Umsatzwerte nutzt als das Controlling und das Data-Science-Team noch einmal eigene Ableitungen bildet, fehlt jede gemeinsame Grundlage.
Ein Data Warehouse schafft hier eine Single Source of Truth. KPIs wie Deckungsbeitrag, OEE (Gesamtanlageneffektivität) oder Churn-Rate werden fachlich definiert, technisch umgesetzt und zentral bereitgestellt. KI-Modelle lernen auf denselben Definitionen, die auch für das Reporting gelten – damit lassen sich Ergebnisse später fachlich prüfen und erklären.
Historisierte Daten als Goldmine für Prognosen und KI-Training
Prognosemodelle leben von historischen Verläufen: Auftragsmengen pro Monat, Ausfallraten je Maschine, Besuchsfrequenzen im Webshop oder Lieferverzögerungen pro Lieferant. Nur wenn diese Historien sauber und lückenlos vorliegen, kann ein Modell Muster erkennen und in die Zukunft projizieren.
Ein Data Warehouse speichert nicht nur den aktuellen Zustand, sondern historisiert Änderungen strukturiert – etwa Preise, Stammdaten, Organisationsstrukturen. Das unterscheidet es fundamental von vielen Rohdaten-Speichern und ist einer der Hauptgründe, warum ein Data Warehouse für KI unverzichtbar ist.
Governance, Datenschutz und Rollenmodelle von Anfang an mitdenken
Mit KI steigt der Druck, genau zu wissen, wer welche Daten wofür nutzen darf. Gerade im Kontext von DSGVO und AI Act, insbesondere bei Hochrisiko-Anwendungen, musst Du nachweisen können, und wer Zugriff auf personenbezogene Informationen hat.
Ein Data Warehouse bildet Rollen, Berechtigungen und Maskierungen zentral ab. Sensible Felder können pseudonymisiert werden, Zugriffe werden protokolliert und Datenflüsse dokumentiert. Damit wird Governance zur integrierten Eigenschaft der Datenbasis – nicht zum nachgelagerten Projekt.
Nachvollziehbarkeit von KI-Ergebnissen (Explainability & Audit Trails)
Wenn eine KI vorschlägt, einen Kunden nicht weiter aktiv zu bearbeiten oder eine Maschine außerplanmäßig zu warten, brauchst Du eine Antwort auf die Frage „Warum?“. Ohne klare Datenherkunft und Versionierung ist diese Antwort kaum zu geben.
Ein Data Warehouse hält nicht nur die Daten selbst, sondern auch Metadaten und Ladeprozesse vor. Damit kannst Du nachvollziehen, welche Tabellen, Felder und Zeitstände in ein Modell eingeflossen sind. Das ist nicht nur für interne Diskussionen wichtig, sondern zukünftig auch für regulatorische Vorgaben des AI Act.
Data Warehouse vs. Data Lake: Was ist der Unterschied – und was brauchst du für KI?
Im Zusammenhang mit KI taucht neben dem Data Warehouse fast immer der Begriff Data Lake auf. Beide werden oft vermischt, haben aber unterschiedliche Aufgaben und Stärken. Für eine tragfähige KI-Strategie musst Du wissen, wofür Du welches Konzept einsetzt.
Gerade im Mittelstand ist es wichtig, Architekturentscheidungen pragmatisch zu treffen: Nicht jeder Use Case braucht einen ausgewachsenen Data Lake, aber viele profitieren von einer Kombination aus Data Warehouse und Lakehouse-Ansätzen.
Kurzer Überblick: Was ist ein Data Lake?
Ein Data Lake ist ein zentraler Speicher für große Mengen unterschiedlicher Rohdaten – strukturiert, semi-strukturiert und unstrukturiert. Hier landen zum Beispiel Logfiles, Sensordaten, Dokumente oder JSON-APIs weitgehend unverändert.
Der Vorteil: Du kannst Daten kostengünstig und flexibel sammeln, ohne sie sofort komplett zu modellieren. Der Nachteil: Ohne klare Regeln und Strukturen wird der Data Lake schnell zum „Data Swamp“, in dem zwar alles vorhanden ist, aber kaum etwas vertrauenswürdig nutzbar ist.
Data Warehouse vs. Data Lake im Vergleich
| Kriterium | Data Warehouse | Data Lake |
|---|---|---|
| Hauptzweck | Kuratierte, konsistente Daten für Reporting, Steuerung und KI | Günstige, flexible Ablage großer Rohdatenmengen |
| Datenstruktur | Stark modelliert (Tabellen, Schemata, Historisierung) | Oft schema-on-read, Dateien und Objekte, teils unstrukturiert |
| Datenqualität | Bereinigt, harmonisiert, qualitätsgeprüft | Rohdaten, Qualität je Quelle unterschiedlich |
| Typische Nutzer | Fachbereiche, Controlling, Management, KI auf KPI-Ebene | Data Engineers, Data Scientists, explorative Analysen |
| KI-Einsatz | Training und Anwendung auf vertrauenswürdigen, historisierten Daten | Feature-Engineering, Prototypen, Big-Data-Analysen |
| Risiko | Höherer initialer Modellierungsaufwand | Gefahr des Data Swamp ohne Governance und Struktur |
Wann reicht ein Data Warehouse, wann braucht es zusätzlich einen Data Lake?
Für viele mittelständische Unternehmen reicht ein gut aufgebautes Data Warehouse für die meisten KI-Use-Cases aus. Absatzprognosen, Churn-Analysen, Lieferantenbewertungen oder OEE-Auswertungen lassen sich mit klassisch strukturierten, historisierten Daten sehr gut abbilden.
Ein zusätzlicher Data Lake wird dann sinnvoll, wenn Du sehr große, vielfältige oder unstrukturierte Datenquellen integrieren willst – etwa hochfrequente Sensordaten, Logfiles aus Maschinen oder Textdokumente. In diesem Fall kann der Lake als Rohdatenspeicher dienen, während das Data Warehouse die kuratierten, KI-relevanten Ausschnitte hält.
Wie Data Warehouse und Data Lake sinnvoll zusammenspielen können
In einer modernen Datenarchitektur arbeitest Du oft mit einem Medallion-Ansatz: Rohdaten landen zunächst in einer „Bronze“-Schicht (Data Lake), werden in einer „Silver“-Schicht bereinigt und dann in einer „Gold“-Schicht als kuratierte Data-Warehouse-Tabellen bereitgestellt.
Für KI heißt das: Feature-Engineering und experimentelle Modellierung können direkt auf Lake-Daten stattfinden, während produktive Modelle und Management-KPIs auf den Gold-Schichten des Data Warehouse laufen. So kombinierst Du Flexibilität mit Verlässlichkeit.
Risiko „KI auf Treibsand“: Wenn ChatGPT & Co. Deine Unternehmensdaten nicht kennen
Generative KI-Tools wie ChatGPT, Copilot oder andere Foundation Models beeindrucken mit flüssigen Antworten und scheinbar fundierten Empfehlungen. Was leicht vergessen wird: Diese Modelle kennen Deine Unternehmensdaten in der Regel nicht oder nur sehr eingeschränkt.
Ohne Verbindung zu Deinem Data Warehouse liefern sie nur allgemeine, statistisch plausible Aussagen – aber keine geprüften, unternehmensspezifischen Fakten. Für operative oder strategische Entscheidungen ist das zu wenig.
Warum generative KI ohne Unternehmenskontext nur allgemeine Antworten liefert
Ein LLM (Large Language Model) wurde auf Milliarden von Texten trainiert, nicht auf Deinen ERP-Buchungen oder Deinen Produktionsstillständen. Es kann Dir erklären, wie man eine Churn-Analyse grundsätzlich aufbaut, aber es weiß nicht, welche Deiner Kunden wirklich wechselgefährdet sind.
Erst wenn Du das Modell mit einer sauberen, strukturierten Datenbasis verbindest – idealerweise dem Data Warehouse –, entsteht ein echter Mehrwert. Dann kann die KI konkrete Fragen beantworten wie „Welche zehn Kunden haben im letzten Quartal den stärksten Umsatzrückgang in Produktgruppe X verzeichnet?“.
Compliance-Falle: Sensible Daten in öffentliche KI-Tools kopieren
Ein typisches Muster in der Praxis ist, dass Fachbereiche CSV-Exporte aus ERP oder CRM in ein öffentliches KI-Tool hochladen, um „schnell mal“ Analysen oder Texte erzeugen zu lassen. Damit landen personenbezogene oder vertrauliche Unternehmensdaten außerhalb Deines kontrollierten Umfelds.
Neben der DSGVO ist hier auch der AI Act relevant, der bereits in Kraft ist und dessen Pflichten schrittweise greifen. Er fordert je nach Risikoklasse unter anderem Transparenz und Nachvollziehbarkeit von KI-Systemen.
Datenschutz, AI Act und Betriebsrat: Welche Fragen Du klären musst
Sobald Du KI mit Mitarbeiter- oder Kundendaten verbindest, stellen sich schnell arbeitsrechtliche und datenschutzrechtliche Fragen. Der Betriebsrat will wissen, ob Leistung oder Verhalten überwacht werden, und die Datenschutzbeauftragten fragen nach Speicherort, Löschkonzept und Zweckbindung.
Ein Data Warehouse hilft, diese Fragen konsistent zu beantworten: Es legt fest, welche Daten in welcher Form genutzt werden, wie lange sie aufbewahrt werden und wer worauf Zugriff hat. KI-Systeme können dann kontrolliert auf diese Daten zugreifen, statt eigene Schattenkopien zu erstellen.
Warum es sicherer ist, KI zu den Daten zu bringen – nicht umgekehrt
Aus technischer und rechtlicher Sicht ist es sinnvoller, KI-Modelle in die Umgebung zu holen, in der Deine Daten bereits sicher liegen, statt Daten massenhaft in externe KI-Dienste zu exportieren. So behältst Du die Hoheit über Speicherort, Verarbeitung und Zugriffe.
Ein Data Warehouse in einer DSGVO-konformen Cloud-Umgebung bietet dafür ideale Voraussetzungen: KI-Modelle werden direkt an diese kuratierte Datenbasis angebunden, Ergebnisse werden im gleichen System gespeichert und sind damit automatisch in Governance und Reporting eingebettet.
Kostenloses Erstgespräch vereinbaren
Praxisbeispiel Mittelstand: Von Insellösungen zur KI-fähigen Datenbasis
Um greifbar zu machen, wie Data Warehouse und KI zusammenspielen, schauen wir auf ein typisches Szenario aus dem Mittelstand. Ein Handels- und Produktionsunternehmen mit rund 500 Mitarbeitenden möchte verlässliche Absatzprognosen und eine bessere Bestandsplanung aufbauen.
Ausgangspunkt sind gewachsene Insellösungen: ERP-Daten, CRM-Informationen und Webshop-Daten werden getrennt geführt, Berichte entstehen überwiegend in Excel, und Prognosen basieren auf Bauchgefühl und Einzelwissen weniger Personen.
Ausgangslage: ERP-, CRM- und Shop-Daten in Silos
Im ERP liegen Aufträge, Lieferungen und Lagerbestände. Im CRM werden Aktivitäten und Opportunities geführt. Der Webshop liefert Klickdaten, Warenkörbe und Online-Bestellungen. Jede Abteilung arbeitet mit eigenen Zahlenständen und eigenen Definitionen von „aktiver Kunde“ oder „offene Bestellung“.
Ein erstes KI-Pilotprojekt nutzt CSV-Exporte aus diesen Systemen. Das liefert spannende Grafiken, aber die Ergebnisse sind nicht reproduzierbar und weichen von den offiziellen Monatsreports ab. Vertrauen entsteht so nicht.
Schritt 1: Datenintegration ins Data Warehouse
Zunächst werden ERP-, CRM- und Shop-Daten automatisiert in ein zentrales Data Warehouse geladen. Vordefinierte Konnektoren sorgen dafür, dass Tabellen regelmäßig aktualisiert werden, ohne manuelle Exporte oder individuelle Skripte.
In dieser Phase werden auch erste fachliche Mappings definiert: Welche Kunden-ID ist führend? Wie werden Produktgruppen vereinheitlicht? Welche Zeitzone gilt? So entsteht ein integriertes, technisches Modell der Geschäftsprozesse.
Schritt 2: Historisierung und Harmonisierung der Daten
Im nächsten Schritt werden relevante Stammdaten und Bewegungsdaten historisiert. Preisänderungen, Zustandswechsel von Opportunities oder Kanalwechsel eines Kunden werden mit Zeitstempeln versehen, damit spätere Modelle Entwicklungen nachvollziehen können.
Parallel werden Kennzahlen wie „aktive Kunden“, „Warenkorbabbruch“ oder „Lieferverzug“ fachlich und technisch vereinheitlicht. Damit steht eine konsistente KPI-Schicht zur Verfügung, auf die sich alle – BI, Fachbereiche, KI – gleichermaßen beziehen.
Schritt 3: Aufbau von Prognosemodellen (z. B. Absatz, Lagerbestände, Churn)
Auf Basis der historisierten DWH-Daten wird ein erstes Absatzprognosemodell aufgebaut. Es nutzt vergangene Bestellungen, Saisonalitäten, Kampagnendaten aus dem CRM und Webshop-Signale, um die erwartete Nachfrage je Produktgruppe und Region zu schätzen.
Weil das Modell direkt auf der kuratierten Data-Warehouse-Schicht trainiert wird, sind die Eingangsgrößen klar definiert, historisiert und qualitätsgeprüft. Die Ergebnisse lassen sich mit bestehenden Reports abgleichen, Abweichungen können fachlich diskutiert und iterativ verbessert werden.
Schritt 4: Nutzung der KI-Ergebnisse im Tagesgeschäft (Vertrieb, Planung, Einkauf)
Die Prognoseergebnisse werden zurück in das Data Warehouse geschrieben und dort als zusätzliche Fakten-Tabellen bereitgestellt. BI-Tools visualisieren sie neben den Ist-Zahlen, Einkauf und Vertrieb sehen Prognosen direkt in ihren gewohnten Reports.
Auf Basis dieser Daten werden Lagerziele angepasst, Kampagnenzeitpunkte optimiert und Einkaufsmengen besser geplant. Weil alle auf derselben Datenbasis arbeiten, erhöht sich das Vertrauen in die KI – und Entscheidungen werden schneller und fundierter getroffen.
Wie bimanu One Dein Data Warehouse KI-ready macht
Wenn Du diese Schritte mit klassischer BI-Technologie und viel Eigenentwicklung gehen willst, brauchst Du ein starkes internes Team und viel Zeit. Für viele Mittelständler ist das der Engpass. Genau hier setzt bimanu One an: als vollständig automatisierte, KI-fähige Datenplattform, die speziell für den Mittelstand gedacht ist.
Sie verbindet Data Warehouse, Datenintegration, Automatisierung und KI-Anbindung in einer Low-Code-Plattform, die ohne großes BI-Projekt und ohne zusätzliches Spezialistenteam auskommt.
bimanu One als KI-fähige Datenplattform für den Mittelstand
bimanu One bringt alle Bausteine zusammen, die Du für KI-fähige Daten brauchst: vorgefertigte Konnektoren, automatisierte Data-Warehouse-Beladung, versionierte Datenmodelle und Anbindung an BI- und KI-Tools. Sie ersetzt dabei nicht Deine Frontends, sondern stellt ihnen eine verlässliche Datenbasis zur Verfügung.
Power BI, Qlik oder Tableau kannst Du weiterhin nutzen – nur eben nicht mehr auf Excel-Exports oder isolierten Datenbanken, sondern auf einer zentralen, automatisierten Plattform. Damit unterscheidet sich bimanu deutlich von reinen Visualisierungslösungen.
Data Value Warehouse: KI- und ML-Modelle automatisch mit produktiven Daten versorgen
Herzstück von bimanu One ist das Data Value Warehouse, das auf Snowflake-Technologie läuft und automatisch skaliert. Es sorgt dafür, dass Daten aus ERP, CRM, Shop oder IoT-Systemen täglich, stündlich oder in frei definierbaren Intervallen aktualisiert werden.
KI- und ML-Modelle können direkt auf diese produktiven, qualitätsgeprüften Daten zugreifen. Statt manuell Trainingsdaten zu bauen, entsteht ein stabiler Datenstrom, der Modelle kontinuierlich mit frischen, aber kontrollierten Informationen versorgt.
Rückführung von KI-Ergebnissen ins Data Warehouse für weitere Analysen
Ein weiterer Vorteil: Ergebnisse aus KI-Modellen – etwa Scores, Prognosewerte oder Klassifikationen – werden automatisiert zurück ins Data Warehouse geschrieben. Dort stehen sie für BI-Reports, operative Dashboards oder weitere Modelle zur Verfügung.
So vermeidest Du parallele „KI-Dateninseln“ und stellst sicher, dass KI-Ergebnisse im Unternehmen sichtbar, prüfbar und wiederverwendbar werden. Die KI wird zu einem integrierten Bestandteil Deiner Datenplattform, nicht zu einem separaten Experiment.
Automatisierte Historienlogik: Warum das für Prognosen so entscheidend ist
bimanu One bringt eine vordefinierte Historienlogik mit, die beim Laden des Data Warehouse automatisch greift. Änderungen an Stammdaten oder Zuständen werden so erfasst, dass sie für Prognose- und Klassifikationsmodelle nutzbar sind, ohne dass Du selbst aufwändige SCD (Slowly Changing Dimensions) -Logiken implementieren musst.
Gerade für KI-Projekte ist das ein entscheidender Vorteil, weil Du nicht bei Null anfangen musst, um belastbare, historisierte Trainingsdaten aufzubauen. Die Struktur für Zeitreihen-Analysen, Vorhersagen und Szenarien ist systemseitig vorhanden.
Low-Code, Konnektoren und Automatisierung statt großem BI-Projekt
Mit über 50 vorkonfigurierten Konnektoren bindet bimanu One gängige ERP-, CRM- und Produktionssysteme ohne langwierige Integrationsprojekte an. Datenmodelle werden per Low-Code aufgebaut und automatisch versioniert, Deployments laufen per Knopfdruck durch definierte Stufen.
Das reduziert Abhängigkeiten von knappen Spezialisten und ermöglicht es Fachbereichen, fachliche Regeln und Mappings selbst einzubringen. Die bimanu Academy unterstützt zusätzlich beim Kompetenzaufbau, damit Dein Team die Plattform souverän nutzen kann.
DSGVO, Hosting in Deutschland und ISO-Konformität als Sicherheitsfundament
Für KI-Anwendungen mit Kunden-, Lieferanten- oder Mitarbeiterdaten ist der rechtliche Rahmen entscheidend. bimanu One wird in Deutschland betrieben, ist ISO 27001 zertifiziert und ist von Grund auf DSGVO-orientiert konzipiert.
Das erleichtert die Abstimmung mit Datenschutz, IT-Security und Betriebsrat, weil Speicherort, Zugriffsrechte und technische Maßnahmen klar dokumentiert sind. KI wird damit nicht zum Compliance-Risiko, sondern baut auf einer geprüften Infrastruktur auf.
bimanu One: BI, KI und Kontext in einer Oberfläche zusammenführen
Mit bimanu One steht Dir zusätzlich eine Oberfläche zur Verfügung, in der BI, KI und Kontextinformationen zusammenlaufen. Fachanwender können dort auf Dashboards, Analysen und KI-Ergebnisse zugreifen, ohne sich durch verschiedene Tools und Datenquellen kämpfen zu müssen.
So werden KI-Erkenntnisse nicht nur technisch verfügbar, sondern im Alltag nutzbar: für Planungsrunden, Vertriebsbesprechungen oder Produktionsmeetings – immer basierend auf derselben, zentralen Datenbasis.
| Aspekt | Klassische BI-Tools | bimanu One |
|---|---|---|
| Fokus | Visualisierung und Reporting | Zentrale Datenbasis, Automatisierung, KI-Readiness |
| Datenintegration | Oft manuell oder projektbasiert | Vorkonfigurierte Konnektoren, automatisierte Beladung |
| Modellierung | Teilweise im Tool, teils in SQL/ETL-Skripten | Low-Code, versionierte Modelle, automatisches Deployment |
| KI-Anbindung | Meist Add-on oder extern | Data Value Warehouse mit KI-/ML-Anbindung als Kernfunktion |
| Ressourcenbedarf | Eigenes BI-/Data-Engineering-Team nötig | Für den Mittelstand optimiert, Academy und Coaching inklusive |
So startest du pragmatisch: Schritte zu einem KI-fähigen Data Warehouse
Der Weg zu einer KI-fähigen Datenbasis muss kein Mammutprojekt sein. Entscheidend ist, in der richtigen Reihenfolge vorzugehen und sich auf wenige, klare Use Cases zu konzentrieren, statt eine perfekte Zielarchitektur auf dem Papier zu entwerfen.
Mit einem strukturierten Einstieg kannst Du innerhalb weniger Wochen erste belastbare Ergebnisse erzielen und parallel Dein Datenfundament für weitere KI-Anwendungen vorbereiten.
Status-Quo-Check: Datenquellen, Reifegrad, wichtigste Use Cases
Am Anfang steht eine kurze, aber ehrliche Bestandsaufnahme: Welche Systeme hast Du im Einsatz? Wo liegen kritische Excels und Schattenreports? Welche KPIs sind derzeit umstritten oder nur mit viel Aufwand zu ermitteln?
Parallel definierst Du zwei bis drei priorisierte Use Cases, etwa „Absatzprognose pro Produktgruppe“, „Churn-Risiko im Bestandskundenbestand“ oder „Frühwarnsystem für Maschinenausfälle“. Diese Use Cases geben der DWH-Gestaltung eine klare Richtung.
Priorisierung: Welche KI-Szenarien bringen schnell sichtbaren Mehrwert?
Nicht jede KI-Idee ist für den Start geeignet. Gute Einstiegs-Szenarien haben klare Erfolgsmetriken, bauen auf vorhandenen Daten auf und sind für Fachbereiche unmittelbar relevant. Beispiele sind Bestandsoptimierung, Cross-Selling-Potenziale oder Lieferterminprognosen.
Diese Use Cases helfen Dir, früh zu zeigen, dass das Data Warehouse nicht nur ein IT-Projekt ist, sondern messbaren Geschäftsnutzen liefert. Gleichzeitig baust Du Datenstrukturen auf, die für weitere Szenarien wiederverwendet werden können.
Architektur-Entscheidung: Data Warehouse first, Data Lake optional
Für die meisten mittelständischen Setups ist es sinnvoll, mit einem klar strukturierten Data Warehouse zu starten und die Frage nach einem Data Lake bewusst nachzulagern. So vermeidest Du, Dich früh in komplexer Infrastruktur zu verlieren.
Wenn später sehr große oder unstrukturierte Datenquellen hinzukommen, kannst Du immer noch eine Lake-Komponente ergänzen, die sauber an das bestehende Data Warehouse andockt. Entscheidend ist, dass Governance und Datenqualität von Beginn an im DWH verankert sind.
Implementierung mit bimanu: In 14 Tagen zur produktiven Datenbasis
Mit bimanu One kannst Du diesen Weg erheblich verkürzen. Statt monatelanger Projekte ist das Grundsystem innerhalb von 14 Tagen einsatzbereit, inklusive Anbindung der wichtigsten Quellsysteme und Aufbau eines ersten, produktiven Data Warehouse.
In dieser Zeit werden nicht nur technische Verbindungen geschaffen, sondern auch fachliche Modelle und KPIs definiert. So entsteht ein belastbarer Kern, auf den weitere Use Cases und KI-Modelle schrittweise aufbauen können.
Enablement: Fachbereiche befähigen statt IT-Engpass verstärken
Damit das Data Warehouse nicht zum nächsten Engpass wird, ist Enablement entscheidend. Fachbereiche sollten verstehen, welche Daten ihnen zur Verfügung stehen, wie KPIs definiert sind und wie sie neue Anforderungen formulieren können.
Mit der bimanu Academy und klar strukturierten Low-Code-Oberflächen werden Fachbereiche in die Lage versetzt, selbstständig mit der Plattform zu arbeiten – ohne jedes Mal ein IT-Projekt anzustoßen. Das löst den klassischen Flaschenhals zwischen Fachbereich und IT auf.
Kostenloses Erstgespräch vereinbaren
Data Warehouse & KI: Fazit für Entscheider im Mittelstand
KI macht das Data Warehouse nicht überflüssig – sie macht es unverzichtbar. Ohne zentrale, historisierte und qualitätsgesicherte Datenbasis bleiben KI-Initiativen Experimente, deren Ergebnisse weder vertrauenswürdig noch auditierbar sind.
Mit einem modernen Data Warehouse schaffst Du dagegen eine stabile Grundlage, auf der Reporting, Planung und KI auf dieselben verlässlichen Zahlen zugreifen. bimanu One unterstützt Dich dabei, dieses Fundament schnell, automatisiert und ohne großen Ressourcenaufwand aufzubauen.
Nächster Schritt: Deine Datenbasis KI-ready machen
Wenn Du den Eindruck hast, dass Deine aktuellen Berichte, Excels und Dateninseln einer KI-Strategie im Weg stehen, ist jetzt der richtige Zeitpunkt für einen strukturierten Neustart. Du musst dafür weder Deine komplette IT neu aufsetzen noch ein großes Data-Science-Team aufbauen.
Ein erstes Gespräch klärt, welche Datenquellen und Use Cases sich für einen schnellen Einstieg eignen und wie eine bimanu-basierte Architektur in Deinem Umfeld aussehen kann. Auf dieser Basis kannst Du fundiert entscheiden, wie Du Dein Data Warehouse im KI-Zeitalter positionierst.

Data Warehouse & KI – Häufige Fragen und Antworten
Braucht man im KI-Zeitalter überhaupt noch ein Data Warehouse?
Ja, mehr denn je. KI-Modelle sind nur so gut wie die Daten, mit denen sie arbeiten, und ein Data Warehouse stellt genau diese saubere, konsistente und historisierte Datenbasis bereit. Ohne Data Warehouse riskierst Du widersprüchliche Kennzahlen, schwer erklärbare KI-Ergebnisse und hohe Projektkosten durch Ad-hoc-Datenaufbereitung.
Kann KI ein Data Warehouse ersetzen?
Nein. KI kann Muster erkennen, Prognosen erstellen oder Texte generieren, sie ersetzt aber weder die Integration, Bereinigung noch die fachliche Modellierung Deiner Unternehmensdaten. Ein Data Warehouse definiert, welche Zahlen „offiziell“ sind und bildet damit das Fundament, auf dem KI sicher und nachvollziehbar arbeiten kann.
Reicht ein Data Lake für KI-Projekte aus – oder brauche ich beides?
Ein Data Lake reicht in der Regel nicht aus, wenn Du verlässliche, wiederholbare KI-Ergebnisse brauchst, die mit Deinem Reporting übereinstimmen sollen. Der Lake ist ideal für Rohdaten und explorative Analysen, das Data Warehouse liefert die kuratierte Gold-Schicht, auf der produktive Modelle und Management-KPIs laufen.
Ab welcher Unternehmensgröße lohnt sich ein Data Warehouse für KI?
Relevant ist weniger die Anzahl der Mitarbeitenden als die Komplexität Deiner Prozesse und Datenquellen. Spätestens wenn Du mehrere Systeme (ERP, CRM, Shop, Produktion) kombinieren musst und Fachbereiche unterschiedliche Zahlenstände diskutieren, lohnt sich ein Data Warehouse – unabhängig davon, ob Du 200 oder 2.000 Mitarbeitende hast.
Wie lange dauert es, bis ein Data Warehouse für erste KI-Use-Cases nutzbar ist?
Mit klassischem Projektansatz können Monate vergehen, bis erste Ergebnisse sichtbar sind. Mit Plattformen wie bimanu One lässt sich ein funktionsfähiges Data Warehouse in etwa 14 Tagen aufsetzen, inklusive Anbindung der wichtigsten Systeme, sodass erste KI-Szenarien wie Prognosen oder Scorings schnell auf produktiven Daten aufsetzen können.
Was kostet ein Data Warehouse im Vergleich zu einzelnen KI-Pilotprojekten?
Einzelne KI-Piloten wirken zunächst günstiger, verursachen aber oft hohe versteckte Kosten durch manuelle Datenaufbereitung und fehlende Wiederverwendbarkeit. Ein Data Warehouse ist eine Investition in ein dauerhaftes Fundament: Die initialen Kosten amortisieren sich in der Regel, weil Du Datenprozesse standardisierst und neue KI-Use-Cases deutlich schneller aufsetzen kannst.
Wie stelle ich sicher, dass mein Data Warehouse DSGVO- und AI-Act-konform ist?
Entscheidend sind klare Rollen- und Berechtigungskonzepte, dokumentierte Datenflüsse, Historienlogik und ein Hosting, das zu Deinen Compliance-Anforderungen passt. Mit einer Plattform wie bimanu One, die in Deutschland gehostet und ISO-konform aufgebaut ist, schaffst Du wichtige technische Voraussetzungen, um die Anforderungen von DSGVO und AI Act zu erfüllen.
Wie integriert sich bimanu One mit bestehenden BI-Tools wie Power BI, Qlik oder Tableau?
bimanu One ersetzt Deine BI-Frontends nicht, sondern liefert ihnen eine konsistente, automatisierte Datenbasis. Du kannst weiterhin mit Power BI, Qlik oder Tableau arbeiten, greifst aber nicht mehr auf Insellösungen oder manuelle Exporte zurück, sondern auf ein zentrales, versioniertes Data Warehouse mit klar definierten KPIs.
Wir haben wenig interne BI-Ressourcen – können wir trotzdem eine KI-fähige Datenbasis aufbauen?
Ja, sofern Du auf eine Plattform setzt, die viele technische Schritte automatisiert und Fachbereiche einbindet. bimanu One wurde genau für diesen Fall entwickelt: Low-Code-Modellierung, vorgefertigte Konnektoren und die bimanu Academy reduzieren den Bedarf an Spezialisten und ermöglichen es Dir, auch mit kleinem Team ein tragfähiges Data Warehouse für KI aufzubauen.