
AI Business Intelligence mit LLMs: Warum viele Projekte scheitern – und wie sie in den Betrieb kommen
AI Business Intelligence im Mittelstand: Versprechen, Hype und Realität
In vielen Unternehmen gibt es heute beeindruckende Demos: Ein Chatfenster, in das das Management „Wie war unser Umsatz im letzten Quartal nach Region?“ eingibt und in Sekunden eine Antwort samt Diagramm erhält. Genau dieses Bild treibt die Erwartungen an AI Business Intelligence nach oben – gerade im Mittelstand mit hohem Entscheidungsdruck.
Die Realität sieht jedoch oft anders aus. Laut Eurostat nutzten 2025 nur rund 20 % der Unternehmen in der EU überhaupt KI-Technologien, und Gartner prognostizierte bereits 2024, dass bis Ende 2025 rund 30 % der GenAI-Projekte nach dem Proof of Concept eingestellt werden. In der Praxis bleibt vieles im Pilot stecken, obwohl die Technologie grundsätzlich funktioniert.
Was unter AI Business Intelligence heute verstanden wird
Unter AI Business Intelligence versteht man die Verbindung klassischer BI – also Datenintegration, Data Warehouse, Kennzahlenmodell und Reporting – mit KI-Funktionen. Dazu gehören automatische Mustererkennung, Prognosen, Textzusammenfassungen von Reports und insbesondere die natürliche Sprachinteraktion mit Daten.
Im Alltag heißt das zum Beispiel: Ein Controller lässt sich Abweichungen im Monatsabschluss automatisch kommentieren, ein Produktionsleiter fragt eine Maschine nach Stillstandsgründen, oder der Vertrieb analysiert die Pipeline per Chat, statt eigene Abfragen bauen zu müssen. KI ergänzt also BI um Geschwindigkeit und Zugänglichkeit.
Welche Rolle Large Language Models (LLMs) in BI spielen
LLMs bringen zwei Fähigkeiten mit, die für BI besonders interessant sind: Sie können natürliche Sprache verstehen und generieren und sie können Struktur aus komplexen Eingaben ableiten. In BI-Szenarien werden sie deshalb genutzt, um Fragen der Fachbereiche in Datenabfragen zu übersetzen und Ergebnisse verständlich zu erklären.
Technisch passiert dahinter meist Folgendes: Das LLM erzeugt z. B. SQL, DAX oder MDX über ein vorhandenes Datenmodell, oder es arbeitet mit Retrieval-Augmented Generation (RAG) auf Metadaten, KPI-Definitionen und Reportbeschreibungen. Das Modell ist also Interface und Übersetzer – es ersetzt weder das Data Warehouse noch die BI-Architektur.
Typischer Projektverlauf: Vom beeindruckenden Prototyp zum gescheiterten Rollout
Der typische Verlauf im Mittelstand sieht so aus: Ein kleiner PoC wird aufgesetzt, häufig mit einem Cloud-LLM und einem begrenzten Datenausschnitt. Fachbereiche stellen Fragen, die Antworten wirken plausibel, die Begeisterung ist groß und das Thema geht in Richtung „Wir wollen das für alle Kennzahlen und alle Fachbereiche“.
Spätestens an dieser Stelle tauchen erste Risse auf. Das LLM beantwortet die gleiche Frage je nach Formulierung unterschiedlich, „Umsatz“ meint in Vertrieb und Controlling etwas anderes, Berechtigungen sind im PoC ignoriert worden und niemand kann genau erklären, auf welcher Datenbasis eine Zahl entstanden ist. Der Sprung in den produktiven Betrieb scheitert dann nicht an der Modellleistung, sondern an Daten, Governance und Organisation.
Suchintention: Was Entscheider wirklich von AI-gestützter BI erwarten
Wenn Entscheider nach „AI Business Intelligence“ oder „AI-gestützte BI“ suchen, geht es selten um ein einzelnes Tool. Im Kern geht es um drei Erwartungen: schnellere Antworten auf geschäftskritische Fragen, weniger Abhängigkeit von überlasteten BI- und IT-Teams und mehr Sicherheit, dass Entscheidungen auf konsistenten Zahlen basieren.
In Gesprächen mit Mittelstandsunternehmen zeigt sich immer wieder: Niemand braucht noch ein weiteres Dashboard, das niemand nutzt. Gefragt sind Systeme, die validierte Daten mit verständlichen Erklärungen verbinden und so Entscheidungsprozesse spürbar verkürzen – ohne dabei Kontroll- oder Compliance-Risiken aufzubauen.
Warum LLM-basierte BI im Mittelstand oft im Proof of Concept stecken bleibt
Dass viele LLM-Initiativen nicht über den Prototyp hinauskommen, ist inzwischen gut dokumentiert: Laut einer Gartner-Analyse von 2025 schaffen es im Schnitt nur 41 % der GenAI-Prototypen in den Produktivbetrieb. Die Ursachen liegen fast immer im Umfeld der Daten und der Organisation, nicht in der KI-Engine selbst.
Gerade im Mittelstand mit verteilten Systemen, historisch gewachsenen BI-Landschaften und knappen Ressourcen treffen hohe Erwartungen auf eine Basis, die für klassische Reports gerade noch ausreicht – für automatisierte, KI-gestützte Antworten aber zu fragil ist. Die folgenden Faktoren begegnen uns in Projekten besonders häufig.
Kein gemeinsames Datenmodell: Wenn das LLM die Geschäftslogik nicht kennt
In vielen Unternehmen gibt es kein durchgängig definiertes Datenmodell, das festlegt, wie Belege, Bewegungsdaten und Stammdaten zusammenhängen und welche Logik hinter Kennzahlen steht. Stattdessen existieren Bereichssichten, Excel-Logiken und implizites Wissen einzelner Personen.
Ein LLM kann diese Lücken nicht schließen. Wenn „Deckungsbeitrag“ im Vertrieb anders gerechnet wird als im Controlling und es keine klare, semantisch beschriebene Definition gibt, kann das Modell nur raten, welche Variante gemeint ist. Die Antworten wirken zwar sprachlich souverän, sind aber fachlich inkonsistent – und damit nicht belastbar.
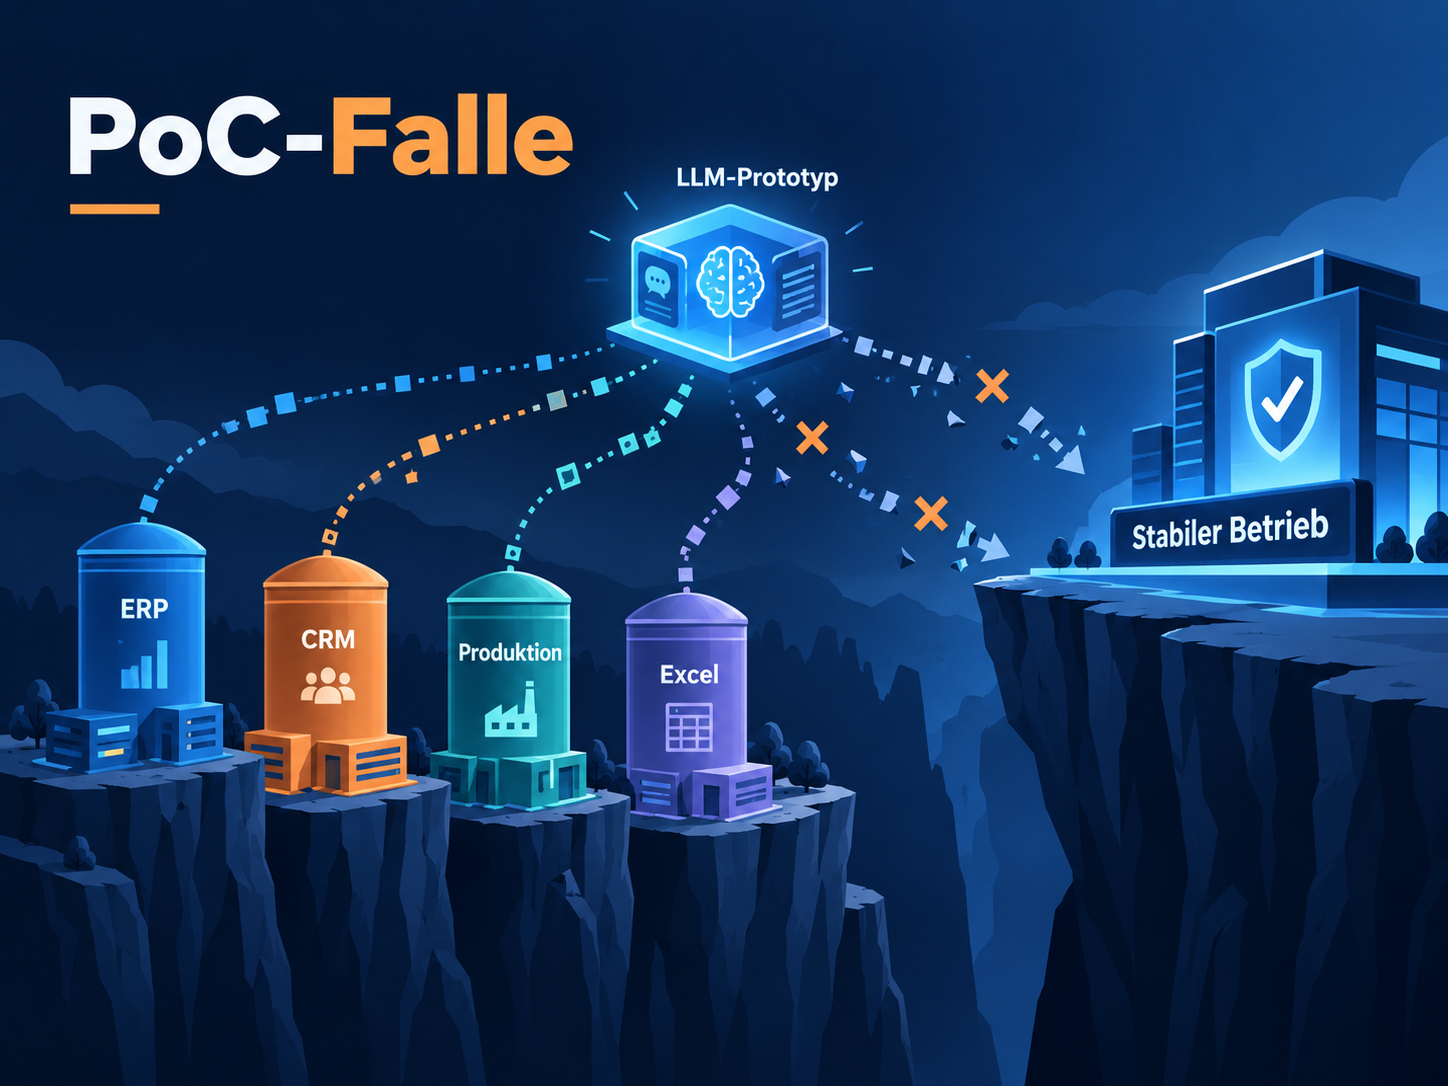
Datensilos zwischen ERP, CRM, Produktion und Excel
Ein zweiter Bremsklotz sind verteilte Datenlandschaften. ERP, CRM, MES, Instandhaltungstools, E-Mail-Systeme und Excel-Dateien liefern jeweils eigene Ausschnitte, oft ohne einheitliche IDs, Zeitachsen oder Material-/Kundenlogiken. Für klassisches Reporting werden diese Silos mit viel manuellem Aufwand überbrückt.
In einem LLM-Szenario führt diese Fragmentierung schnell zu widersprüchlichen Antworten: Eine Frage nach „Kundenumsatz“ kann je nach angebundener Quelle andere Ergebnisse liefern. Ohne zentrale Plattform, die diese Datenquellen integriert, harmonisiert und historisiert, baut ein AI-BI-Projekt auf Sand.
Mangelhafte Datenqualität und fehlende Historisierung
Studien wie die OECD AI Review of Germany betonen, dass gerade kleine und mittlere Unternehmen häufig nicht genug strukturierte Daten in ausreichender Qualität besitzen. In der BI-Praxis heißt das: fehlende Pflichtfelder, lückenhafte Zeitreihen, fehlerhafte Zuordnungen und kaum systematische Datenqualitätsregeln.
Für LLM-gestützte BI verschärft sich das Problem. Modelle können nur so gut antworten, wie die zugrunde liegende Datenstruktur es erlaubt. Wenn Historie fehlt, werden Zeitvergleiche unzuverlässig. Wenn IDs nicht sauber verknüpft sind, geraten Zuordnungen durcheinander. Was in einem manuellen Excel-Report noch auffällt, bleibt in einer textbasierten KI-Antwort oft unentdeckt.
Halluzinationen und fehlende Nachvollziehbarkeit untergraben das Vertrauen
LLMs sind probabilistische Systeme. Sie erzeugen die wahrscheinlichste nächste Antwort – nicht zwingend die inhaltlich korrekte. Ohne Anbindung an ein belastbares Datenmodell und ohne Guardrails besteht die Gefahr, dass Zahlen „halluziniert“ oder falsch interpretiert werden, etwa indem ein Modell aus Kontext ableitet, was nie im Data Warehouse definiert wurde.
Noch kritischer wird es, wenn Antworten nicht nachvollziehbar sind. Wenn ein Bereichsleiter nicht sehen kann, welche Tabelle, welchen Stichtag und welche KPI-Definition ein Modell genutzt hat, sinkt das Vertrauen rapide. Die Folge ist eine Rückkehr zu manuellen Abgleichen und Zusatz-Excels – genau das Gegenteil dessen, was mit AI BI erreicht werden sollte.
Ungeklärte Governance: Berechtigungen, Datenschutz, DSGVO
Viele PoCs laufen mit vereinfachten Berechtigungsmodellen: Ein kleiner Nutzerkreis hat Vollzugriff auf einen Test-Datenausschnitt, Datenschutz und Rollenkonzepte werden „für später“ vorgesehen. Spätestens beim Übergang in Richtung Produktivbetrieb kommen dann Fragen nach Zugriffsrechten, Mandantentrennung und Datenschutzfolgeabschätzung auf den Tisch.
Der EU AI Act und die DSGVO verlangen je nach Einsatzfeld deutliche Transparenz und Kontrolle. Dazu gehören auditierbare Zugriffe, klare Verantwortlichkeiten für Datenverarbeitung und Mechanismen zur Fehlerkorrektur. Wenn diese Governance-Themen nicht von Beginn an mitgedacht werden, bremsen sie den Rollout – oft so stark, dass Projekte wieder gestoppt werden.
Unklare Verantwortlichkeiten und fehlender Business Case
Ein weiterer Grund für stockende AI-BI-Initiativen ist die Frage: Wem „gehört“ das System? Ist es ein IT-Projekt, ein BI-Projekt oder ein Thema des jeweiligen Fachbereichs? Ohne Data Owner für Kennzahlen, klar definierte Rollen und ein Operating Model entstehen Lücken in Betrieb und Weiterentwicklung.
Parallel dazu ist der Business Case oft unscharf formuliert. „Wir wollen KI nutzen“ reicht nicht als Projektziel. Wenn Zeitersparnis, Fehlerrisiko oder Entscheidungsqualität nicht messbar gemacht werden, fällt es schwer, Budget und Priorität gegen andere Initiativen zu verteidigen. Gerade im Mittelstand führt das häufig dazu, dass PoCs zwar abgeschlossen, aber nicht weitergeführt werden.
Organisatorische Reife vs. technologische Machbarkeit
Technologisch ist heute vieles möglich: Cloud-LLMs, fertige RAG-Komponenten, AutoML und semantische Modelle stehen als Services zur Verfügung. Die Frage ist weniger „Kann man das machen?“, sondern „Ist die Organisation bereit, es verantwortbar zu betreiben?“. Dazu gehören Data Governance, Change Management und kontinuierliches Monitoring.
Frameworks wie das NIST AI Risk Management Framework oder die Vorgaben des AI Act machen deutlich, dass produktive KI-Systeme als Daueraufgabe verstanden werden müssen. Wer LLM-basierte BI ohne diese organisatorische Basis einführt, schafft eine neue Klasse kritischer Schatten-IT – nur diesmal im KI-Bereich.
Kernprinzip: Ein LLM ist nur so gut wie das Datenmodell darunter
Über alle gescheiterten oder abgebrochenen Initiativen hinweg zieht sich eine Konstante: Ein LLM ohne klares Datenmodell verhält sich wie ein Chatbot, der auf Bauchgefühl antwortet. Erst wenn ein stabiler, semantisch beschriebener „Single Point of Truth“ existiert, kann KI verlässlich auf Unternehmensdaten zugreifen.
Für Dich als Entscheider heißt das: Der Engpass liegt selten beim KI-Modell selbst, sondern bei der BI-Architektur, die dem Modell Kontext liefert. Ein ausgereiftes Datenmodell mag für klassische Dashboards ein „nice to have“ gewesen sein – für AI Business Intelligence ist es zwingende Voraussetzung.
Was ein „Single Point of Truth“ in der Praxis bedeutet
Ein „Single Point of Truth“ ist mehr als ein zentraler Speicherort für Daten. In der Praxis bedeutet es: Es gibt ein fachlich abgestimmtes, technisches Datenmodell, das alle relevanten Entitäten, Beziehungen und Kennzahlen abbildet und im Unternehmen als verbindliche Grundlage anerkannt ist.
Für AI BI ist besonders wichtig, dass dieser Single Point of Truth nicht nur gespeichert, sondern auch maschinenlesbar beschrieben ist: Welche Tabellen gehören zu welchen Geschäftsobjekten, welche Felder definieren einen Kunden, welche Zeitbezüge gelten für welche Kennzahl? Erst dann kann ein LLM Antworten erzeugen, die auf denselben Regeln basieren wie Deine bisherigen Reports.
Semantische Schicht: KPIs, Begriffe und Regeln eindeutig machen
Die semantische Schicht ist die Ebene, auf der fachliche Begriffe, KPI-Definitionen und Berechnungsregeln eindeutig festgelegt und dokumentiert werden. Sie beantwortet Fragen wie: Was genau ist „Netto-Umsatz“? Wie wird „Liefertermintreue“ berechnet? Wie ist eine „aktive Maschine“ definiert?
Für LLM-Szenarien ist diese Schicht zentral, weil sie Ambiguität reduziert. Statt dass das Modell aus dem Prompt erraten muss, welche Definition gemeint ist, verweist es auf eine definierte Metrik im Metrics Layer. Das reduziert Interpretationsspielraum, verringert Fehler und macht Antworten auditierbar.
Warum Rohdaten kein verlässlicher Kontext für LLMs sind
Die Versuchung ist groß, ein LLM direkt auf Rohdaten oder schnell exportierte Tabellen anzusetzen. Für einfache Fragen mag das kurzfristig funktionieren. Spätestens bei bereichsübergreifenden Kennzahlen, zeitlichen Vergleichen oder komplexeren Logiken bricht dieser Ansatz jedoch zusammen.
Rohdaten enthalten keine Geschäftslogik, keine historisierte KPI-Berechnung und keine abgestimmten Definitionen. Ein LLM kann darauf zwar Abfragen formulieren, aber es kennt nicht den Unterschied zwischen „Testdaten“, „Fehlbuchungen“ und produktiven Daten. Ohne vorgelagertes Modell besteht die Gefahr, dass jede Antwort ein einmaliges Unikat ist – nicht reproduzierbar und nicht prüfbar.
Vier Säulen moderner Business Intelligence als Basis für AI
Damit LLM-basierte BI im Alltag funktioniert, braucht es eine solide BI-Architektur. In vielen Unternehmen haben sich dabei vier zentrale Säulen herauskristallisiert, auf denen KI aufsetzen kann, statt sie zu ersetzen.
Diese Säulen bilden zusammen die Grundlage für konsistente Daten, nachvollziehbare Kennzahlen und kontrollierbare Zugriffe – und damit für jede Form von AI-gestützter Entscheidungsunterstützung.
| Säule | Rolle in klassischer BI | Bedeutung für AI Business Intelligence |
|---|---|---|
| Datenintegration & -aufbereitung | Zusammenführen und Bereinigen von Daten aus ERP, CRM, Produktion und weiteren Systemen. | Sorgt dafür, dass LLMs auf konsistente, qualitätsgeprüfte Daten zugreifen, statt auf widersprüchliche Rohdaten. |
| Zentrales Data Warehouse / Data Core | Speicherung strukturierter, historisierter Daten als Basis für Reporting und Analysen. | Liefert den stabilen Kontext für KI-Abfragen, inklusive Historie, Granularität und Revisionssicherheit. |
| Semantische Schicht & KPI-Katalog | Definiert Kennzahlen, Dimensionen und fachliche Begriffe unternehmensweit einheitlich. | Ermöglicht LLMs, Begriffe wie „Umsatz“ oder „Liefertermintreue“ eindeutig auf definierte Metriken zu beziehen. |
| Governance & Berechtigungen | Regelt Datenzugriffe, Rollen, Verantwortlichkeiten und Qualitätssicherung. | Stellt sicher, dass KI-Antworten nur auf Daten basieren, die der jeweilige Nutzer sehen darf, und dass Prozesse auditierbar bleiben. |
Voraussetzungen für verlässliche AI Business Intelligence mit LLMs
Wenn Du LLMs produktiv mit Unternehmensdaten einsetzen willst, kommst Du um bestimmte Grundlagen nicht herum. Diese Voraussetzungen lassen sich schrittweise aufbauen, sollten aber bewusst geplant werden – sonst verlagert sich das Problem nur vom BI-Team in Richtung KI-Team.
Entscheidend ist, dass Technik, Datenmodell und Organisation zusammenspielen. Eine leistungsfähige KI ohne klare KPI-Definitionen oder ohne Rechtekonzept ist genauso wenig produktionsfähig wie ein perfektes Data Warehouse ohne Anwendungsfälle.
Zentrale Datenplattform statt Insellösungen
Erste Voraussetzung ist eine zentrale Datenplattform, die Daten aus ERP, CRM, Produktion, Logistik, Finance und weiteren Systemen automatisiert zusammenführt. Sie löst die üblichen Excel- und Datenbanksilos ab und schafft eine einheitliche Grundlage für alle Berichte und Modelle.
Technisch kann das ein klassisches Data Warehouse, ein modernes Lakehouse oder eine spezialisierte Plattform wie bimanu One sein. Wichtig ist weniger das Label, sondern dass Datenbeladung, Qualitätssicherung und Historisierung nicht bei einzelnen Personen in manuellen Prozessen hängen bleiben.
Einheitliche KPI-Definitionen über alle Fachbereiche hinweg
Die zweite Voraussetzung ist ein abgestimmter KPI-Katalog. Controlling, Vertrieb, Produktion und Logistik müssen sich darauf verständigen, wie zentrale Kennzahlen gerechnet werden und welche Datenquellen dafür herangezogen werden. Ohne diese Einigung bleibt jede LLM-Antwort Verhandlungssache.
In der Praxis hat sich bewährt, mit einem überschaubaren Set kritischer KPIs zu starten – etwa Umsatz, Deckungsbeitrag, OEE, Liefertreue – und diese sauber zu definieren, statt Hunderte Metriken halbherzig zu standardisieren. LLMs können später helfen, diesen Katalog zugänglich zu machen und zu erklären.
Semantische Schicht und dokumentierte Geschäftslogik
Auf Basis der KPI-Definitionen entsteht eine semantische Schicht, in der Entitäten, Beziehungen, Kennzahlen und Aggregationsregeln maschinenlesbar beschrieben sind. Sie bildet die Übersetzungsebene zwischen fachlicher Sprache und technischer Datenstruktur.
Für LLM-BI ist diese Schicht der wichtigste Ankerpunkt: Sie sagt dem Modell, welche Tabelle und welche Felder für „Anzahl aktiver Kunden in Q2“ relevant sind, welche Filter gelten und welche Historisierung zu beachten ist. Ohne diese Schicht bleibt jede Query-Generierung heuristisch und damit fehleranfällig.
Skalierbares Data Warehouse mit Historisierung
Ein LLM, das Fragen zu Entwicklungen, Trends und Abweichungen beantworten soll, braucht Zugriff auf historisierte Daten. Ein skalierbares Data Warehouse oder Data Core stellt diese Historie bereit, inklusive Slowly Changing Dimensions, Zeitreihen und buchungsnaher Detaildaten.
Gerade im Mittelstand ist es wichtig, dass dieses Warehouse nicht als Einmalprojekt, sondern als wachsendes System gedacht wird. Automatisierte Modellierung, Versionierung und Deployment helfen, Änderungen kontrolliert einzuführen, ohne bestehende Reports zu destabilisieren.
Klares Rechte- und Berechtigungskonzept
Für einen produktiven LLM-Einsatz brauchst Du ein Berechtigungskonzept, das Rollen, Datenbereiche und Sichtbarkeiten klar regelt. Ein Vertriebsleiter darf andere Detailinformationen sehen als ein Produktionsplaner, ein Auditor braucht andere Sichten als ein Werksleiter.
Das LLM muss diese Rechte respektieren. Technisch geschieht das, indem die KI-Schicht nur über die bereits abgesicherten semantischen Modelle und Datenmarts zugreift, statt direkt auf Rohtabellen. So wird verhindert, dass im Chat plötzlich Informationen auftauchen, die in keinem Dashboard freigegeben wären.
Governance, Datenschutz und DSGVO im KI-Kontext
Neben Rollen und Rechten spielen Datenschutz und rechtliche Rahmenbedingungen eine zentrale Rolle. Der EU AI Act stellt je nach Risikoklasse unterschiedliche Anforderungen: Für die meisten BI-Anwendungen gelten vor allem Transparenz- und KI-Kompetenzpflichten, Hochrisiko-Systeme brauchen zusätzlich Risikomanagement, Protokollierung und menschliche Aufsicht.
Für AI BI bedeutet das: Du brauchst Klarheit darüber, welche Daten überhaupt in KI-Workflows einfließen dürfen, wie sie verarbeitet werden, wo Modelle gehostet sind und wer Zugriff auf Logs und Prompts hat. Ein Vertrag zur Auftragsverarbeitung ist Pflicht, EU-Hosting reduziert zusätzlich rechtliche Risiken und Prüfaufwand.
Verantwortlichkeiten, Rollen und Operating Model für AI-BI
Schließlich braucht es ein Operating Model: Wer ist für welche Kennzahlen verantwortlich? Wer pflegt das semantische Modell? Wer überwacht die LLM-Antworten und kümmert sich um Feedback aus den Fachbereichen? Und wer priorisiert neue Use Cases?
In vielen Unternehmen etabliert sich hier eine Zusammenarbeit von BI-Team, IT, Data Governance und Fachbereichen. Rollen wie Data Owner, Data Steward und AI Product Owner helfen, Aufgaben klar zuzuordnen. Ohne dieses Modell bleibt AI-BI ein „Laborprojekt“, das in der Linienorganisation keinen Platz findet.
Vom Prototyp in den Betrieb: Vorgehensmodell für LLM-basierte BI
Um LLM-basierte BI aus der PoC-Falle zu holen, ist ein strukturiertes Vorgehen hilfreich. Statt direkt „unternehmensweit KI“ zu versprechen, empfiehlt sich eine Abfolge klarer Schritte, die technische Machbarkeit, Datenfundament und organisatorische Reife systematisch zusammenführen.
Das folgende Vorgehensmodell ist bewusst pragmatisch gehalten und zielt darauf ab, bei vorhandener Datenbasis innerhalb weniger Wochen einen ersten produktiven Use Case aufzubauen, der Fachbereiche entlastet und Vertrauen schafft – ohne die komplette BI-Landschaft auf einen Schlag umbauen zu müssen.
1. Geschäftsrelevanten Use Case auswählen und schärfen
Am Anfang steht ein klar umrissener Use Case mit erkennbarem Nutzen, etwa „LLM-gestützte Kommentierung des Monatsabschlusses“ oder „Q&A über Produktionskennzahlen für Werksleiter“. Wichtiger als technische Komplexität ist hier die Nähe zum operativen Alltag.
Gemeinsam mit dem Fachbereich werden Zielgrößen definiert: Welche Fragen sollen beantwortet werden? Welche Kennzahlen sind kritisch? Wie wird Erfolg gemessen, etwa in Zeitersparnis, Fehlerrate oder Nutzungsquote? Diese Klarheit schützt vor „Feature-Sammlungen“ ohne greifbaren Business Value.
2. Datenquellen anbinden und minimal tragfähiges Datenmodell bauen
Im zweiten Schritt werden die für den Use Case relevanten Systeme angebunden und ein minimal tragfähiges Datenmodell (Minimum Viable Data Model) aufgebaut. Es geht nicht darum, sofort alle Unternehmensdaten zu integrieren, sondern genau die Teile, die für den gewählten Use Case erforderlich sind.
In dieser Phase wird auch erstmals systematisch geprüft, wie es um Datenqualität, Vollständigkeit und Historisierung steht. Wo nötig, werden Regeln zur Bereinigung, Anreicherung und Validierung eingeführt, um später keine Überraschungen im KI-Output zu erleben.
3. Semantische Ebene und KPI-Katalog aufsetzen
Auf Basis des Datenmodells wird ein erster, begrenzter KPI-Katalog erstellt und in einer semantischen Schicht abgebildet. Für den ausgewählten Use Case werden Feldnamen, Aggregationen und Business-Regeln festgelegt, sodass klar ist, welche Tabelle und welches Feld hinter jeder Kennzahl stehen.
Der Mehrwert zeigt sich bereits hier: Auch klassische BI profitiert von dieser Klärung. LLMs können später direkt auf diese semantische Ebene zugreifen, statt Kennzahlen aus Abfrage-Texten zu erraten. Damit werden Abweichungen zwischen Chat-Antworten und Dashboards deutlich reduziert.
4. LLM-Anbindung: Prompting, Guardrails und Zugriff auf die Datenplattform
Erst jetzt wird das LLM angebunden. Über kontrollierte Schnittstellen und ein definiertes Rechtekonzept erhält das Modell Zugriff auf Metadaten, KPI-Definitionen und vorgefertigte Views oder Data Marts, nicht auf das gesamte Rohdatenuniversum. Guardrails begrenzen, welche Aktionen das Modell ausführen darf.
Technisch werden Prompt-Vorlagen definiert, die Kontext, Tonalität und Struktur der Antworten vorgeben. RAG-Mechanismen stellen sicher, dass das LLM bei Begriffserklärungen und Kennzahldefinitionen auf den Data Catalog und KPI-Katalog zugreift, statt auf frei formuliertes Wissen.
5. Validierung mit Fachbereichen: Antworten testen, Feedback einbauen
In einem nächsten Schritt testen Fachbereichsvertreter das System intensiv. Sie stellen typische Fragen, prüfen Antworten gegen bekannte Reports und dokumentieren Abweichungen. Wichtig ist hier ein enger Austausch zwischen BI-, IT- und Fachseite, um Modelle und Datenbasis iterativ zu verbessern.
Parallel sollten erste Qualitätsmetriken eingeführt werden, etwa der Anteil akzeptierter Antworten ohne Korrektur oder die durchschnittliche Zeit bis zu einer verlässlichen Antwort. Diese Messgrößen helfen, den Reifegrad des Systems objektiv zu beurteilen und Vertrauen aufzubauen.
6. Governance klären: Zugriffsrechte, Auditierbarkeit, Logging
Bevor der Use Case breiter ausgerollt wird, müssen Governance-Fragen verbindlich beantwortet werden. Dazu gehören Rollenmodelle, die Protokollierung von Anfragen und Antworten, Regeln zum Umgang mit fehlerhaften Ausgaben und – wo relevant – Datenschutzfolgenabschätzungen.
Gerade im Kontext des EU AI Act ist es wichtig, dass Nutzungsrichtlinien nicht nur auf dem Papier existieren, sondern technisch unterstützt werden. Das umfasst etwa die Möglichkeit, bestimmte Felder oder Kennzahlen für bestimmte Rollen konsequent auszublenden und Nutzungsmuster zu überwachen.
7. Rollout, Enablement und kontinuierliche Verbesserung
Im letzten Schritt folgt der kontrollierte Rollout an eine definierte Nutzergruppe. Schulungen, kurze How-tos und klare Kommunikationslinien sind hier entscheidend, damit das System nicht als „Spielzeug“ wahrgenommen wird, sondern als Arbeitswerkzeug mit klaren Anwendungsfällen.
Nach dem Rollout werden Nutzung, Fehlerraten und Feedback kontinuierlich ausgewertet. Neue Fragen, die sich häufen, können als Input für weitere Daten- oder KPI-Erweiterungen dienen. So entsteht nach und nach eine AI-BI-Landschaft, die auf stabiler BI-Architektur aufbaut und mit den Anforderungen wächst.
Typische Einsatzfelder von AI Business Intelligence im Mittelstand
AI Business Intelligence ist kein Selbstzweck. Die spannendsten Effekte entstehen dort, wo BI ohnehin etabliert ist, aber unter manuellen Prozessen, Ticketstaus und Interpretationsspielräumen leidet. Im Mittelstand haben sich einige Einsatzfelder als besonders wirksam herausgestellt.
Diese Felder vereinen drei Eigenschaften: hohe Wiederholung, klar definierte Kennzahlen und ein großer Kommunikationsaufwand zwischen BI-Teams und Fachbereichen. Genau hier können LLMs auf Basis eines sauberen Datenmodells spürbare Entlastung schaffen.
Management-Reporting und Ad-hoc-Analysen per natürlicher Sprache
Im Top-Management sind die Kernfragen oft ähnlich: „Wie entwickeln sich Umsatz und Marge?“, „Wo weichen wir stark vom Plan ab?“, „Welche Werke liegen hinter der Zielvorgabe?“. Statt jede Frage als Ad-hoc-Report anzufragen, können Führungskräfte diese direkt an ein LLM-basiertes Interface stellen.
Der Mehrwert entsteht, wenn Antworten nicht nur Zahlen liefern, sondern auf existierende Berichte verweisen, die Definitionen erklären und Abweichungen sprachlich einordnen. So wird der klassische BI-Stack nicht ersetzt, sondern um einen dialogorientierten Zugang ergänzt.
Operative Steuerung in Produktion, Logistik und Service
In Produktion und Logistik geht es häufig um schnelle Ursachenanalysen: „Warum war Linie 3 gestern langsamer?“, „Welche Lieferanten verursachen die meisten Verzögerungen?“, „Wo häufen sich Serviceeinsätze?“. Diese Fragen lassen sich aus OEE-, Störgrund- und Lieferdaten beantworten – wenn sie integriert sind.
LLMs können hier helfen, Muster und Ausreißer zu beschreiben und relevante Detaildaten auf Knopfdruck zu liefern. Ein Schichtleiter muss dann nicht mehr mehrere Systeme parallel prüfen, sondern kann per natürlicher Sprache nachfragen und bekommt eine begründete Zusammenfassung auf Basis des BI-Modells.
Finanz- und Vertriebscontrolling: Forecasts und Szenarien
Forecasting ist ein klassisches Feld mit Spannungen zwischen Modellen und Fachwissen. KI-basierte Prognosen werden skeptisch gesehen, wenn ihre Treiber intransparent sind. AI BI kann hier ansetzen, indem LLMs Vorhersagen erklären, Szenarien beschreiben und Unsicherheiten transparent machen.
So kann ein Vertriebsleiter etwa fragen, wie sich der Forecast bei geänderten Annahmen zur Konversionsrate entwickelt, und erhält nicht nur eine Zahl, sondern auch eine Erläuterung, welche Segmente besonders sensitiv sind. Grundlage bleiben strukturierte Forecast-Daten und sauber modellierte Fakten.
Qualitätsmanagement und Ursachenanalysen
Im Qualitätsmanagement fallen viele strukturierte und unstrukturierte Daten an: Prüfprotokolle, Reklamationen, Messwerte, Serviceberichte. AI BI kann diese Daten verknüpfen und auffällige Kombinationen identifizieren, etwa bestimmte Chargen in Kombination mit bestimmten Lieferanten oder Schichten.
LLMs erleichtern es, diese Muster verständlich zu machen und mit konkreten Beispielen zu hinterlegen. Statt nur Ausreißer in einem Diagramm zu sehen, erhält der Qualitätsingenieur eine beschreibende Zusammenfassung mit Verweisen auf die zugrunde liegenden Datensätze.
Self-Service BI für Fachbereiche mit LLM-Unterstützung
Viele Unternehmen haben Self-Service-BI eingeführt, stoßen aber auf Akzeptanzgrenzen: Nicht jeder Bereich hat die Zeit oder das Know-how, eigene Datenmodelle und Reports zu bauen. LLMs können hier als Assistent agieren, der beim Formulieren von Abfragen, Filtern und Visualisierungen unterstützt.
Wichtig ist, dass dieser Self-Service auf einer kuratierten Datenbasis erfolgt, etwa auf vordefinierten Data Marts oder semantischen Modellen. So können Fachbereiche eigenständig arbeiten, ohne die BI-Architektur zu unterlaufen oder neue Schatten-Reports zu schaffen.
Praxisbeispiel Mittelstand: Wenn AI-BI wirklich in den Betrieb kommt
Ein fiktives, aber typisches Beispiel: Ein produzierendes Unternehmen mit mehreren Werken, rund 800 Mitarbeitenden und heterogenen Systemen möchte Entscheidungsprozesse im Management und in der Produktion beschleunigen. Bisher werden Monatsberichte über Excel konsolidiert, OEE-Auswertungen liegen in einzelnen Werken vor.
Die Geschäftsführung wünscht sich eine AI-gestützte BI-Lösung, die per natürlicher Sprache Antworten liefert und Ursachen für Abweichungen erklärt. Gleichzeitig ist das interne BI-Team klein, die IT stark ausgelastet – eine klassische Ausgangslage im industriellen Mittelstand.
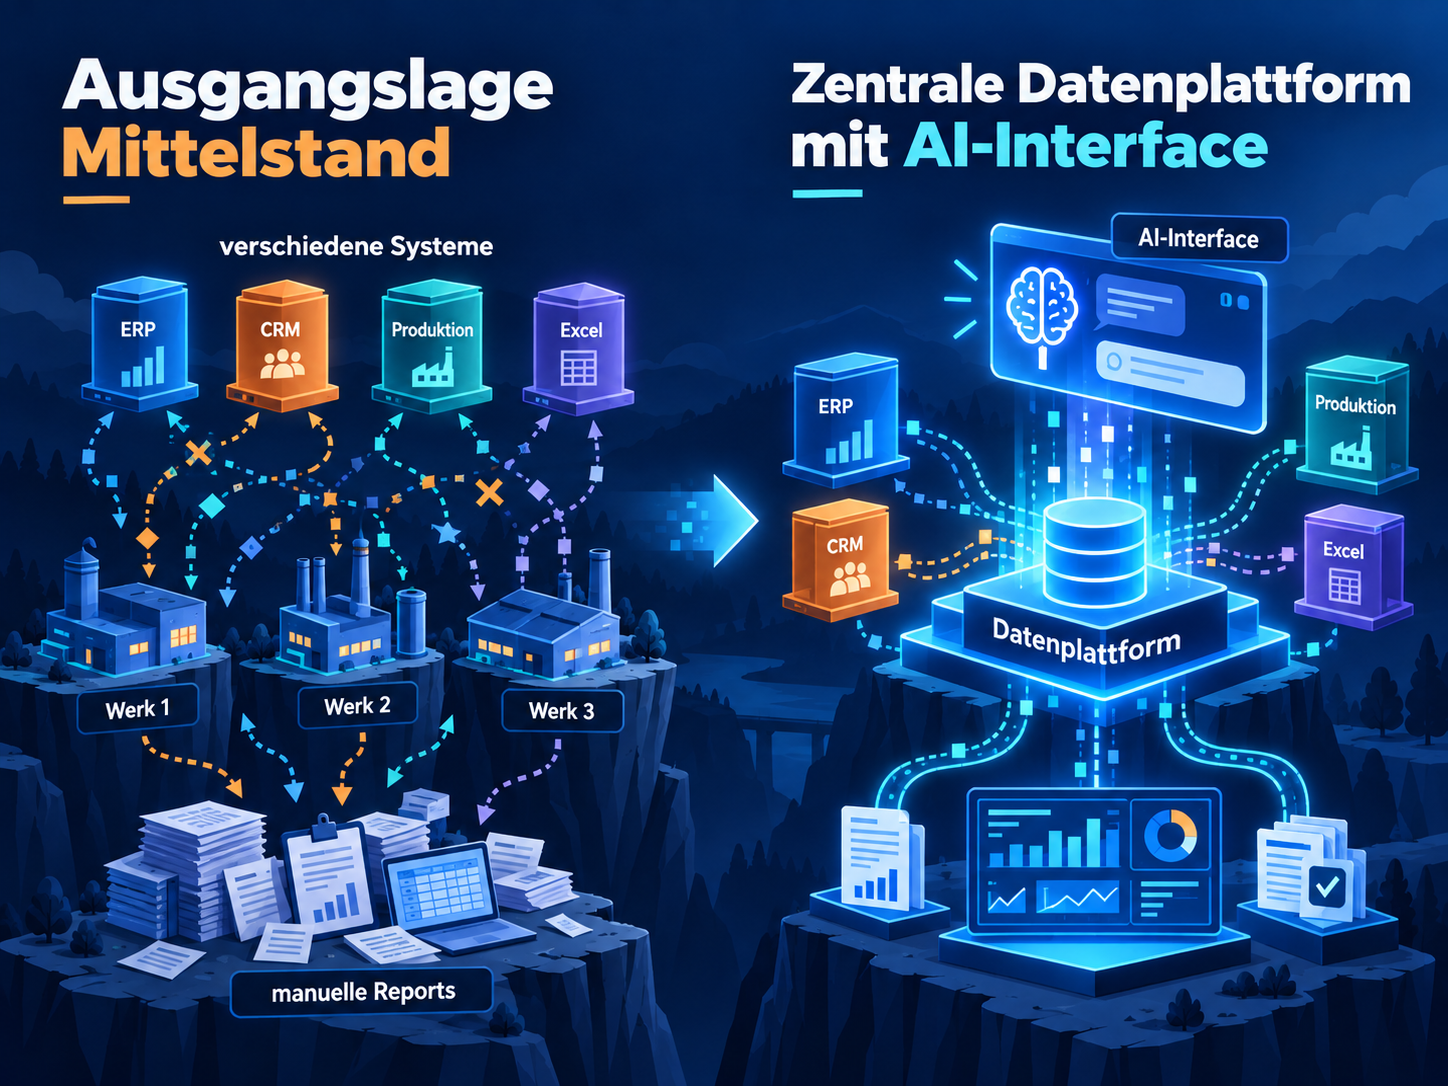
Ausgangslage: Heterogene Systeme, manuelle Reports, Reporting-Stau
Im Ist-Zustand liegen ERP-Daten in einem zentralen System, MES-Daten in werksspezifischen Lösungen und OEE-Berechnungen in Excel-Dateien einzelner Produktionsleiter. Das Controlling erstellt konsolidierte Management-Reports mit hohem manuellem Aufwand, Ad-hoc-Fragen müssen separat beantwortet werden.
Erste Experimente mit einem generischen LLM-Chatbot, der auf exportierte CSV-Dateien zugreift, beeindrucken zwar, liefern aber bei engerer Prüfung widersprüchliche Zahlen. Schnell wird klar: Ohne zentrale Datenbasis und abgestimmte Kennzahlen kann das System keinen produktiven Status erreichen.
Schritt 1: Aufbau eines konsistenten BI-Datenmodells
Das Unternehmen entscheidet sich, zunächst ein konsistentes BI-Datenmodell zu etablieren. Im Fokus stehen Auftragsdaten, Produktionsereignisse und Stillstandsgründe. Gemeinsam mit Produktion und Controlling werden Entitäten, Schlüssel und zentrale Kennzahlen definiert.
Auf dieser Basis entsteht ein Data Core mit klar getrennten Schichten: Rohdaten, harmonisierte Stammdaten und berechnete Kennzahlen. Die semantische Schicht dokumentiert OEE, Ausschussquote, Durchsatz und Liefertreue einheitlich – eine Voraussetzung, die zuvor nie systematisch geschaffen wurde.
Schritt 2: Automatisierte Datenintegration und Historisierung
Parallel werden ERP, MES und relevante Excel-Quellen über Konnektoren angebunden. Tägliche Datenbeladungen, Plausibilitätsprüfungen und Fehlerlogs laufen automatisiert. Historische Zustände – etwa Maschinenkonfigurationen oder Schichtpläne – werden als Slowly Changing Dimensions abgebildet.
Schon dieser Schritt reduziert manuellen Aufwand im Controlling deutlich. Kennzahlen stehen täglich aktualisiert zur Verfügung, ohne dass Dateien manuell zusammengeführt werden müssen. BI-Reports gewinnen an Stabilität, und die Grundlage für KI-Nutzung wird sichtbar belastbarer.
Schritt 3: LLM-gestützte Auswertung auf Basis des BI-Modells
Erst jetzt wird ein LLM auf das System gesetzt. Über eine AI-Schnittstelle greift es auf den Datenkatalog, KPI-Definitionen und freigegebene Data Marts zu. Produktionsleiter können Fragen stellen wie „Welche drei Hauptgründe gab es für OEE-Abweichungen auf Linie 2 in den letzten vier Wochen?“.
Das LLM liefert nicht nur eine Liste von Gründen, sondern beschreibt die wichtigsten Treiber textlich und verlinkt auf Detailreports. Antworten sind reproduzierbar, da sie auf denselben Kennzahlen basieren wie die bestehenden Dashboards. Fehlerfälle werden protokolliert und fließen in die Weiterentwicklung ein.
Ergebnisse: Schnellere Entscheidungen, höheres Vertrauen, geringere IT-Last
Im Ergebnis verkürzt sich die Zeit, um Ursachen für Produktionsabweichungen zu identifizieren, deutlich. Das Management erhält im Monatsabschluss automatisch generierte Kommentierungen, die auf denselben Zahlen beruhen wie die etablierten Reports, und muss nicht mehr auf manuelle Erläuterungen warten.
Gleichzeitig gehen weniger Ad-hoc-Anfragen an das BI-Team ein, weil viele Fragen direkt über das LLM-Interface beantwortet werden. Die Fachbereiche entwickeln Vertrauen, weil jede KI-Antwort im Zweifel auf einen bekannten Report oder eine definierte Kennzahl zurückgeführt werden kann. AI BI wird damit Teil des regulären Betriebs, nicht ein Experiment.
Checkliste: Ist Dein Unternehmen bereit für KI-gestützte BI?
Nicht jedes Unternehmen muss sofort mit vollumfänglicher AI-BI starten. Aber es hilft, den eigenen Reifegrad ehrlich einzuschätzen. Die folgende Checkliste bietet eine strukturierte Sicht auf Daten, Organisation und Use Cases – und zeigt, wo Du pragmatisch ansetzen kannst.
Die Einschätzung muss nicht perfekt sein. Wichtig ist, dass BI, IT und Fachbereiche ein gemeinsames Bild entwickeln, statt mit unterschiedlichen Erwartungen in ein AI-Projekt zu gehen.
| Themenfeld | Frage | Ja / Teilweise / Nein |
|---|---|---|
| Datenintegration | Gibt es eine zentrale Plattform, auf der ERP-, CRM- und Produktionsdaten automatisiert zusammengeführt werden? | |
| Datenqualität | Sind für kritische Datenquellen Mindestregeln zur Vollständigkeit, Aktualität und Plausibilität etabliert? | |
| KPI-Definitionen | Existiert ein abgestimmter Katalog für zentrale Kennzahlen wie Umsatz, DB, OEE oder Liefertreue? | |
| Semantische Schicht | Sind Entitäten, Beziehungen und Kennzahlen in einem semantischen Modell oder Datenkatalog dokumentiert? | |
| Governance & Rechte | Gibt es ein Rollen- und Berechtigungskonzept, das auch für Self-Service-BI funktioniert? | |
| AI Governance | Sind Zuständigkeiten und Leitlinien für den Einsatz von KI im Unternehmen definiert (inkl. DSGVO/AI Act)? | |
| Use Cases | Sind 1–3 konkrete, geschäftsrelevante AI-BI-Use Cases mit klaren Zielen priorisiert? | |
| Ressourcen | Gibt es ein Kernteam aus BI/IT und Fachbereich, das einen ersten Use Case begleiten kann? |
Daten & Technologie: Was heute schon vorhanden sein sollte
Ideal ist, wenn bereits ein Data Warehouse oder eine zentrale BI-Plattform existiert, auch wenn sie noch nicht perfekt ist. Wichtig sind reproduzierbare Datenbeladungen, ein Mindestmaß an Historisierung und erste dokumentierte Datenflüsse.
Falls heute alles über manuelle Exporte und Excel läuft, lohnt es sich, zunächst die Grundlagen aufzubauen – etwa mit einer automatisierten Datenplattform wie bimanu One –, bevor LLMs ins Spiel kommen. So vermeidest Du, Fehlerquellen nur zu verschieben.
Organisation & Governance: Rollen, Prozesse, Verantwortung
Auch ohne großes Data-Team braucht es klare Verantwortlichkeiten. Ein Data Owner für zentrale Kennzahlen, ein BI-Verantwortlicher und ein Ansprechpartner im Fachbereich reichen oft aus, um einen ersten Use Case umzusetzen.
Gleichzeitig sollten grundlegende Leitlinien für KI-Nutzung definiert werden: Welche Daten dürfen in KI-Prozesse einfließen? Wie werden Fehler behandelt? Wer entscheidet über neue Anwendungsfälle? Diese Fragen früh zu klären spart später viel Abstimmungsaufwand.
Use Cases & Business Value: Wo der Einstieg sich wirklich lohnt
Besonders geeignet für den Start sind Use Cases mit hohem Kommunikationsaufwand und klaren KPIs, etwa Monatsberichte, Produktionsanalysen oder Standardfragen aus dem Vertrieb. Hier lässt sich der Mehrwert von AI BI – etwa durch Zeitersparnis oder reduzierte Fehler – gut messen.
Weniger geeignet sind abstrakte „KI-Labore“ ohne konkrete Fachanbindung. Wenn Fachbereiche keinen direkten Nutzen sehen, bleibt AI BI ein Experiment im technischen Umfeld, das bei der nächsten Budgetrunde leicht gestrichen wird.
Quick Wins vs. strategische Roadmap
Ein erster AI-BI-Use Case sollte als Quick Win ausgelegt sein, aber in eine strategische Roadmap eingebettet werden. Diese Roadmap beschreibt, welche weiteren Datenbereiche, Kennzahlen und Fachbereiche in welcher Reihenfolge folgen können.
So entsteht Schritt für Schritt eine AI-BI-Landschaft, die auf einem wachsenden Datenfundament basiert, statt aus isolierten POCs zu bestehen. Plattformen wie bimanu One unterstützen genau diesen Weg mit automatisierter Datenintegration, Modellierung und Governance.
bimanu One als Fundament für AI Business Intelligence mit LLMs
Viele der beschriebenen Hürden entstehen, weil KI- und BI-Welt getrennt voneinander gedacht werden: Hier das LLM, dort das Data Warehouse, dazwischen eine fragile Integrationsstrecke. bimanu One setzt genau an dieser Stelle an und versteht AI + BI als gemeinsame Plattform – Contextual Intelligence.
Anstatt nur ein weiteres Tool in die Landschaft zu stellen, liefert bimanu One ein schlüsselfertiges Fundament: von der Datenanbindung über ein skalierbares Data Warehouse bis hin zu BI- und KI-Funktionen, die auf demselben Datenkern aufsetzen. So wird der Weg vom PoC in den Betrieb deutlich kürzer.
Contextual Intelligence: Warum AI + BI = CI
bimanu One ist als Contextual Intelligence Plattform konzipiert: KI-Analysen greifen nicht auf Rohdaten zu, sondern auf ein fachlich und technisch sauberes BI-Modell. Damit wird sichergestellt, dass jede KI-Auswertung im selben Kontext stattfindet wie klassische Reports und Dashboards.
Praktisch heißt das: Ein LLM, das auf bimanu One aufsetzt, arbeitet immer mit klar definierten KPIs, Dimensionen und Datenbeziehungen. BI liefert den Kontext, KI liefert die Geschwindigkeit und Zugänglichkeit – nicht umgekehrt.
Integrierte Plattform: Datenintegration, Data Warehouse, BI und KI aus einer Hand
Mit bimanu One bekommst Du Datenintegration, automatisierte Modellierung, Data Warehouse-Betrieb, Monitoring und KI-Funktionen in einer Plattform. Du musst keine einzelnen Komponenten zusammenbauen und betreiben, sondern arbeitest auf einem durchgängigen Datenstrom.
Das reduziert Projektkomplexität spürbar. Anstatt separate Projekte für ETL, DWH, BI-Frontend und KI-Anbindung aufzusetzen, entsteht eine einheitliche Architektur, die Fachbereiche und IT gemeinsam nutzen können – ein wichtiger Faktor, um Initiativen tatsächlich in den Betrieb zu bringen.
Automatisiertes, belastbares Datenmodell als KI-Kontext
Ein zentrales Element von bimanu One ist der Data-Core-Ansatz mit automatisch generierten Data Marts. BRUNATA-METRONA berichtet zum Beispiel, dass damit ein vollständig nutzbares BI-Datenmodell entsteht, das Datenbasis und Reporting klar trennt und flexibel auf neue Anforderungen reagiert.
Für LLMs bedeutet das: Sie greifen auf ein getestetes, versioniertes Modell mit einheitlichen KPI-Definitionen zu, statt auf verstreute Rohdaten. Das senkt das Risiko fehlerhafter Antworten deutlich und macht AI-BI-Ausgaben nachvollziehbar und auditierbar.
Schneller Start mit vorkonfigurierten Konnektoren für ERP, CRM und IoT
bimanu One bringt mehr als 50 vorkonfigurierte Konnektoren für gängige ERP-, CRM- und IoT-Systeme mit. Das reduziert den Integrationsaufwand drastisch und beschleunigt die Zeit bis zu ersten belastbaren Datenmodellen.
Gerade im Mittelstand, wo interne IT-Ressourcen knapp sind, ist dieser schnelle Einstieg entscheidend. Statt monatelangen Integrationsprojekten kannst Du in kurzer Zeit einen ersten Use Case mit realen Daten aufsetzen – eine wichtige Voraussetzung, um AI-BI-Initiativen intern zu verankern.
Snowflake-Cloud als skalierbares technisches Rückgrat
Technisch baut bimanu One auf der Snowflake-Cloud auf, die sich in beide Richtungen automatisch skalieren lässt. Damit wächst die Plattform mit Deinen Anforderungen, ohne dass Du Dich um Hardware, Tuning oder Kapazitätsplanung kümmern musst.
Für AI-BI-Use Cases bedeutet das: Zusätzliche Datenvolumina, neue Werke, weitere Gesellschaften oder zusätzliche Nutzer lassen sich ohne grundlegenden Architekturwechsel integrieren. Die technische Skalierung wird vom System übernommen, nicht von Deinem Team.
Kein eigener BI-Admin nötig: Betrieb, Updates, Onboarding und Academy
Ein weiterer Vorteil: Hosting, Betrieb und Updates übernimmt bimanu. Dazu kommen Onboarding, Coaching und die bimanu Academy, die internes Wissen im Unternehmen aufbaut und Dich unabhängig von einzelnen Experten macht.
Für viele Mittelständler ist genau das der Engpass: Es fehlt weniger an Tools als an Menschen, die sie betreiben können. bimanu One reduziert diesen Bedarf und erlaubt es Fachbereichen, über Low-Code-Mechanismen fachliche Anforderungen direkt einzubringen, ohne tief in SQL oder ETL einzusteigen.
Datenschutz & Compliance: EU-Hosting, DSGVO, deutschsprachiger Support
bimanu One wird in der EU gehostet, mit Serverstandorten in Deutschland und entsprechenden Verträgen zur Auftragsverarbeitung nach Art. 28 DSGVO. Das vereinfacht Compliance-Prüfungen und reduziert rechtliche Unsicherheiten im Vergleich zu rein US-zentrierten Lösungen.
Ergänzt wird das durch deutschsprachigen Support und Dokumentation, was gerade bei sensiblen Themen wie AI Governance, AI Act und internen Audits ein praktischer Vorteil ist. So wird AI-BI zu einem kontrollierbaren Bestandteil Deiner IT-Landschaft.
Frontend-offen: Weiterarbeit mit bestehenden Reporting-Tools
bimanu One ist Frontend-offen. Das bedeutet: Du musst bestehende Tools wie Power BI, Qlik oder SAP Analytics Cloud nicht ablösen. Unternehmen wie die HABA FAMILYGROUP nutzen zum Beispiel SAP Analytics Cloud auf der bimanu-Plattform als Datenbasis.
Für AI BI ist das wichtig, weil Du LLM-Funktionalitäten ergänzen kannst, ohne Dashboards, die heute funktionieren, neu aufzubauen. Die Plattform liefert das konsistente Datenfundament, auf das verschiedene Visualisierungs- und KI-Interfaces zugreifen – je nach Bedarf der Fachbereiche.
AI Business Intelligence strategisch planen: Nächste Schritte für Entscheider
Wenn Du AI Business Intelligence nicht als kurzfristigen Trend, sondern als Teil Deiner Datenstrategie begreifst, verschieben sich die Leitfragen. Es geht dann weniger darum, „welches LLM am besten ist“, sondern darum, wie Du BI-Architektur, Governance und KI-Funktionen so kombinierst, dass sie Deinen Betrieb dauerhaft unterstützen.
Die gute Nachricht: Du musst nicht alles gleichzeitig lösen. Mit einem klaren Zielbild und einem strukturierten Vorgehen lassen sich schnelle Erfolge erzielen, ohne den Realitätsbezug zu verlieren. Wichtig ist, dass BI und KI nicht als getrennte Welten behandelt werden.
Realistische Erwartungen an LLM-basierte BI im Mittelstand
LLMs können die Arbeit mit Daten deutlich erleichtern, aber sie sind kein Ersatz für BI-Architektur und Datenstrategie. Erwarte keine perfekte Antwortmaschine für jede Frage aus dem Stand, sondern ein System, das definierte Anwendungsfälle schneller, zugänglicher und verständlicher macht.
Gleichzeitig solltest Du klar kommunizieren, dass Mensch und Maschine zusammenarbeiten: LLM-Antworten sind fachlich zu prüfen, kritische Entscheidungen brauchen weiterhin menschliche Freigabe, und Modelle werden schrittweise verbessert. So entsteht Vertrauen, statt falscher Erwartungen.
Roadmap: Von klassischer BI zu AI-gestützter Entscheidungsunterstützung
Eine sinnvolle Roadmap beginnt meist mit der Stabilisierung der bestehenden BI: zentrale Datenplattform, harmonisierte KPIs, saubere Governance. Darauf aufbauend folgt ein erster AI-BI-Use Case mit hohem Nutzen und begrenztem Scope, etwa im Controlling oder in der Produktion.
In einem nächsten Schritt können weitere Fachbereiche angebunden und zusätzliche KI-Funktionen integriert werden, etwa Prognosen oder automatisierte Narratives. Wichtig ist, regelmäßig zu prüfen, wie stark AI-BI tatsächlich genutzt wird und welche Hindernisse im Alltag auftreten.
Make or Buy: Eigenbau vs. spezialisierte Plattform
Grundsätzlich kannst Du AI-BI-Funktionalitäten auch selbst bauen, etwa mit einem Cloud-Data-Warehouse, einem BI-Tool, einem LLM-Service und eigenen Orchestrierungen. Das erfordert jedoch erhebliches Architektur- und Engineering-Know-how sowie Ressourcen für Betrieb und Governance.
Für viele Mittelständler ist daher eine spezialisierte Plattform wie bimanu One die pragmatischere Wahl. Sie reduziert Integrationsaufwand, verkürzt Projektlaufzeiten und übernimmt einen Großteil des technischen Betriebs – ohne Dich in der Wahl von Frontends oder konkreten Use Cases einzuschränken.
Wie Du Fachbereiche frühzeitig einbindest und Vertrauen schaffst
Erfolgreiche AI-BI-Projekte entstehen nicht im stillen Kämmerlein der IT. Binde Fachbereiche von Anfang an ein, etwa über gemeinsame Use-Case-Workshops, Validierungssessions und klare Kommunikationslinien zu Zielen und Grenzen der KI-Unterstützung.
Nutze Pilotgruppen im Controlling, in der Produktion oder im Vertrieb, um frühes Feedback zu sammeln und Quick Wins sichtbar zu machen. Wenn Fachbereiche sehen, dass ihre Fragen schneller beantwortet werden und sie die Ergebnisse nachvollziehen können, entsteht Akzeptanz – und AI Business Intelligence wird zum festen Bestandteil Eurer Entscheidungsprozesse.

AI Business Intelligence – Häufige Fragen aus dem Mittelstand
Welche AI Business Intelligence Tools eignen sich besonders für mittelständische Unternehmen?
Für den Mittelstand eignen sich vor allem Plattformen, die Datenintegration, Data Warehouse und KI-Funktionen kombinieren, statt nur ein weiteres Dashboard bereitzustellen. Lösungen wie bimanu One bieten hier einen Vorteil, weil sie speziell auf mittelständische Strukturen und begrenzte IT-Ressourcen ausgelegt sind.
Ergänzend dazu können etablierte Frontends wie Power BI, Qlik oder SAP Analytics Cloud weiter genutzt werden, während die AI-Funktionen über eine zentrale Datenbasis eingebunden werden. Wichtig ist weniger der Markenname, sondern die Fähigkeit, einheitliche Kennzahlen und Governance sicherzustellen.
Wie viel kostet der Einsatz von KI in Business Intelligence typischerweise?
Die Kosten hängen stark vom gewählten Ansatz ab: Eigenbau mit Einzelkomponenten verursacht initial höhere Projekt- und Integrationskosten, während Plattformlösungen oft mit planbaren, nutzungsbasierten Gebühren arbeiten. Hinzu kommen Aufwände für Workshops, Datenaufbereitung und Governance, die nicht unterschätzt werden sollten.
Sinnvoll ist, Kosten immer im Verhältnis zum Nutzen zu betrachten: eingesparte Stunden im Reporting, schnellere Entscheidungen, geringere Fehlerrisiken. Ein klar abgegrenzter erster Use Case mit messbarem Business Value hilft, Budgets zu rechtfertigen und Folgeinvestitionen zu begründen.
Welche Voraussetzungen müssen meine Daten erfüllen, bevor ich LLMs darauf einsetzen kann?
Deine Daten sollten mindestens integriert, historisiert und durch grundlegende Qualitätsregeln abgesichert sein. Dazu gehören einheitliche IDs, klare Zeitbezüge und definierte Beziehungen zwischen Stammdaten und Bewegungsdaten, wie sie in einem Data Warehouse üblich sind.
Zusätzlich brauchst Du zumindest für einen ersten Use Case sauber definierte KPIs und eine einfache semantische Schicht, damit das LLM weiß, welche Tabellen und Felder zu welchen Kennzahlen gehören. Ohne diese Basis riskierst Du, dass Antworten zufällig richtig, aber nicht reproduzierbar sind.
Wie gehe ich mit Halluzinationen von LLMs um, wenn es um kritische Business-Kennzahlen geht?
Halluzinationen lassen sich nicht vollständig vermeiden, aber deutlich reduzieren. Nutze RAG über einen kuratierten Datenkatalog und semantische Schicht, begrenze das LLM auf definierte Datenmarts und implementiere Regeln, dass bei Unsicherheiten lieber keine Antwort als eine erfundene Zahl geliefert wird.
Zusätzlich solltest Du eine menschliche Validierung für kritische Kennzahlen vorsehen und Logging nutzen, um auffällige Antworten zu identifizieren und systematisch nachzubessern. So wird das System iterativ stabiler, ohne dass Fehlantworten unbemerkt in Entscheidungen einfließen.
Wie unterscheidet sich AI Business Intelligence von klassischer BI mit Reporting und Dashboards?
Klassische BI liefert vordefinierte Dashboards und Reports, die bestimmte Fragen gut beantworten, aber bei Ad-hoc-Fragen schnell an Grenzen stoßen. AI BI ergänzt diese Welt um natürliche Sprachabfragen, automatische Ausreißererkennung und erklärende Texte.
Technisch basieren beide auf derselben Datenplattform und denselben Kennzahlen, wenn sie sauber aufgebaut sind. Der Unterschied liegt vor allem in der Art der Interaktion und der Automatisierung von Analyseschritten, nicht im Ersatz bestehender BI-Komponenten.
Kann ich LLM-basierte BI nutzen, obwohl meine Daten noch in vielen Inselsystemen liegen?
Direkt auf Inselsystemen aufzusetzen ist riskant, weil das LLM dann mit widersprüchlichen und schlecht verknüpften Daten arbeiten muss. Besser ist, zunächst eine zentrale Datenbasis für einen klar abgegrenzten Bereich aufzubauen und diese als Fundament für einen ersten AI-BI-Use Case zu nutzen.
Plattformen wie bimanu One helfen dabei, Daten aus ERP, CRM und weiteren Systemen schnell zu integrieren und zu harmonisieren. So kannst Du mit einem fokussierten Scope starten, statt auf den „perfekten Zustand“ der gesamten Datenlandschaft zu warten.
Wer sollte im Unternehmen die Verantwortung für AI-gestützte BI tragen?
Fachlich sollte die Verantwortung bei den Data Ownern der betroffenen Kennzahlen liegen, in enger Zusammenarbeit mit Controlling oder den jeweils verantwortlichen Fachbereichen. Technisch tragen BI- und IT-Teams die Verantwortung für Datenplattform, Zugriffe und Betrieb.
In vielen Unternehmen bewährt sich ein gemeinsames Steering aus BI, IT und Business-Vertretern, ergänzt um eine Rolle für AI Governance oder Data Governance. So ist sichergestellt, dass sowohl Datenqualität als auch fachlicher Nutzen und regulatorische Anforderungen im Blick bleiben.
Wie stelle ich sicher, dass AI Business Intelligence DSGVO- und compliance-konform betrieben wird?
Zunächst solltest Du klären, welche personenbezogenen Daten in AI-BI-Prozessen überhaupt verarbeitet werden müssen und wo Pseudonymisierung oder Aggregation ausreichen. Danach sind Hosting-Standort, Auftragsverarbeitung nach Art. 28 DSGVO und technische Schutzmaßnahmen wie Verschlüsselung und Zugriffskontrollen zu prüfen.
Ergänzend braucht es Prozesse für Betroffenenrechte, Fehlerkorrekturen und Audits. Plattformen mit EU-Hosting und integrierter Governance, wie bimanu One, erleichtern diese Aufgaben, ersetzen aber nicht die interne Verantwortung für Datenschutz und Compliance.
Wie lange dauert es, bis ein erster produktiver AI-BI-Use-Case live gehen kann?
Die Dauer hängt stark von der Ausgangslage ab. Wenn bereits ein Data Warehouse und ein BI-Modell existieren, kann ein fokussierter AI-BI-Use Case innerhalb weniger Wochen pilotiert und produktiv gesetzt werden, vor allem wenn eine vorkonfigurierte Plattform genutzt wird.
Muss die Datenbasis komplett neu aufgebaut werden, solltest Du mehrere Monate einplanen – allerdings entsteht dabei ein Mehrwert, der weit über den einzelnen AI-Use Case hinausgeht. Entscheidend ist, mit einem klaren Scope zu starten und nicht auf eine „perfekte“ Gesamtarchitektur zu warten.
Wird der klassische BI-Analyst durch AI Business Intelligence überflüssig?
Im Gegenteil: AI BI verschiebt den Fokus von manuellen Datenaufbereitungen hin zu Modellierung, Governance und fachlicher Beratung. BI-Analysten werden wichtiger als Schnittstelle zwischen Fachbereich, Datenplattform und KI-Systemen, weil sie die Geschäftslogik verstehen und in Modelle übersetzen.
LLMs können Standardabfragen und einfache Auswertungen übernehmen, aber sie ersetzen nicht die Aufgaben, komplexe Anforderungen zu strukturieren, sinnvolle Kennzahlen zu definieren und die Qualität der Ergebnisse zu bewerten. Gut aufgestellte BI-Teams werden durch AI BI eher entlastet als verdrängt.