
Talk to Database: KI-Datenanalyse ohne Reporting-Engpass
In vielen mittelständischen Unternehmen hängen Entscheidungen immer noch an wenigen Reports und überlasteten BI-Teams. Fachbereiche stellen Fragen, Tickets werden eröffnet, Excel-Exporte verschickt – und bis eine fundierte Antwort vorliegt, sind Marktchancen oder Budgetrunden oft schon vorbei.
Talk to Database setzt genau hier an. Ein Sprachmodell übersetzt Deine Frage in natürlicher Sprache direkt in Datenbankabfragen und liefert Antworten in Sekunden – auf Basis einer sauberen Datenbasis und klar definierter Kennzahlen. In diesem Artikel erfährst Du, wie das funktioniert, wo die Grenzen liegen und welche Voraussetzungen Deine Datenlandschaft erfüllen muss, damit KI-Datenanalyse wirklich verlässlich wird.
Reporting-Engpass im Mittelstand: Warum Fachbereiche auf Antworten warten
In der Praxis sieht das so aus: Vertrieb, Produktion oder Controlling arbeiten mit vordefinierten Monats- und Quartalsreports. Sobald eine Frage auftaucht, die nicht exakt in diese Sichten passt, wird ein neues Reporting „beauftragt“. Die Folge ist eine stetig wachsende Warteschlange an BI-Anfragen.
Laut Statistischem Bundesamt nutzte 2024 bereits jedes fünfte Unternehmen in Deutschland mit mindestens zehn Beschäftigten KI. Die häufigsten Gründe gegen den Einsatz sind fehlendes Wissen und Unklarheit über die rechtlichen Folgen. Genau dieselben Faktoren sorgen auch im Reporting dafür, dass Teams nicht schnell genug mit den eigenen Daten arbeiten können.
Typische Reporting-Prozesse in mittelständischen Unternehmen
Üblicherweise startet ein Reporting-Prozess mit einer fachlichen Frage, etwa im Vertrieb: „Wie hat sich die Marge in Region Süd im letzten Quartal entwickelt?“ Diese Frage wandert als Ticket oder E-Mail ans BI-Team, oft mit unklaren Begriffen und ohne feste Priorität.
Das BI-Team klärt Rückfragen, identifiziert Datenquellen, baut eine Abfrage im Data Warehouse oder ERP und bereitet das Ergebnis in einem Power-BI-Report oder einer Excel-Datei auf. Bis zur finalen Freigabe und Verteilung vergeht schnell eine Woche – und jede Variante der Frage erzeugt einen neuen Analysezyklus.
Wo heute Zeit verloren geht: BI-Team, IT, Excel-Reports, E-Mail-Schleifen
Zeit geht vor allem in Übergaben verloren: Der Fachbereich formuliert vage, das BI-Team übersetzt, die IT stellt Daten bereit, und am Ende wird per E-Mail diskutiert, ob die Zahl wirklich „stimmt“. Oft müssen BI-Teams mehrfach nacharbeiten, weil Definitionen unklar waren oder neue Filter gewünscht sind.
Parallel entstehen Schattenreports in Excel: Mitarbeitende exportieren Daten aus ERP oder CRM, ergänzen eigene Berechnungen und verteilen sie intern weiter. Diese Zahlen sind selten versioniert, kaum nachvollziehbar und weichen nicht selten von den offiziellen BI-Zahlen ab.
Warum Dashboards oft nur bekannte Fragen beantworten
Dashboards sind stark für wiederkehrende, bekannte Fragen: Umsatz nach Region, OEE nach Linie, offene Aufträge. Sie sind wichtig für Steuerung und Vergleichbarkeit, aber sie sind bewusst stabil und wenig flexibel gebaut. Neue Fragestellungen lassen sich dort nur begrenzt abbilden.
Wenn Du z. B. kurzfristig wissen willst, „Welche Kunden mit mehr als 500.000 € Jahresumsatz haben ihr Bestellvolumen in den letzten 90 Tagen um mehr als 20 % reduziert?“, findest Du diese Kombination in einem Standard-Dashboard selten. Genau solche Fragen treiben aber operative Entscheidungen.
Geschäftliche Folgen langsamer Datenanalysen für Steuerung und Planung
Langsame Analysen führen nicht nur zu Frust, sondern zu konkreten Risiken. Wenn ein Produktionsleiter erst im Monatsabschluss sieht, dass Ausschuss in einer Linie stark gestiegen ist, ist der Schaden bereits entstanden. Wenn der Vertrieb zu spät erkennt, dass wichtige Kunden ihr Bestellvolumen senken, ist es schwerer gegenzusteuern.
Der Effekt: Entscheidungen wandern zurück aufs Bauchgefühl, Forecasts basieren auf veralteten Zahlen, und Teams gewöhnen sich an den Zustand, dass „man eben warten muss“. Genau hier setzt KI-Datenanalyse mit Talk to Database an – sie macht Ad-hoc-Fragen ohne Umweg über BI-Teams möglich, ohne Governance über Bord zu werfen.
Was ist „Talk to Database“? (Definition und Einordnung)
Talk to Database ist ein Ansatz, bei dem ein Sprachmodell (LLM) Deine Frage in natürlicher Sprache direkt in eine Datenbankabfrage übersetzt, diese ausführt und das Ergebnis verständlich zurückgibt. Technisch liegt dahinter meist Text-to-SQL auf einer kuratierten Datenbasis.
Wichtig ist die Abgrenzung: Talk to Database ist keine magische Blackbox, sondern eine zusätzliche Zugriffsschicht auf Deine existierenden Datenmodelle und Kennzahlen. Sie ersetzt weder das Data Warehouse noch klassische BI, sondern macht sie flexibler nutzbar.
Von natürlicher Frage zur Datenbankabfrage: Text-to-SQL kurz erklärt
Beim Text-to-SQL-Ansatz zerlegt das Sprachmodell zunächst Deine Frage: Welche Metrik ist gemeint, welche Filter, welcher Zeitraum? Dann wird entschieden, welche Tabellen und Spalten im Datenmodell relevant sind und wie sie verknüpft werden müssen.
Daraus generiert das System eine SQL-Abfrage, führt sie gegen Dein Data Warehouse oder Deinen Data Mart aus und strukturiert das Ergebnis. Moderne Systeme prüfen zusätzlich Plausibilitäten, zum Beispiel Zeilenanzahlen oder Zeitfilter, bevor Dir die Antwort präsentiert wird.
Unterschied zu Self-Service-BI, Query-Buildern und klassischen Reports
In Self-Service-BI-Tools müssen Nutzer Felder ziehen, Filter setzen und Visualisierungen selbst zusammenstellen. Das ist mächtig, erfordert aber einiges an Tool-Know-how und Verständnis für das Datenmodell. Viele Fachanwender wollen diese Tiefe nicht aufbauen.
Talk to Database verschiebt die Interaktion auf Sprachebene: Du formulierst Deine Frage direkt („Zeig mir den Umsatz im Maschinenbau nach Region für Q3 im Vergleich zu Q2“) und erhältst eine Antwort, ohne eine einzige Spalte auswählen zu müssen. Die Datenlogik bleibt im Hintergrund im Modell verankert.
Welche Rolle Sprachmodelle (LLMs) in der Datenanalyse spielen
LLMs sind hier vor allem Übersetzer und Assistent: Sie verstehen natürliche Sprache, kennen gängige Analysebegriffe und können SQL-Syntax erzeugen. In Kombination mit einem semantischen Modell wissen sie, dass „Marge“ in Deinem Unternehmen etwa „Deckungsbeitrag 1“ mit bestimmten Ausschlüssen bedeutet.
Zudem können LLMs Ergebnisse erklären („Die Marge ist gesunken, vor allem durch höheren Materialeinsatz in den Produktgruppen X und Y“) und Dir bei der Formulierung der nächsten Frage helfen. Sie werden damit zu einem dialogfähigen Frontend auf Deiner Datenplattform.
Wie sich Talk to Database in bestehende BI-Landschaften einfügt
Technisch sitzt Talk to Database oberhalb Deines bestehenden Data Warehouse oder Lakehouse. Es nutzt die gleichen Datenmodelle, Kennzahlendefinitionen und Berechtigungen, die auch Deine BI-Reports verwenden. Idealerweise greift es auf einen semantischen Layer zu, in dem Geschäftslogik zentral definiert ist.
Dashboards bleiben weiterhin wichtig für Standardsteuerung und Management-Reporting. Talk to Database ergänzt diese Welt dort, wo spontane, nicht vorgeplante Fragen auftauchen, und schafft so eine Brücke zwischen klassischen Reports und explorativer Analyse.
Kostenloses Erstgespräch vereinbaren
So funktioniert KI-Datenanalyse mit Talk to Database – Schritt für Schritt
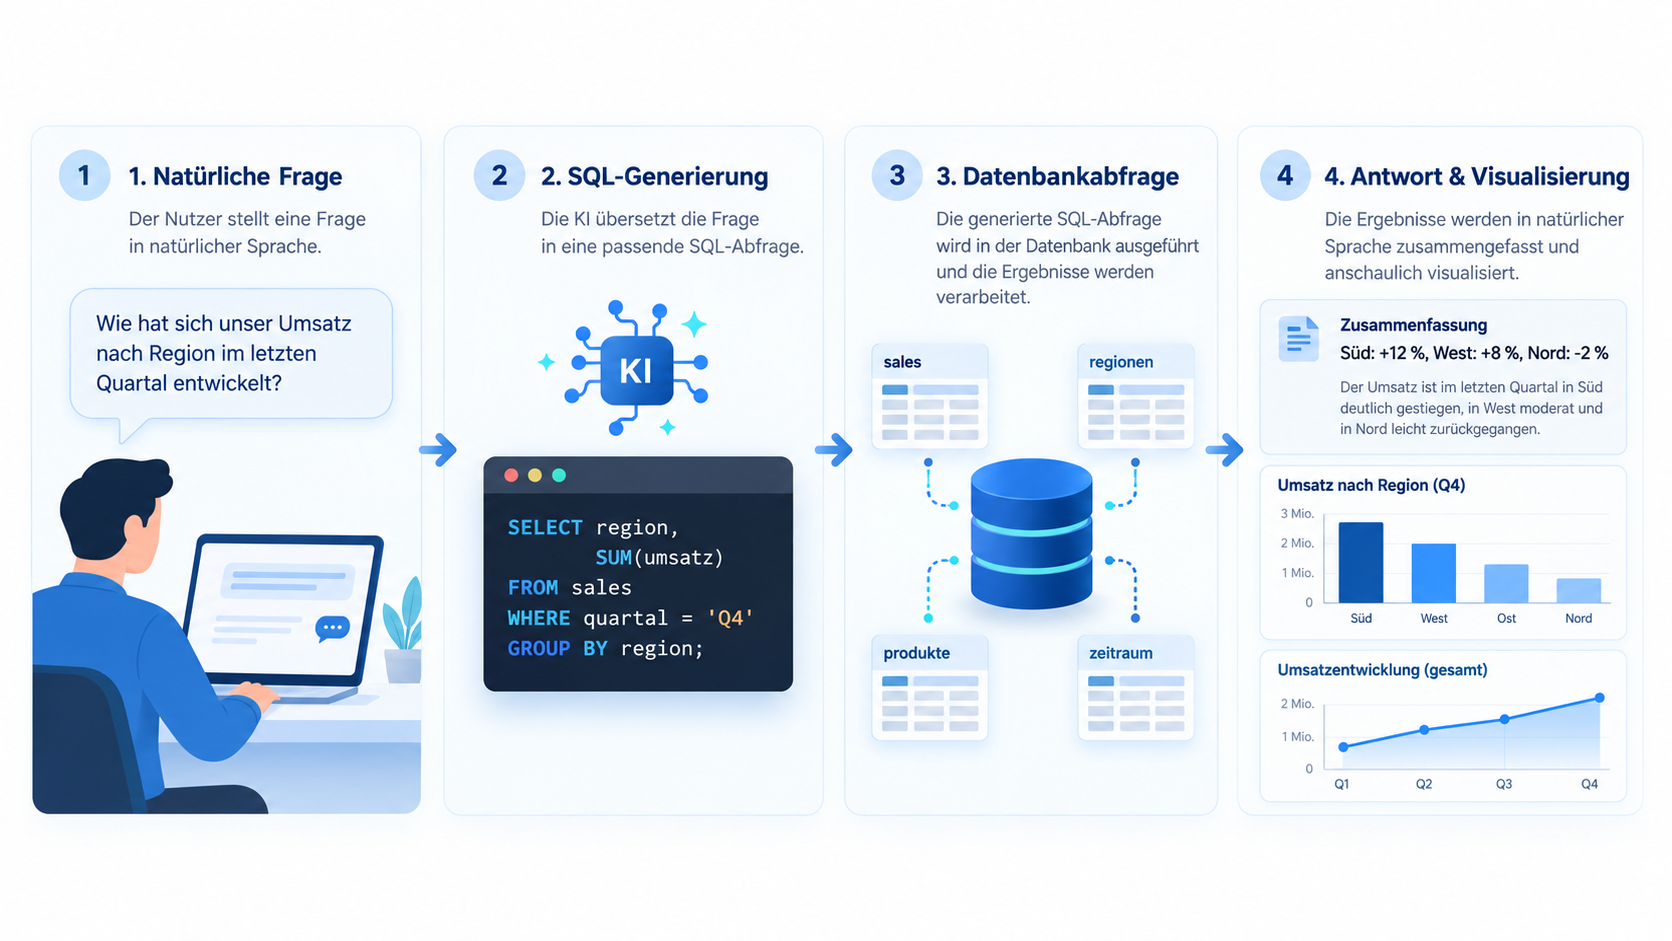
1. Die Frage in natürlicher Sprache formulieren
Am Anfang steht immer eine konkrete Frage aus dem Fachbereich, zum Beispiel: „Warum ist unsere Marge im Q3 in Region Süd gegenüber Q2 zurückgegangen?“ Die Formulierung ist bewusst natürlich, ohne technische Begriffe oder Feldnamen.
Gute Systeme unterstützen Dich dabei aktiv, die Frage zu präzisieren. Sie schlagen etwa vor, ob sich die Frage auf einen bestimmten Produktbereich, Kundencluster oder eine Währung beziehen soll, bevor die eigentliche Abfrage generiert wird.
2. Übersetzung in eine strukturierte Anfrage (Prompt-Engineering, Text-to-SQL)
Das LLM analysiert die Frage und übersetzt sie in eine interne Repräsentation: Welche Metrik ist gemeint, welche Dimensionen sind angesprochen, welche Filter? Dabei greift es auf Informationen aus dem Datenkatalog oder dem Datenbankschema zurück, das erklärt, was „Region Süd“ oder „Marge“ fachlich bedeutet.
Anschließend erzeugt das System eine SQL-Abfrage, die genau diese Logik abbildet. In modernen Architekturen läuft dieser Schritt als Agentenprozess: Falls eine Abfrage scheitert oder unplausibel wirkt, korrigiert der Agent SQL oder fragt Dich nach Details.
3. Ausführung auf der Datenbank: Zugriff auf definierte Kennzahlen und Dimensionen
Die generierte Abfrage sollte nicht direkt gegen operative Systeme wie ERP oder MES laufen, sondern gegen eine analytische Schicht – typischerweise ein Data Warehouse wie Snowflake mit klaren Fakten- und Dimensionstabellen. So bleiben Produktivsysteme geschützt und Analysen performant.
Gleichzeitig greifen Talk-to-Database-Lösungen idealerweise auf einen semantischen Layer zu, in dem Kennzahlen wie Umsatz, Deckungsbeitrag oder Ausschuss bereits definiert sind. Dadurch rechnet das System immer mit derselben Logik, egal wer die Frage stellt.
4. Aufbereitung der Antwort: Tabellen, Visualisierungen, Erläuterungen
Das rohe SQL-Ergebnis ist meist eine Tabelle. Talk to Database bereitet diese automatisch als verständliche Ansicht auf – etwa als Zeitreihe, Top-10-Liste oder Balkendiagramm, je nachdem, was zur Frage passt. Zusätzlich kann das LLM die wichtigsten Punkte in Textform zusammenfassen.
Entscheidend ist die Transparenz: Nutzer sollten auf Wunsch immer sehen können, welche Abfrage gelaufen ist, welche Filter aktiv waren und welche Kennzahlendefinitionen verwendet wurden. Nur so entsteht Vertrauen in die Ergebnisse.
5. Iteratives Nachfragen: Drilldowns, Filter, Vergleiche
In der Praxis stellen Fachbereiche selten nur eine einzige Frage. Aus „Wie ist die Marge in Region Süd?“ werden schnell Anschlussfragen wie „Welche Produktgruppen tragen am stärksten zum Rückgang bei?“ oder „Ist das ein genereller Trend oder auf zwei Großkunden begrenzt?“.
Talk to Database erlaubt Dir, in demselben Dialog weiterzufragen. Das System behält Kontext, Filter und Zeiträume im Blick und generiert für jede Anschlussfrage neue Abfragen. So entsteht ein explorativer Analyseprozess, ohne dass Du ein einziges Mal ein Dashboard umbauen musst.
Was sich für BI-Teams und Fachbereiche im Arbeitsalltag konkret ändert
Praxisnahe Fragen aus dem Mittelstand: Was Talk to Database beantworten kann
Die Stärke von Talk to Database zeigt sich in konkreten Fragen aus dem Alltag. Besonders spannend sind Bereiche, in denen Kennzahlen schon existieren, aber der Detailgrad im Standardreport nicht ausreicht. Im Mittelstand betrifft das vor allem Vertrieb, Produktion, Supply Chain und Controlling.
Statt sich morgens durch mehrere Dashboards zu klicken, können Verantwortliche zielgerichtet nachhaken: „Welche Kunden“, „Welche Linien“, „Welche Lieferanten“ – immer mit denselben, zentral definierten Kennzahlen im Hintergrund.
Umsatz, Marge und Profitabilität: von Q-Berichten zu Ad-hoc-Fragen
Klassische Vertriebsberichte liefern Dir Umsatz und Marge je Region oder Produktgruppe. Was oft fehlt, ist Flexibilität bei Segmenten und Zeitfenstern. Mit Talk to Database kannst Du zum Beispiel fragen: „Welche zehn Kunden haben ihren Deckungsbeitrag im letzten Quartal am stärksten reduziert, bereinigt um einmalige Projektumsätze?“
Das System übersetzt diese Frage in eine Abfrage über Deine Sales- und Finance-Daten und liefert eine sortierte Liste inklusive Kontext. Du siehst sofort, ob sich der Rückgang auf wenige Ausreißer konzentriert oder breiter verteilt ist – und kannst gezielt in den Dialog mit den Account-Teams gehen.
Kunden- und Vertriebsfragen: Churn, Bestellvolumen, Cross- und Upselling
Im Kundenmanagement sind frühe Signale entscheidend. Talk to Database kann Fragen beantworten wie: „Welche Bestandskunden im Maschinenbau-Segment haben ihr monatliches Bestellvolumen in den letzten 60 Tagen um mehr als 30 % reduziert?“ oder „Welche Kunden kaufen regelmäßig Produkt A, aber nie das dazugehörige Servicepaket?“.
Auf dieser Basis kannst Du gezielte Cross-Selling-Kampagnen starten oder das Account-Management auf gefährdete Kunden hinweisen. Statt pauschaler Newsletter arbeitest Du mit konkreten, datenbasierten Hinweisen aus Deinen eigenen Systemen.
Produktion und Supply Chain: Durchlaufzeiten, Auslastung, Engpässe
In der Produktion geht es häufig um Fragen wie: „Welche Linien hatten diese Woche die längsten Stillstandszeiten und wie korreliert das mit Störungen an kritischen Komponenten?“ oder „Welche A-Teile drohen in den nächsten 14 Tagen knapp zu werden, wenn wir aktuelle Abrufe und Lieferantenlaufzeiten berücksichtigen?“.
Talk to Database greift dabei auf harmonisierte Produktions-, Qualitäts- und Bestelldaten zu. So kannst Du als Produktionsleitung Ursachen schneller eingrenzen, bevor Ausschussquoten oder Lieferverzögerungen sichtbar aus dem Ruder laufen.
Controlling und Forecast: Szenarien, Abweichungsanalysen, Plan-Ist-Vergleiche
Im Controlling sind Abweichungsanalysen ein Dauerbrenner. Statt einen weiteren Standardbericht aufzusetzen, kannst Du fragen: „Welche Kostenstellen tragen am stärksten zur Planabweichung im Q3 bei, wenn wir einmalige Sondereffekte ausblenden?“ oder „Wie würde sich unser EBIT entwickeln, wenn die Materialkosten im nächsten Quartal um 5 % steigen?“.
Solche Szenarien lassen sich über Talk to Database auf vordefinierten Forecast- und Budgetmodellen aufsetzen. Wichtig ist, dass Plan- und Ist-Daten sauber modelliert sind – dann lassen sich solche Szenarien über hinterlegte Forecast-Modelle per Frage abrufen.
Beispiel-Dialog: Von der ersten Frage bis zur konkreten Handlungsempfehlung
Vorteile von Talk to Database für Fachbereiche und Management
Talk to Database verändert nicht nur die Geschwindigkeit, sondern auch die Art, wie Fachbereiche mit Daten arbeiten. Statt Berichte zu „konsumieren“, treten sie mit der Datenbasis in einen Dialog. Das reduziert Abhängigkeiten, erhöht die Akzeptanz von BI und schafft Raum für echte Steuerung.
Gleichzeitig verschiebt sich die Rolle von BI- und Data-Teams: Weg vom Report-Bau hin zum Aufbau und Betrieb eines belastbaren Datenprodukts, auf dem dann sowohl Dashboards als auch KI-Abfragen laufen.
| Aspekt | Vorher (klassisches Reporting) | Mit Talk to Database |
|---|---|---|
| Time-to-Insight | Fragen werden in Tickets übersetzt, Bearbeitung oft in Tagen oder Wochen. | Antworten auf viele Ad-hoc-Fragen in Sekunden bis Minuten direkt im Fachbereich. |
| Rollenbild BI-Team | Stark operativ: Reports bauen, Excel anpassen, Ad-hoc-Abfragen schreiben. | Mehr Fokus auf Datenmodell, Datenqualität, Governance und Enablement. |
| Fachbereich | Wartet auf Reports, weicht bei Bedarf auf eigene Excel-Sichten aus. | Fragt Daten direkt selbst ab, ohne SQL oder BI-Tool-Expertise. |
| Datenakzeptanz | Häufig Diskussionen, welche Zahl „stimmt“, mehrere Wahrheiten im Umlauf. | Eine Quelle und eine Logik für Kennzahlen, transparent einsehbar. |
| Skalierbarkeit | Mehr Fragen = mehr manuelle Arbeit im BI-Team. | Zusätzliche Fragen verursachen kaum manuellen Mehraufwand. |
Schnellere Entscheidungen: Von Tagen zu Sekunden
Wenn Du für jede neue Frage ein Ticket aufmachen musst, werden nur die „wichtigsten“ Themen adressiert, und viele kleinere, aber relevante Fragen bleiben liegen. Mit Talk to Database können Verantwortliche auch kleinere Hypothesen sofort prüfen.
Ein Controller kann zum Beispiel vor einem Investitionsgespräch schnell verifizieren, ob bestimmte Kostenstellen tatsächlich den Trend treiben oder ob einzelne Sondereffekte im Spiel sind – ohne den BI-Kollegen aus einem laufenden Projekt zu ziehen.
Weniger Abhängigkeit vom BI- und IT-Team
Talk to Database macht Dich nicht unabhängig von BI, aber unabhängiger bei der täglichen Arbeit. Viele Standardfragen lassen sich direkt aus dem Fachbereich klären, BI-Teams behalten die Hoheit über Modelle und Governance.
Das reduziert auch das Risiko, dass einzelne Schlüsselpersonen mit ihren Excel-Logiken zum Flaschenhals oder Single Point of Failure werden. Das Wissen wandert in die zentrale Daten- und Kontextschicht, nicht in individuelle Dateien.
Weniger manuelle Excel-Reports, mehr Fokus auf Interpretation
Wenn Daten ad hoc verfügbar sind, verschiebt sich die Arbeit im Fachbereich von „Zahlen zusammensuchen“ hin zu „Zahlen interpretieren und Maßnahmen ableiten“. Zeit, die bisher in Exporten und Formatierungen verschwand, steht für Analysen zur Verfügung.
Das macht Deine Organisation nicht nur schneller, sondern qualitativ besser. Diskussionen drehen sich weniger um die Frage, woher eine Zahl stammt, und mehr um die Frage, was sie für nächste Schritte bedeutet.
Höhere Datenakzeptanz durch Transparenz und Rückverfolgbarkeit
Ein häufiger Grund für BI-Skepsis ist mangelnde Nachvollziehbarkeit: Niemand weiß genau, wie ein Wert zustande kommt. Gute Talk-to-Database-Lösungen legen die zugrunde liegende Query und Kennzahlendefinition offen – oder verweisen auf die entsprechende Dokumentation.
So kannst Du jederzeit nachvollziehen, ob „Umsatz“ hier wirklich netto ohne Rabatte oder brutto inklusive Zusatzleistungen gemeint ist. Diese Transparenz ist nicht nur für Vertrauen wichtig, sondern auch mit Blick auf Prüfungen und den EU AI Act relevant.
Wie KI die Rolle von Data Analysts und Controlling verändert
Talk to Database nimmt Data Analysts nicht den Job weg, sondern befreit sie von Routineabfragen. Ihr Fokus verschiebt sich auf komplexere Analysen, Modellvalidierung und die Weiterentwicklung des Datenprodukts. Controlling kann sich stärker auf Szenarien und Steuerungsimpulse konzentrieren.
Statt Listen manuell zu filtern, beschäftigen sich Analysten mit Fragestellungen wie: „Wie robust sind unsere Kennzahlen bei Datenqualitätsschwankungen?“ oder „Welche zusätzlichen Dimensionen sollten wir modellieren, damit Talk to Database noch präzisere Antworten liefern kann?“
Kostenloses Erstgespräch vereinbaren
Grenzen und Risiken: Wo KI-Datenanalyse ohne Kontext gefährlich wird
Ohne saubere Datenbasis und klare Definitionen besteht das Risiko, dass Talk-to-Database-Systeme zwar schnelle, aber falsche oder widersprüchliche Antworten liefern. Das ist gefährlicher als gar keine Antwort, weil die Ergebnisse plausibel klingen und selten hinterfragt werden.
Hinzu kommen Datenschutz und Regulierung: Laut Destatis zählt Unklarheit über die rechtlichen Folgen zu den häufigsten Gründen, warum Unternehmen keine KI einsetzen. Wer Talk to Database ernsthaft einführen will, muss diese Themen von Anfang an mitdenken.
Halluzinationen und scheinbar plausible, aber falsche Antworten
LLMs sind darauf trainiert, plausible Antworten zu geben, nicht unbedingt wahre. In Text-to-SQL-Szenarien können sie zwar syntaktisch korrekte Queries erzeugen, aber fachlich falsche Logiken wählen – etwa falsche Join-Bedingungen oder fehlende Filter auf aktive Kunden.
Deshalb braucht es Einschränkungen: Das Modell darf nicht frei auf beliebigen Tabellen „raten“, sondern sollte auf klar definierte Data Marts und Kennzahlen zugreifen. Zusätzlich helfen Validierungsregeln und Stichprobenprüfungen durch Fachbereiche.
Uneinheitliche Kennzahlendefinitionen: „Umsatz“, „Marge“, „Deckungsbeitrag“
Wenn Controlling und Vertrieb unterschiedliche Definitionen von „Umsatz“ verwenden, kann kein System konsistente Antworten liefern. Ein LLM kann diese Konflikte nicht lösen, es verstärkt sie nur, indem es auf Basis der jeweils sichtbaren Daten rechnet.
Die Lösung ist ein semantisches Modell, in dem Kennzahlen unternehmensweit definiert und versioniert sind. Talk to Database greift dann immer auf diese definierte Logik zurück, egal wie die Frage formuliert wird.
Fehlende Nachvollziehbarkeit: Warum wurde genau diese Zahl geliefert?
Eine Antwort ohne Begründung ist im Reporting-Kontext wertlos. Du musst nachvollziehen können, welcher Zeitraum, welche Filter, welche Berechtigungen aktiv waren und welche Tabellen beteiligt waren. Ohne diese Transparenz entstehen Compliance-Risiken.
Gute Architekturen loggen jede Interaktion: Frage, generierte Query, verwendete Datenquellen, Antwort und gegebenenfalls Korrekturen. Damit erfüllst Du interne Governance-Anforderungen und bist gut vorbereitet, falls regulatorische Anforderungen an Nachvollziehbarkeit greifen.
Datenhoheit, Datenschutz und regulatorische Anforderungen (DSGVO, EU AI Act)
Unternehmen müssen jederzeit wissen, wo und wie ihre Daten verarbeitet werden. Gerade bei KI-Diensten außerhalb Europas ist unklar, ob personenbezogene oder vertrauliche Unternehmensdaten in Trainingssets einfließen oder außerhalb des eigenen Rechtsraums verarbeitet werden.
Der EU AI Act verlangt unter anderem AI Literacy, Transparenz und technische Schutzmaßnahmen. Zusammen mit der DSGVO bedeutet das für Talk to Database: klare Datenklassifizierung, Zugriffskontrollen, Verschlüsselung, Hosting im EU-Raum und vertraglich geregelte Auftragsverarbeitung.
Typische Fehlannahmen bei der Einführung von generativer KI im Reporting
Voraussetzungen für zuverlässiges Talk to Database: Was die Datenbasis können muss

Talk to Database ist kein Shortcut, um eine schlechte Datenbasis zu umgehen. Im Gegenteil: Es macht Schwächen gnadenlos sichtbar. Wenn IDs fehlen, Historien nicht sauber geführt werden oder Kennzahlen pro Bereich anders berechnet sind, werden Antworten widersprüchlich.
Die gute Nachricht: Viele Unternehmen haben bereits Teile des Fundaments aufgebaut – etwa ein Data Warehouse, Power-BI-Modelle oder zentrale Stammdaten. Talk to Database nutzt diese Bausteine, benötigt aber eine klar strukturierte, zentrale Schicht, auf der es aufsetzen kann.
Zentrale, saubere Datenbasis: Single Source of Truth statt Datensilos
Damit ein Sprachmodell verlässlich antworten kann, müssen Daten aus ERP, CRM, MES, CAQ, Finance und weiteren Quellen in einem zentralen, harmonisierten Datenraum vorliegen. Nur so lassen sich Fragen sauber über Systemgrenzen hinweg beantworten.
Eine Single Source of Truth bedeutet nicht, dass es nur eine physische Datenbank gibt, sondern dass es eine führende, konsistente Sicht auf Fakten und Dimensionen gibt. Operative Systeme bleiben, aber Analysen laufen über das zentrale Modell.
Semantisches Modell: Geschäftskontext, Fakten, Kennzahlen und Dimensionen
Ein semantisches Modell beschreibt, welche Fakten (z. B. Bestellungen, Produktionsaufträge, Reklamationen) es gibt, wie sie miteinander zusammenhängen und wie Kennzahlen darauf aufbauen. Es bildet die Brücke zwischen fachlicher Sicht und technischer Implementierung.
Für Talk to Database ist dieser Layer entscheidend: Nur wenn „Marge“, „Liefertermin-treue“ oder „Ausschussquote“ als wiederverwendbare Metriken hinterlegt sind, kann das Sprachmodell konsistent damit arbeiten. Ohne diesen Layer wirst Du immer wieder fachliche Konflikte erleben.
Governance-Regeln: Rollen, Berechtigungen, Datenhoheit
Wer darf welche Daten sehen? Welche Informationen sind auf Managementebene freigegeben, welche bleiben im Controlling? Talk to Database muss dieselben Berechtigungen respektieren wie Deine BI-Tools oder operativen Systeme.
Praktisch bedeutet das rollenbasierte Zugriffsmodelle, Maskierung sensibler Daten und klare Policies, was in Antworten angezeigt werden darf. Ein Vertriebler braucht andere Sichten als ein HR-Controller – Talk to Database sollte das automatisch berücksichtigen.
Datenschutz und Security-by-Design: Logging, Audits, Zugriffskontrolle
Security-by-Design heißt, dass Datenschutz- und Sicherheitsanforderungen nicht nachträglich „angepflastert“, sondern von Anfang an im System mitgedacht werden. Dazu gehören Verschlüsselung, Netzwerksegmentierung, Härtung der Plattform und laufendes Monitoring.
Ebenso wichtig ist ein vollständiges Logging: Wer hat wann welche Frage gestellt, welche Daten wurden abgefragt, und welche Antworten wurden geliefert? Diese Protokolle sind Grundlage für Audits, Incident-Response und auch für Verbesserungen am System.
Organisatorische Voraussetzungen: Verantwortlichkeiten, Data Ownership
Neben der Technik braucht es klare Rollen. Wer verantwortet die Definition von „Umsatz“? Wer entscheidet, welche Domänen für Talk to Database freigeschaltet werden? Wer pflegt das Glossar und den Datenkatalog? Ohne Antworten auf diese Fragen entsteht Chaos.
Viele Unternehmen etablieren Data Owner pro Domäne (z. B. Sales, Produktion, Finance), die fachliche Verantwortung für Kennzahlen und Definitionen tragen. BI-Teams übersetzen diese Anforderungen ins Datenmodell – Talk to Database konsumiert diese Logik anschließend.
Abgrenzung: ChatGPT, Copilot, klassische BI vs. Talk to Database mit Datenkontext
Viele Unternehmen testen aktuell generative KI mit Tools wie ChatGPT oder Microsoft Copilot. Diese Werkzeuge sind wertvoll, aber sie sind nicht automatisch eine Talk-to-Database-Lösung. Sie kennen Deine Unternehmensdaten nicht und arbeiten meist ohne direkten Zugriff auf Dein semantisches Modell.
Klassische BI-Tools wie Power BI, Tableau oder Qlik sind wiederum stark darin, stabile Dashboards und Standardreports bereitzustellen. Sie bieten teilweise Natural-Language-Features, aber diese sind oft auf die jeweilige Toolwelt beschränkt und hängen stark von der Modellqualität ab.
| Lösung | Stärken | Grenzen im Kontext Talk to Database |
|---|---|---|
| ChatGPT / Copilot (allgemein) | Schnelle Textgenerierung, Ideen, Code-Snippets, allgemeines Wissen. | Kein eingebautes Wissen über Deine Datenmodelle oder Kennzahlen, Risiko von Halluzinationen und fehlende direkte Anbindung an Dein DWH. |
| Power BI, Tableau, Qlik | Stabile Dashboards, Self-Service-BI, Visualisierungen, Governance-Funktionen. | NLQ (Natural Language Query)-Funktionen meist eingeschränkt, Fokus auf vordefinierte Modelle und weniger auf frei formulierte Dialoge über mehrere Domänen. |
| Talk to Database mit Datenkontext | Dialogischer Zugriff auf Daten über Domänen hinweg, Nutzung eines zentralen semantischen Modells, Transparenz von Query und Definition. | Benötigt saubere Datenbasis, Governance und eine Plattform, die BI, KI und Kontext zusammenführt. |
Warum allgemeine KI-Assistenten Unternehmensdaten nicht „verstehen“
Allgemeine KI-Assistenten sind auf öffentliche Daten trainiert. Sie wissen viel über SQL-Syntax, aber nichts über Dein spezifisches ERP-Schema, Deine Kundenstruktur oder Deine Definition von Deckungsbeitrag. Ohne diesen Kontext können sie nur allgemeine Beispiele liefern.
Sobald sie mit echten Unternehmensdaten interagieren sollen, müssen sie in eine Architektur eingebettet werden, die Zugriff, Kontext und Governance bereitstellt. Genau hier setzt ein kontextbasiertes Talk-to-Database-System an.
Stärken und Grenzen von Power BI, Tableau, Qlik & Co.
Diese Tools sind hervorragend geeignet, um Kennzahlen visuell aufzubereiten, Drilldowns zu ermöglichen und Standardreports zu etablieren. Sie sind etabliert, auditierbar und in vielen Unternehmen bereits breit im Einsatz.
Ihre Grenzen liegen dort, wo Ad-hoc-Fragen sehr frei formuliert sind oder über mehrere Datenbereiche hinweggehen, die bislang nicht gemeinsam modelliert wurden. Außerdem erfordern sie eine gewisse Toolkompetenz, die nicht jede Führungskraft im Alltag aufbauen möchte.
Was eine kontextbasierte Lösung zusätzlich leistet (AI + BI = CI)
Eine Lösung wie bimanu One kombiniert BI-Funktionen mit KI und einem zentralen Kontext-Layer – bei bimanu „Contextual Intelligence“ genannt (hier ausführlich erklärt). Dieser Layer hält fachliche Definitionen, Beziehungen und Metriken vor, auf die sowohl Dashboards als auch Talk to Database zugreifen.
So entsteht aus AI + BI eine dritte Ebene: CI (Contextual Intelligence). Sie sorgt dafür, dass KI nicht auf Rohdaten arbeitet, sondern auf einem kuratierten, fachlich abgestimmten Modell. Genau das ist der Unterschied zwischen einem generischen Chatbot und einer produktiven Talk-to-Database-Lösung im Unternehmen.
Wann welches Werkzeug sinnvoll ist – und wann nicht mehr ausreicht
Für wiederkehrende Management-Reports und KPI-Dashboards bleibt klassische BI die erste Wahl. Für explorative Analysen durch Data Scientists brauchst Du weiterhin Python, Notebooks und spezialisierte Tools. Talk to Database ergänzt diese Welt dort, wo Fachbereiche schnelle Antworten auf Geschäftsfragen brauchen, ohne sich in Datenmodellen oder BI-Oberflächen zu verlieren. Spätestens, wenn Ticket-Backlogs wachsen und Schatten-Excels zur Norm werden, reicht ein reiner BI-Ansatz nicht mehr aus.
bimanu One: Die Plattform, die Talk to Database im Mittelstand verlässlich macht
bimanu One liefert genau das Fundament, das Talk to Database im Mittelstand braucht: eine vollständig automatisierte Datenplattform, ein zentrales, modelliertes Datenmodell und eine Kontextschicht, die Fachlogik und Kennzahlen für BI und KI bereitstellt.
Die Besonderheit: Automatisiertes Data Warehouse, BI-Funktionalität, Machine Learning und Kontext-Engine laufen in einer Low-Code-Plattform zusammen. Du musst keine eigene Infrastruktur aufbauen und kein großes Data-Team vorhalten, um produktiv mit KI-Datenanalyse zu starten.
Vom Rohdaten-Wildwuchs zum modellierten Datenraum
Viele Unternehmen starten mit verteilten Datenquellen: ERP, Produktionssysteme, CRM, Excel-Listen. bimanu One bindet diese Quellen über vorgefertigte Konnektoren an und führt sie automatisiert in einem zentralen Datenraum zusammen – auf Basis von Snowflake als Data Warehouse.
Die Plattform validiert, harmonisiert und historisiert Daten nach Best Practices wie Data Vault. So entsteht eine belastbare Single Source of Truth, auf der Talk to Database und klassische BI-Tools gleichermaßen aufsetzen können.
Contextual Intelligence: Kennzahlen, Beziehungen und Geschäftslogik als zentrale Schicht
Mit bimanu Context wird die fachliche Logik explizit modelliert: Welche Kennzahlen gibt es, wie werden sie berechnet, welche Dimensionen geben Kontext? Diese Logik steht nicht nur für Reports, sondern auch für KI-Abfragen zur Verfügung.
Dadurch arbeitet Talk to Database nicht mit freien Interpretationen, sondern mit zentral definierten KPIs. Wenn Du nach „Umsatz“, „Marge“ oder „Churn-Risiko“ fragst, greift das Sprachmodell auf dieselbe Logik zurück, die auch Deinen Finance-Report speist.
Automatisiertes Data Warehouse, BI und KI in einer Low-Code-Plattform
bimanu One automatisiert den gesamten Lebenszyklus: Datenintegration, Modellierung, tägliche Beladung, Monitoring, Qualitätssicherung und Bereitstellung für BI-Tools. Zusätzlich sind KI-Funktionen über Snowflake Cortex AI integriert, ohne dass Du eigene Modelle trainieren musst.
Fachbereiche können über Low-Code-Oberflächen an Modellierung und Regelwerken mitarbeiten, ohne SQL oder Python schreiben zu müssen. Gleichzeitig bleibt alles versioniert, dokumentiert und übertragbar in Test- und Produktivumgebungen.
Schnell produktiv ohne eigenes Data-Team: Projektansatz, Zeitplan, ROI
Ein typischer Einstieg mit bimanu One fokussiert auf ein bis zwei Domänen, etwa Vertrieb und Finance. Innerhalb von etwa fünf Wochen entstehen eine belastbare Datenbasis, erste Kennzahlenmodelle und produktive Antworten auf konkrete Fragen – statt lang laufender BI-Großprojekte.
Der ROI zeigt sich über mehrere Hebel: reduzierte Reporting-Aufwände, weniger Schatten-Excels, schnellere Entscheidungen und eine Plattform, die als Grundlage für weitere KI-Use-Cases dient – von Prognosen bis hin zu automatisierten Handlungsempfehlungen.
Integration in bestehende Tools: Power BI, Tableau, Qlik, Excel und mehr
bimanu One ersetzt Deine Frontends nicht. Power BI, Tableau, Qlik oder auch Excel können weiterhin auf die in Snowflake abgelegten, harmonisierten Daten zugreifen. Dashboards und bestehende Reports laufen weiter – nur auf sauberer, automatisiert gepflegter Basis.
Talk to Database ergänzt diese Landschaft als natürlicher Einstiegspunkt für Fragen. Ob die Antwort dann als Text, Tabelle oder direkt als Visualisierung in Deinem bevorzugten BI-Tool ankommt, hängt von Deinem Setup ab.
Sicherheit, Datenhoheit und EU AI Act: Snowflake Cortex AI, Hosting im EU-Raum
bimanu One setzt auf Snowflake Cortex AI. Deine Daten bleiben in Deinem eigenen Snowflake-Account; sie werden nicht zur Weiterentwicklung des LLMs verwendet. Die KI-Verarbeitung erfolgt im EU-Rechtsraum und ist auf die Anforderungen von DSGVO und EU AI Act ausgelegt.
Ergänzend ist bimanu ISO-27001-zertifiziert. Das bedeutet geprüfte Prozesse für Informationssicherheit, Zugriffskontrolle und Incident-Management – ein wichtiger Baustein, wenn Du KI-basiertes Reporting revisionssicher im Unternehmen etablieren willst.
Flexibilität bei KI-Modellen: Auswahl von LLMs ohne Training auf Kundendaten
Je nach Anwendungsfall können unterschiedliche LLMs eingesetzt werden, etwa für deutsche Fachsprache oder komplexere Analysen. Wichtig: Deine Daten dienen nicht zum Training dieser Modelle. Sie werden nur zur Laufzeit verarbeitet und fließen nicht in Trainingsdaten ein.
So kombinierst Du die Stärken moderner KI mit der Sicherheit, dass Dein geistiges Eigentum geschützt bleibt. Talk to Database wird dadurch zu einem steuerbaren Baustein Deiner Datenstrategie – und nicht zu einer unberechenbaren Blackbox.
Kostenloses Erstgespräch vereinbaren
Wie Du mit Talk to Database startest: Vorgehen für mittelständische Unternehmen
Der Weg zu produktivem Talk to Database muss kein Großprojekt sein. Erfolgreiche Unternehmen starten mit einem klar abgegrenzten Use Case, einer fokussierten Datenbasis und einem Pilotkreis an Nutzern – und skalieren danach schrittweise.
Entscheidend ist, dass Fachbereiche, IT und Management von Beginn an eingebunden sind. KI-Datenanalyse ist keine reine Toolfrage, sondern ein Zusammenspiel aus Daten, Prozessen, Rollen und Technologie.
1. Use Cases und Kennzahlen priorisieren: Wo entsteht schnell Mehrwert?
Starte mit Fragen, die heute häufig gestellt werden und einen klaren Geschäftsnutzen haben. Typische Beispiele sind Margenanalysen im Vertrieb, Ausschussanalysen in der Produktion oder Abweichungsanalysen im Controlling.
Definiere für diese Use Cases ein kleines Set an Kernkennzahlen, etwa Umsatz, Deckungsbeitrag, Ausschussquote oder Liefertreue, und stimme Definitionen zwischen Fachbereichen ab. Diese Klarheit ist die Grundlage für alles Weitere.
2. Datenquellen anbinden und Datenmodell aufbauen oder konsolidieren
Im nächsten Schritt bindest Du die relevanten Systeme an: ERP, CRM, MES, CAQ oder Finanzsysteme. Mit einer Plattform wie bimanu One erfolgt dies weitgehend automatisiert über Konnektoren und vordefinierte Strukturen.
Parallel entsteht ein fachlich orientiertes Datenmodell mit Fakten- und Dimensionstabellen, idealerweise in einem Data-Warehouse-Ansatz wie Data Vault plus darauf aufsetzenden Data Marts. Das Modell ist die Basis sowohl für BI-Reports als auch für Talk to Database.
3. Governance und Berechtigungen definieren
Bevor Fachbereiche mit Talk to Database arbeiten, müssen Rollen und Rechte klar sein. Wer darf Finanzdaten auf Detaillevel sehen, wer nur aggregiert? Welche personenbezogenen Daten werden maskiert oder gar nicht angezeigt?
Definiere Policies für Logging, Audits und den Umgang mit sensiblen Daten. Diese Regeln sollten technisch in der Plattform abgebildet sein, damit Talk to Database sie automatisch berücksichtigt.
4. Pilotphase mit ausgewählten Fachbereichen: Fragen, Feedback, Feinschliff
Wähle eine kleine Gruppe aus dem Fachbereich, etwa Key-User aus Vertrieb oder Controlling, und lasse sie mit realen Fragen arbeiten. Sammle Feedback: Wo fehlen Dimensionen? Welche Begriffe sind unklar? Welche Antworten sind besonders wertvoll?
Auf Basis dieser Erfahrungen justierst Du das Datenmodell, die Kennzahlendefinitionen und die Dialogführung. So entsteht Schritt für Schritt ein System, das wirklich zum Arbeitsalltag Deiner Teams passt.
5. Rollout und Enablement: Schulung, Guidelines, Change-Management
Beim Rollout geht es nicht nur darum, Zugänge freizuschalten. Mitarbeitende brauchen ein Grundverständnis dafür, wie sie sinnvolle Fragen stellen, Ergebnisse interpretieren und wo die Grenzen des Systems liegen.
Binde Leitfäden, Beispiele und Schulungen ein – entweder intern oder über Angebote wie die bimanu Academy. Das unterstützt Dich auch dabei, die Anforderungen an KI-Kompetenz (AI Literacy) aus dem EU AI Act umzusetzen und sorgst für verantwortungsvollen Einsatz.
Erste Wochen mit bimanu One: Was realistisch erreichbar ist

Talk to Database und KI-Datenanalyse – Häufige Fragen aus dem Mittelstand
Welche KI eignet sich am besten für Datenanalyse im Mittelstand – und wann ist Talk to Database sinnvoll?
Für strukturierte Unternehmensdaten ist eine Kombination aus Data-Warehouse-Technologie, semantischem Modell und LLM-basiertem Text-to-SQL am wirkungsvollsten. Talk to Database ist besonders sinnvoll, wenn Fachbereiche viele Ad-hoc-Fragen haben und BI-Teams an Kapazitätsgrenzen stoßen. Allgemeine Chatbots ohne Anbindung an Deine Datenbasis eignen sich eher für Hilfsaufgaben, nicht für verlässliche Geschäftszahlen.
Welche Voraussetzungen muss unsere Datenlandschaft erfüllen, bevor wir mit Talk to Database starten können?
Du brauchst eine zentrale, konsolidierte Datenbasis mit klar modellierten Fakten- und Dimensionstabellen, zumindest für die ersten Use Cases. Außerdem sollten zentrale Kennzahlen fachlich abgestimmt sein, und Berechtigungen müssen definiert sein. Wenn Du diese Basis noch nicht hast, ist eine Plattform wie bimanu Foundation ein sinnvoller erster Schritt, um Datensilos in ein einheitliches Modell zu überführen.
Wie unterscheidet sich Talk to Database von ChatGPT oder Microsoft Copilot im Arbeitsalltag?
ChatGPT und Copilot unterstützen Dich eher allgemein bei Texten, E-Mails oder Codebeispielen und kennen Deine Unternehmensdaten nicht von Haus aus. Talk to Database ist dagegen direkt mit Deinem Data Warehouse und einem semantischen Modell verbunden, sodass Fragen wie „Wie ist unser Umsatz im Maschinenbau-Segment im Q3?“ mit echten Unternehmenszahlen beantwortet werden. Es ist damit ein spezialisierter Assistent, der Deine Daten und Deinen Geschäftskontext kennt.
Wie stellen wir sicher, dass Begriffe wie Umsatz, Marge oder Deckungsbeitrag immer gleich definiert sind?
Du benötigst einen zentralen Kennzahlenkatalog oder semantischen Layer, in dem diese Begriffe einheitlich definiert und versioniert sind. In bimanu One übernimmt das die Contextual-Intelligence-Schicht, die Definitionen einmalig festlegt und für BI-Tools und Talk to Database gleichermaßen bereitstellt. So stellst Du sicher, dass alle Nutzer mit derselben Logik arbeiten, unabhängig von der Frageformulierung.
Wie sicher sind unsere Daten bei KI-Datenanalyse mit bimanu One und Snowflake Cortex AI?
Deine Daten bleiben im eigenen Snowflake-Account und werden nicht zur Weiterentwicklung der zugrunde liegenden LLMs verwendet. Die Verarbeitung findet im EU-Rechtsraum statt, mit DSGVO-konformem Setup und ISO-27001-zertifizierten Prozessen. Zusätzlich kannst Du über Rollen, Maskierung und Logging genau steuern und nachvollziehen, wer auf welche Daten zugreift.
Ersetzt Talk to Database unsere BI-Reports und Dashboards – oder ergänzt es sie?
Talk to Database ergänzt Deine BI-Landschaft, es ersetzt sie nicht. Standardberichte, regulatorische Reports und Management-Dashboards bleiben wichtig, weil sie Stabilität, Vergleichbarkeit und Revisionssicherheit bieten. Talk to Database deckt den Bereich der flexiblen, spontanen Fragen ab, bei denen Dashboards an ihre Grenzen stoßen oder zu träge sind.
Welche Kenntnisse brauchen unsere Mitarbeitenden, um Talk to Database nutzen zu können?
Nutzer müssen weder SQL beherrschen noch BI-Tool-Experten sein. Sie sollten jedoch ein Grundverständnis für die eigenen Kennzahlen und deren Bedeutung haben und lernen, präzise Fragen zu stellen. Kurze Schulungen mit konkreten Beispielen reichen in der Regel aus, damit Fachbereiche schnell selbstständig damit arbeiten.
Wie schnell können wir erste belastbare Antworten aus unseren Daten mit bimanu One erhalten?
Bei einem fokussierten Einstieg mit klar umrissenem Use Case sind erste produktive Antworten innerhalb von fünf Wochen realistisch. In dieser Zeit werden Datenquellen angebunden, ein zentrales Modell aufgebaut und zentrale Kennzahlen definiert. Talk to Database kann dann auf dieser Basis sofort für konkrete Fragen aus dem Fachbereich genutzt werden.