
KI Datenanalyse: Warum Du mit ChatGPT, Claude & Co scheiterst – und wie es richtig geht
KI Datenanalyse: Was damit gemeint ist – und warum so viele Unternehmen damit scheitern
Wenn von „KI Datenanalyse“ die Rede ist, meinen viele alles Mögliche: vom einfachen Excel-Upload in ChatGPT bis zu vollautomatisierten Prognosen auf Basis eines Data Warehouse. Technisch und fachlich liegen da Welten dazwischen. Genau diese Unschärfe sorgt im Mittelstand dafür, dass Erwartungen und Realität weit auseinandergehen.
KI-gestützte Datenanalyse heißt im Unternehmenskontext: Du nutzt Machine-Learning-Modelle oder Sprachmodelle, um Muster zu erkennen, Auffälligkeiten zu erklären oder Prognosen zu erstellen – auf Basis Deiner Unternehmensdaten. Der entscheidende Punkt ist, wie stabil, dokumentiert und reproduzierbar diese Auswertungen sind.
Was ist KI-Datenanalyse im Unternehmenskontext?
KI-Datenanalyse verbindet klassische Datenaufbereitung mit statistischen Verfahren, Machine Learning und zunehmend auch generativer KI. In der Praxis heißt das: Du kommst weg von reinen Vergangenheitsreports, hin zu Prognosen, Anomalie-Erkennung und automatisierten Handlungsempfehlungen.
Dazu gehören z. B. Churn-Prognosen im Vertrieb, Bedarfsprognosen in der Supply Chain oder Anomalie-Erkennung in der Produktion. Sprachmodelle wie ChatGPT oder Claude kommen ins Spiel, wenn Analysen in natürlicher Sprache formuliert, erklärt oder als SQL-Logik für Deine Systeme generiert werden sollen.
Wie unterscheidet sich KI-Datenanalyse von klassischer BI und Reporting?
Klassische Business Intelligence beantwortet vor allem „Was ist passiert?“ – mit definierten Kennzahlen, festen Dashboards und klaren Datenmodellen. Die Logik dahinter ist stabil, dokumentiert und kann jederzeit reproduziert werden. Genau das erwarten Management und Auditoren.
KI-Datenanalyse ergänzt diese Sicht um „Was wird voraussichtlich passieren?“ und „Warum passiert etwas?“. Sie arbeitet mit Modellen, die Muster lernen und Prognosen ableiten. Ohne das BI-Fundament darunter wird KI aber zum Experiment, das weder prüfbar noch auditierbar ist.
Typische Erwartungen von Mittelstandsunternehmen an Datenanalyse mit KI
Viele Entscheider verbinden mit KI den Wunsch nach schnelleren Antworten ohne zusätzliche IT-Abhängigkeit. Sie erwarten, natürliche Fragen stellen zu können („Warum ist unser Deckungsbeitrag im Werk Süd gefallen?“) und in Sekunden eine belastbare Antwort zu bekommen.
Gleichzeitig besteht der Anspruch, dass diese Antworten „stimmen“, auch wenn sie aus einem Chatfenster kommen. Genau hier entsteht die Lücke: Sprachmodelle wirken wie ein BI-Frontend, haben aber ohne Datenfundament darunter weder dieselbe Logik noch dieselbe Qualitätssicherung.
Warum der Hype um ChatGPT & Co den Blick auf Datenfundamente verzerrt
Seit 2023 hat sich der Fokus vieler KI-Initiativen auf das sichtbare Interface verschoben: Prompts, Chatbots, Copilots. Laut Statistischem Bundesamt nutzte 2025 bereits gut jedes vierte Unternehmen in Deutschland KI (26 %), ein Jahr zuvor war es noch jedes fünfte. Besonders verbreitet sind Anwendungen rund um Text und Sprache.
Diese Tools machen den Zugang leicht, verschleiern aber, wie wichtig Datenmodellierung, Datenqualität und Governance darunter sind. Das Ergebnis: Unternehmen testen KI im Chat-Fenster, merken aber erst spät, dass die eigentlichen Engpässe in den Datenpipelines liegen – nicht im Modell.
Das wiedererkennbare Szenario: Excel in ChatGPT laden – und trotzdem danebenliegen
Der Controller lädt die Umsatz-Excel hoch: Was in der Praxis wirklich passiert
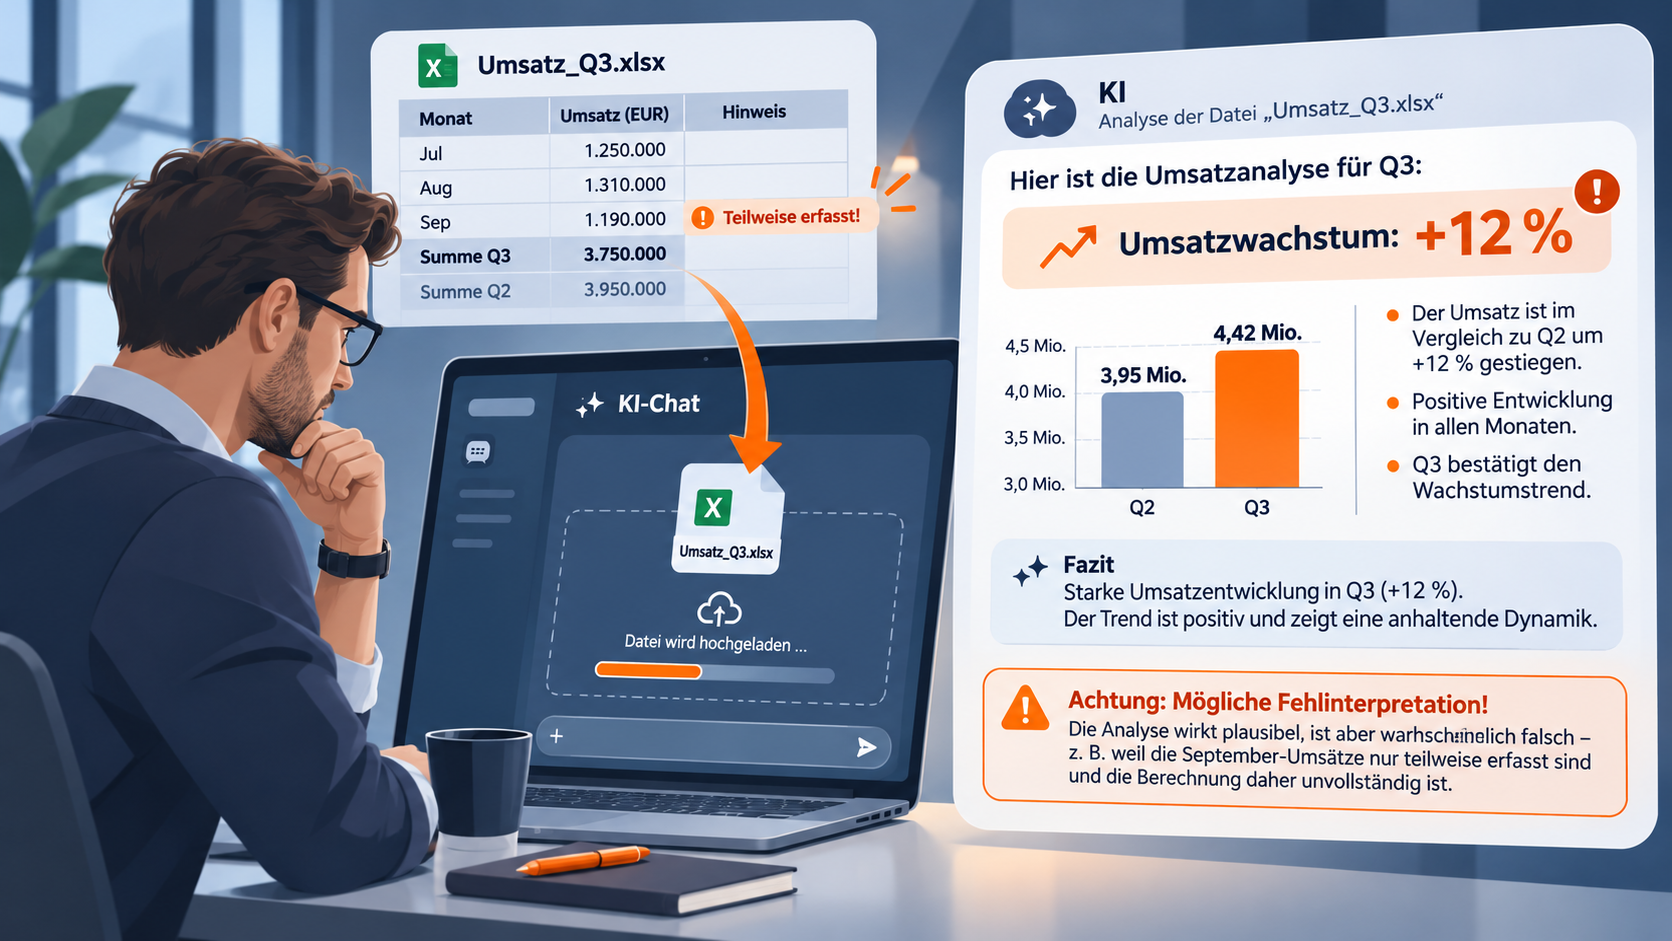
Stell Dir den Monatsabschluss im Controlling vor: Du exportierst die Umsatzdaten aus dem ERP, bereitest eine Excel mit mehreren Tabs auf und lädst die Datei in ChatGPT oder Claude. Deine Frage: „Erkläre mir bitte, warum der Umsatz im Q3 so stark zurückgegangen ist.“
Die KI erkennt Spaltenüberschriften, summiert Werte und liefert eine scheinbar saubere Antwort: „Der Umsatz im Q3 ist um 7,3 % gefallen, vor allem wegen rückläufiger Bestellungen im Segment Maschinenbau in Region DACH.“ Fachlich klingt das plausibel – aber stimmt es auch?
Plausible, aber falsche Antworten: Rechenfehler, Halluzinationen, vertauschte Spalten
In der Praxis sehen wir immer wieder: Die KI liest verbundene Zellen falsch, summiert Zwischensummen doppelt, ignoriert versteckte Filter oder interpretiert Textfelder als Zahlen. Dazu kommen klassische Halluzinationen: erfundene Erklärungen, die in den Daten gar nicht angelegt sind.
Ein Beispiel: Ein Werk wird als Ursache genannt, das im Q3 gar nicht aktiv war. Oder ein Rückgang wird mit „Sommersaison“ erklärt, obwohl Dein Hauptgeschäft im Herbst liegt. Die KI füllt Lücken mit typischen Mustern, nicht mit Deiner Unternehmensrealität.
Warum solche Fehler im Management kaum auffallen – aber teuer werden
Die meisten Antworten aus LLMs sind sprachlich sauber formuliert und mit Prozentangaben, Trends und scheinbar konkreten Gründen angereichert. Wer die Originalzahlen nicht selbst im Detail prüft, merkt Fehler oft nicht – vor allem nicht unter Zeitdruck.
Die Folgen reichen von falschen Vertriebszielen bis zu Fehlinvestitionen in Kapazitäten. Jeder Prozentpunkt, der im Forecast danebenliegt, schlägt sich in Beständen, Servicegraden oder Deckungsbeiträgen nieder. „Überzeugend formuliert“ ist kein Ersatz für „fachlich geprüft“.
Kostenloses Erstgespräch vereinbaren
Warum Sprachmodelle bei Zahlen und Kennzahlen an ihre Grenzen stoßen
Sprachmodelle formulieren Wahrscheinlichkeiten – sie rechnen nicht wie Excel
Modelle wie ChatGPT oder Claude sind darauf trainiert, das wahrscheinlichste nächste Token zu erzeugen – also Textwahrscheinlichkeiten, keine geprüften Berechnungsergebnisse. Sie können zwar rechnen, aber Rechnen ist nicht ihr Kernmechanismus, sondern eine abgeleitete Fähigkeit.
In einfachen Fällen passt das Ergebnis, in komplexeren Tabellen mit Filtern, Sonderfällen und Geschäftslogik häufen sich Fehler. Das Modell weiß nicht, welche Spalte die „Wahrheit“ ist, welche Werte Korrekturen darstellen oder welche Zeilen Stillstand und welche Produktion sind.
Zwar führen ChatGPT und Claude bei Datei-Analysen inzwischen oft Code aus, um zu rechnen. Doch auch korrekter Code rechnet falsch, wenn das Modell die Tabelle falsch interpretiert, also die falsche Spalte, eine Zwischensumme oder einen Filter übersieht
Halluzinationen bei Zahlen: Warum „überzeugend klingend“ nicht „richtig“ heißt
Das US-amerikanische NIST führt in seinem Risikoprofil für generative KI (NIST AI 600-1) erfundene Inhalte, dort ‚Confabulation‘ genannt, ausdrücklich als zentrales Risiko. Bei Text fällt eine erfundene Quelle oft auf, bei Zahlen hingegen wirken erfundene Prozentwerte zunächst plausibel. Ein kleiner Rundungsfehler wird selten hinterfragt.
Kritisch wird es, wenn Ursache-Wirkungs-Beziehungen hinzugedichtet werden. Das Modell erklärt Deinen Umsatzrückgang mit einem allgemeinen „Nachfragerückgang im Markt“, obwohl die eigentliche Ursache ein interner Lieferengpass war. Die KI kennt Deinen Kontext nicht – sie leitet ihre Erklärung aus typischen Mustern in Millionen anderer Texte ab.
Grenzen laut OpenAI, Anthropic & Co: Was die Anbieter selbst empfehlen
Die großen Anbieter weisen selbst darauf hin, dass ihre Modelle keine Quelle für geprüfte Fakten sind und Zahlenangaben stets validiert werden müssen. Die Anbieter weisen selbst darauf hin: ChatGPT blendet etwa den Hinweis ein, dass das Modell Fehler machen kann und wichtige Informationen geprüft werden sollten.
Für sensible Unternehmenszahlen heißt das: Ein Chatbot ist ein Hilfsmittel für Exploration und Ideengenerierung, aber kein Ersatz für validierte Kennzahlen aus einem Data Warehouse oder BI-System. Diese Warnung ist nicht Marketing, sondern Teil des Risikomanagements der Anbieter.
Wo LLMs in der Datenanalyse trotzdem sinnvoll sind (und wo nicht)
wenn es darum geht, zu erklären, zu dokumentieren und zwischen Fachbereich und Technik zu übersetzen: SQL-Abfragen generieren, komplexe Reports in Klartext zusammenfassen oder Freitexte in Reklamationen kategorisieren. Sie helfen Data-Teams und Fachbereichen, schneller zu arbeiten.
Schwach sind sie, wenn sie ohne kontrollierten Zugriff auf geprüfte Daten rechnen oder wenn ihre Antworten direkt als Entscheidungsvorlage genutzt werden. Genau deshalb setzen moderne Architekturen auf eine Kombination aus LLM-Interface und deterministischer BI-Logik darunter.
Die häufigsten Fehlerquellen bei KI Datenanalyse im Mittelstand
Unsaubere Daten: Excel-Exporte, Formatbrüche und versteckte Stolperfallen
Viele Analysen starten noch immer mit manuell erzeugten Excel-Exports aus ERP, CRM oder Produktionssystemen. Verbundene Zellen, manuelle Zwischensummen, Text statt Datum und unterschiedliche Währungen in einer Spalte sind Alltag. Für Menschen oft lesbar, für KI-Modelle ein Minenfeld.
Wenn Du solche Dateien ungeprüft in einen Chatbot lädst, rechnet das Modell einfach mit dem, was es sieht. Es erkennt selten selbstständig, dass eine Spalte gemischt gepflegt ist oder dass ganze Tage fehlen. Die Fehler aus dem Export landen unverändert in der „KI-Auswertung“.
Fehlender fachlicher Kontext: „Umsatz“, „DB“, „aktiver Kunde“ ohne eindeutige Definition
In vielen Unternehmen meint jede Abteilung etwas anderes, wenn sie von Umsatz, Deckungsbeitrag oder aktiven Kunden spricht. Das Controlling rechnet netto ohne Boni, der Vertrieb arbeitet mit Brutto-Werten inklusive Rabatten, das CRM hat eigene Statuslogiken für „aktiv“.
Ein Sprachmodell kennt diese Unterschiede nicht, wenn sie nicht explizit in der Datenbasis hinterlegt sind. Es sieht nur Spaltennamen wie „Sales“ oder „Revenue“ und produziert darauf basierend eine Antwort. Ohne zentrale Kennzahlendefinitionen werden Inkonsistenzen verstärkt statt aufgelöst.
Datensilos: ERP, CRM, Produktion und Excel ohne gemeinsamen Blick
Gerade Industrie- und Produktionsunternehmen kämpfen mit heterogenen Datenquellen. ERP, MES, CAQ, CRM, IoT und Excel haben jeweils eigene IDs, Zeitachsen und Strukturen. Ein Chatbot sieht immer nur das, was Du ihm hochlädst – meist einen Ausschnitt.
Entscheidungsfragen erfordern jedoch fast immer eine quellenübergreifende Sicht: Umsatz plus Marge plus Reklamationsquote plus Lieferperformance. Wenn die KI immer nur einzelne Exporte sieht, kann sie zwar Teilfragen beantworten, aber keine echte Gesamtsteuerung abbilden.
Keine Nachvollziehbarkeit: Woher kommt die Zahl – und welche Logik steckt dahinter?
In BI-Systemen kannst Du für jede Kennzahl zurückverfolgen, aus welchen Tabellen, Filtern und Berechnungen sie stammt. In einem Chatverlauf mit einer generativen KI ist das deutlich schwieriger. Zwar lässt sich bei manchen Tools der ausgeführte Code einsehen, doch das ist kein versionierter, getesteter und dokumentierter Datenfluss.
Für Management-Entscheidungen, Audits oder regulatorische Reports reicht „Das hat ChatGPT so ausgespuckt“ nicht aus. Du brauchst versionierte Pipelines, getestete Berechnungen und klar dokumentierte Datenflüsse. Ein Prompt-Protokoll ersetzt das nicht.
Datenschutz und Compliance: Was beim Upload sensibler Daten in öffentliche KI-Tools passiert
Ein weiteres Risiko ist der unkontrollierte Upload sensibler Daten in öffentliche KI-Dienste. Selbst wenn der Anbieter verspricht, Daten nicht fürs Training zu verwenden, musst Du klären, wo sie gespeichert werden, wie lange, und wer zugreifen kann. Gerade bei personenbezogenen oder produktionskritischen Daten ist das heikel.
Mit Blick auf den EU AI Act und bestehende Datenschutzregeln brauchen Unternehmen Klarheit über Datenflüsse, Speicherorte und Zugriff. Lädt jemand ohne Freigabe eine Excel-Datei in einen US-Dienst hoch, ist dieser Datenfluss in der Regel nicht ausreichend dokumentiert.
Falsche Erwartungshaltung: Warum ein Chatbot kein BI-System und kein Data Warehouse ersetzt
Der größte Fehler ist die Annahme, ein Chatbot könne ein fehlendes Data Warehouse, saubere Datenmodelle oder eine BI-Architektur ersetzen. Das Interface mag moderner wirken, die strukturellen Probleme darunter löst es aber nicht.
Wer versucht, mit LLMs fehlende Datenarbeit zu kompensieren, baut auf Sand. Die Projekte bleiben in der Experimentierphase hängen, das Vertrauen der Fachbereiche sinkt, und KI gilt schnell als „unzuverlässig“ – obwohl das Problem in Wahrheit in den Daten liegt.
Kostenloses Erstgespräch vereinbaren
Was KI-Datenanalyse leisten kann – und was (noch) nicht
Typische Anwendungsfälle: Von Ad-hoc-Fragen bis zu Prognosen
KI-Datenanalyse entfaltet ihre Stärken dort, wo große Datenmengen, wiederkehrende Muster und viele Variablen zusammenkommen. Das reicht von Absatzprognosen über Churn-Modelle im Vertrieb bis zu Anomalie-Erkennung in Maschinendaten.
Generative KI ergänzt diese Use Cases, indem sie Ergebnisse zusammenfasst, Root-Cause-Hypothesen in Alltagssprache formuliert oder Ad-hoc-Fragen über eine bestehende Datenbasis beantwortet. Das spart Zeit im Controlling und in den Fachbereichen.
Vorteile von KI in der Datenanalyse: Geschwindigkeit, Mustererkennung, Automatisierung
KI-Modelle erkennen Muster, die in tausenden Zeilen für Menschen schwer sichtbar sind: saisonale Effekte, Kombinationen von Fehlteilen und Lieferantenproblemen oder frühe Signale abwanderungsgefährdeter Kunden. Sie können diese Muster kontinuierlich überwachen.
Dazu kommt Geschwindigkeit: Forecasts, Szenarien und Abweichungsanalysen lassen sich häufiger fahren, ohne dass jedes Mal ein manuelles Reporting-Projekt notwendig ist. KI-gestützte Systeme verkürzen die Zeit von der Frage zur belastbaren Antwort.
Grenzen in Praxisprojekten: Verfügbarkeit, Qualität und Governance der Daten
In der Praxis scheitern viele KI-Projekte nicht an den Modellen, sondern daran, dass Daten unvollständig, inkonsistent oder zu spät vorliegen. Wenn Stillstandsgründe nur in einem Schichtbuch stehen oder Lieferzeiten nicht sauber historisiert sind, fehlt dem Modell die Datengrundlage.
Ohne Governance – also klare Verantwortlichkeiten, Datenqualitätsregeln und Berechtigungen – lassen sich KI-Ergebnisse außerdem schwer in den Alltag integrieren. Die Modelle liefern zwar Scores und Prognosen, aber niemand traut sich, danach Entscheidungen zu treffen.
Wie KI die Rolle von Controlling, Data Analysts und Fachbereichen verändert
Gut eingeführte KI nimmt Controllern und Analysten Routinearbeit ab, etwa bei Standardreports, Plausibilitätschecks oder der ersten Ursachenanalyse. Die Rolle verschiebt sich von „Zahlen liefern“ hin zu „Ergebnisse einordnen und Maßnahmen mitgestalten“.
Fachbereiche müssen lernen, KI-Ergebnisse zu hinterfragen, statt sie blind zu übernehmen. Dazu gehört ein Grundverständnis für Datenqualität, Modellgrenzen und Governance – nicht, um selbst Modelle zu bauen, sondern um sie verantwortungsvoll zu nutzen.
Die richtige Reihenfolge: Erst Datenfundament, dann KI
Schritt 1: Daten zusammenführen – weg von isolierten Excel-Dateien
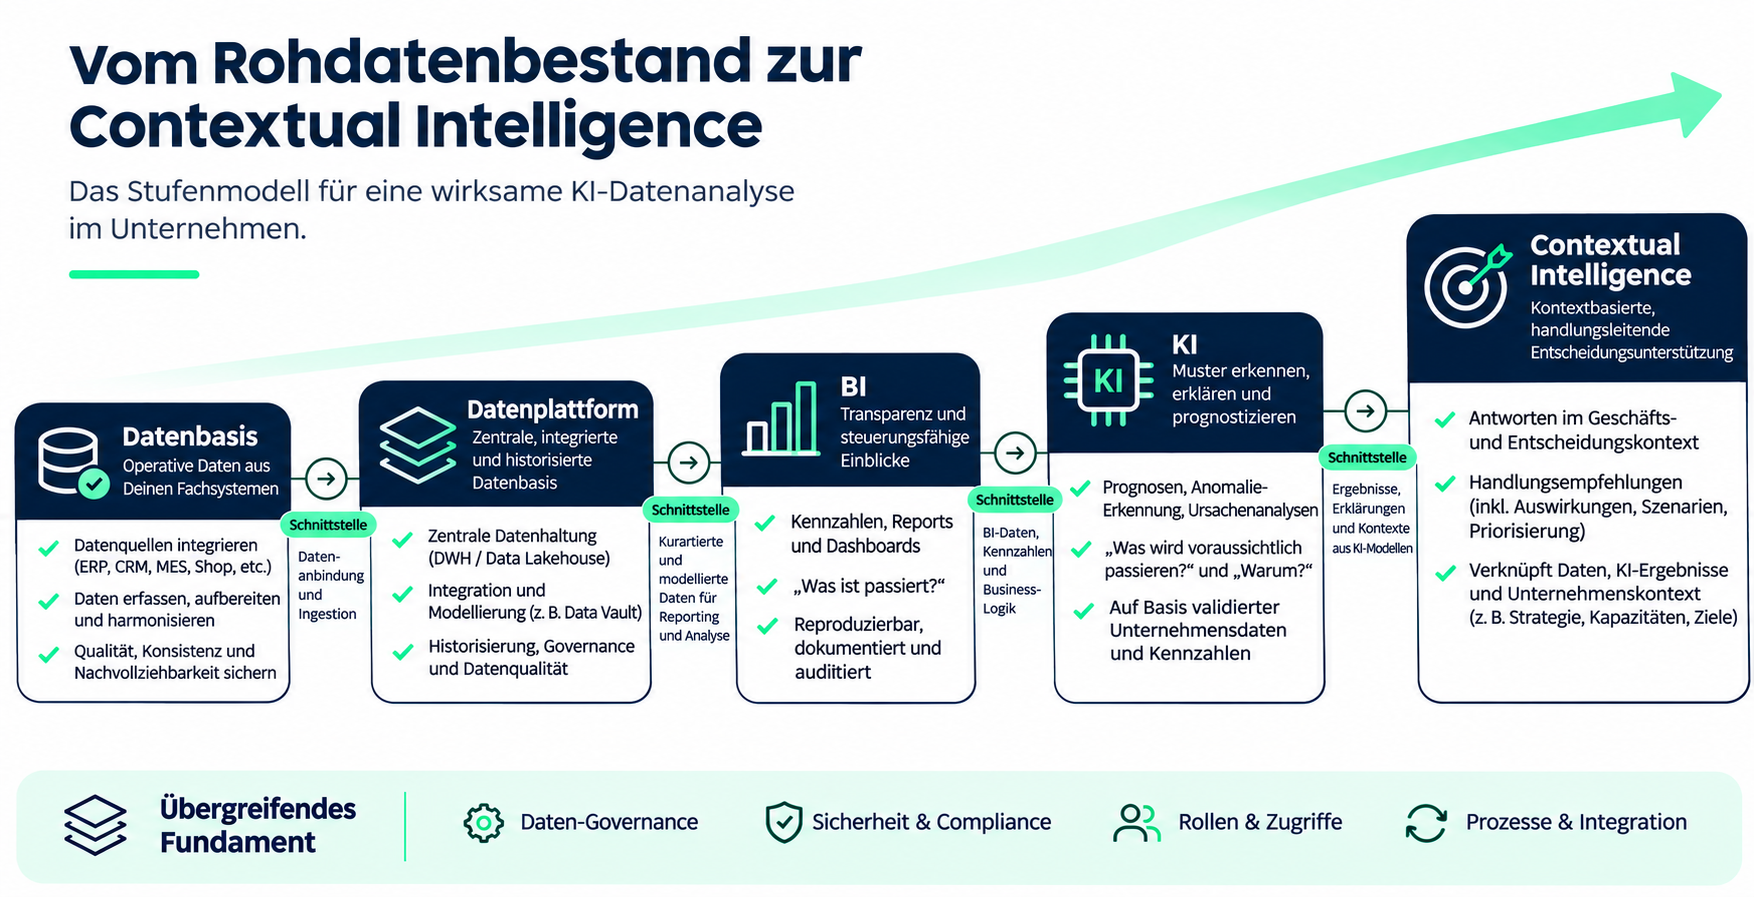
Statt jede Analyse mit einem neuen Export zu starten, brauchst Du eine zentrale Datenbasis, in der ERP-, CRM-, Produktions- und weitere Daten zusammenlaufen. Das kann ein Data Warehouse, ein Lakehouse oder eine vergleichbare Plattform sein.
Wichtig ist dabei, dass die Datenverbindungen dauerhaft und automatisiert bestehen. Nur so kannst Du Kennzahlen reproduzierbar berechnen, Trends sauber verfolgen und KI-Modelle kontinuierlich mit aktuellen Informationen versorgen.
Schritt 2: Daten bereinigen und harmonisieren – Formate, Dubletten, Lücken
Im nächsten Schritt geht es darum, die Daten technisch und fachlich konsistent zu machen: gleiche Datumsformate, saubere IDs, eindeutige Kunden- und Artikelstämme, bereinigte Dubletten. Dieser Schritt entscheidet über die Zuverlässigkeit späterer Analysen.
Automatisierte Qualitätsregeln, Validierungen und Monitoring helfen, diesen Zustand zu halten. Einzelne manuelle Korrekturen in Excel sind hier kontraproduktiv, weil sie sich nicht in die Gesamtlogik einfügen lassen.
Schritt 3: Kennzahlen zentral definieren – eine Sprache für alle Bereiche
Parallel zur technischen Harmonisierung brauchst Du eine fachliche: Wie genau wird Umsatz berechnet? Was gehört in den Deckungsbeitrag? Ab wann gilt ein Kunde als „inaktiv“? Diese Definitionen müssen zentral dokumentiert und im Datenmodell verankert sein.
Nur dann können BI-Tools, KI-Modelle und auch LLM-basierte Interfaces auf dieselbe Wahrheit zugreifen. Ohne einheitliche Kennzahlen sprichst Du im Unternehmen über unterschiedliche Zahlen – und merkst es oft erst im Konfliktfall.
Schritt 4: Governance, Security und Zugriffsrechte klären
Wer darf welche Daten sehen? Wer entscheidet über neue Kennzahlen? Wie werden Änderungen getestet und ausgerollt? Diese Governance-Fragen sind nicht nur organisatorisch, sondern für KI-Projekte zentral. Der EU AI Act verstärkt diesen Trend zusätzlich.
Klare Rollen, Freigabeprozesse und Audit-Trails sorgen dafür, dass Du KI-Modelle in sensiblen Bereichen einsetzen kannst, ohne Kontrollverlust zu riskieren. Gerade im Mittelstand lässt sich das schlank, aber verbindlich aufsetzen.
Schritt 5: KI-Modelle auf geprüfte, dokumentierte Daten loslassen
Erst wenn die Datenbasis steht, lohnt es sich, Modelle für Prognosen, Scorings oder Anomalie-Erkennung zu trainieren. Diese Modelle greifen dann auf dieselbe zentrale Wahrheit zu wie Deine Dashboards und Reports – die Ergebnisse sind dadurch vergleichbar und prüfbar.
Sprachmodelle kannst Du in dieser Architektur als Interface nutzen: Sie formulieren Erklärungen, erzeugen Abfragen gegen das Datenmodell oder unterstützen bei der Interpretation von Ergebnissen. Rechnen und Speichern übernimmt weiterhin die Plattform.
Von BI zu AI zu CI: Vom „Was“ zum „Wie weiter“ und „Warum“
Saubere BI liefert Dir das „Was“: Umsatz, Marge, Auslastung, Ausschuss. KI-Modelle ergänzen das „Wie weiter“: Prognosen, Szenarien, Eintrittswahrscheinlichkeiten. Der nächste Schritt ist Contextual Intelligence (CI): Empfehlungen, die den konkreten Geschäftskontext kennen.
Dafür braucht es nicht nur Modelle, sondern Branchenerfahrung und hinterlegte Regeln. Die Frage verschiebt sich von „Was sagt die KI?“ hin zu „Welche Maßnahmen ergeben sich aus den Daten – und wie sicher sind sie?“. Genau an diesem Punkt unterscheiden sich Plattformen wie bimanu One von reinen BI- oder Chat-Lösungen.
So funktioniert KI Datenanalyse, die wirklich trägt – mit bimanu One
Zentrale Datenbasis statt Excel-Upload: Alle relevanten Systeme verbunden
bimanu One setzt genau dort an, wo ChatGPT & Co an ihre Grenzen stoßen: bei der Datenbasis. Über mehr als hundert fertige Konnektoren bindest Du ERP-, CRM-, MES-, IoT- und weitere Systeme an – ohne, dass daraus ein langes IT-Projekt werden muss.
Die Daten werden automatisiert geladen, versioniert und in einer zentralen Plattform zusammengeführt. Statt einzelner Excel-Exporte hast Du damit eine dauerhafte, verlässliche Sicht auf Deine Unternehmensdaten als „Single Point of Truth“.
Automatisierte Datenmodellierung und Kennzahlendefinitionen im Kern der Plattform
Im Kern von bimanu One steht ein automatisiertes Datenmodell, das technische Struktur und fachlichen Kontext verbindet. Kennzahlen werden zentral definiert, validiert und stehen anschließend für Reporting, Analysen und KI-Anwendungen gleichermaßen zur Verfügung.
Data-Vault- und weitere bewährte Modellierungsansätze sind integriert, ohne dass Du dafür ein eigenes Data-Engineering-Team brauchst. Änderungen werden versioniert und kontrolliert ausgerollt – inklusive Test- und Produktivumgebungen.
KI auf geprüften, kontextreichen Daten: LLMs wie ChatGPT und Claude richtig einsetzen
bimanu One arbeitet bewusst nicht gegen ChatGPT, Claude & Co, sondern mit ihnen. Die Plattform stellt geprüfte, kontextreiche Daten bereit, auf die generative Modelle zugreifen können – ohne dass Roh-Exporte oder sensible Daten unkontrolliert in öffentliche Chats wandern.
So nutzt Du dieselben Sprachmodelle wie im Browser, aber auf einer klar geregelten, auditierbaren Datenbasis. Das reduziert Halluzinationen, weil Berechnungen und Kennzahlen aus der Plattform kommen und das LLM vor allem formuliert, erklärt und orchestriert.
Vom Dashboard zur Handlungsempfehlung: Contextual Intelligence im Alltag
Auf dieser Basis liefert bimanu One nicht nur Zahlen, sondern konkrete Handlungsempfehlungen. Die Plattform kennt Branchenlogiken, typische Kennzahlen und Zusammenhänge – etwa zwischen Lieferperformance, Ausschuss und Servicegrad.
Statt nur den Rückgang der OEE zu zeigen, erhältst Du Vorschläge, welche Linien, Schichten oder Lieferanten besonders kritisch sind und wo Du zuerst ansetzen solltest. KI wird damit vom Analysewerkzeug zum Entscheidungspartner – aber immer auf Basis überprüfbarer Daten.
Eine Plattform statt Toolkette: Datenintegration, BI und KI in einem System
Klassische Setups bestehen aus vielen Einzelbausteinen: ETL-Tool, Datenbank, BI-Frontend, separates KI-Framework. Jede zusätzliche Komponente erhöht den Abstimmungs- und Betriebsaufwand – und den Bedarf an Spezialisten.
bimanu One bündelt diese Schritte in einer Plattform: von der Datenintegration über die Modellierung bis zur Bereitstellung für BI-Tools und KI-Modelle. Dadurch sinkt die Komplexität, und Fachbereiche können deutlich schneller mit belastbaren Ergebnissen arbeiten.
Datenhoheit, Snowflake Cortex AI und ISO-27001: Datensicherheit im Vergleich zu öffentlichen Chatbots
Die Plattform basiert auf Snowflake Cortex AI, einer Architektur, bei der Deine Daten das eigene Snowflake-Konto nicht verlassen. Modelle werden zu den Daten gebracht, nicht umgekehrt. Das reduziert Risiken, die bei einfachen Excel-Uploads in öffentliche Dienste entstehen.
Ergänzt wird das durch ISO-27001-zertifizierte Prozesse und die Zusage, dass Deine Daten nicht zum Training fremder Modelle genutzt werden. Für regulierte Branchen und sensible Produktionsdaten ist das ein entscheidender Unterschied.
Bestehende BI-Tools weiter nutzen: Warum bimanu One die Entscheidungsebene darunter liefert
Wenn Du bereits in Power BI, Qlik oder Tableau investiert hast, musst Du diese Landschaft nicht austauschen. bimanu One versteht sich als darunterliegende Daten- und Entscheidungsebene, die saubere, harmonisierte Daten für Deine bestehenden BI-Tools bereitstellt.
So erhältst Du in vertrauten Oberflächen verlässliche Zahlen, während KI-gestützte Analysen und Handlungsempfehlungen aus der Plattform kommen. BI bleibt Dein Frontend, bimanu One liefert das Modell und den Kontext darunter.
Ohne eigenes Data-Team starten: Time-to-Value, Managed Service und bimanu Academy
Viele Mittelständler scheitern daran, dass sie für komplexe Daten- und KI-Setups eigentlich ein eigenes Data-Team bräuchten. bimanu One ist deshalb als Managed Service konzipiert: Das Team hinter der Plattform übernimmt Betrieb, Weiterentwicklung und Coaching.
Erste belastbare Kennzahlen stehen in der Regel innerhalb weniger Wochen zur Verfügung. Parallel baut die bimanu Academy intern Wissen auf, damit Deine Teams die Plattform souverän nutzen und Schritt für Schritt unabhängiger werden.
Praxis: Wann ChatGPT & Co reichen – und wann Du eine Datenplattform brauchst
Typische Einsatzszenarien für ChatGPT, Claude & Co in der Datenanalyse
Für schnelle, risikoarme Aufgaben sind LLMs ideal: Formeln erklären, SQL-Vorschläge generieren, Datenmodelle skizzieren oder lange Reports in verständliche Zusammenfassungen übersetzen. Auch für erste Explorationsfragen zu nicht-sensiblen Daten sind sie hilfreich.
Ebenfalls sinnvoll ist der Einsatz bei Text-auf-Daten-Aufgaben, etwa wenn Reklamationstexte kategorisiert oder Schichtprotokolle in standardisierte Codes überführt werden sollen. Hier kombinierst Du die Stärke von LLMs bei der Mustererkennung mit klaren Regeln.
Wann Du mit Excel-Uploads bewusst vorsichtig sein solltest
Kritisch wird es, wenn Du Excel-Dateien mit sensiblen Kundendaten, Produktionskennzahlen oder preisrelevanten Informationen ungefiltert in öffentliche Dienste hochlädst. Hier drohen nicht nur Datenschutzrisiken, sondern auch Fehlentscheidungen durch Datenfehler.
Als Daumenregel gilt: Alles, was Du einem externen Dienstleister ohne NDA nicht schicken würdest, gehört auch nicht in ein öffentliches Chatfenster. Für solche Szenarien brauchst Du eine kontrollierte interne Plattform mit klar regulierten KI-Zugriffen.
Ab wann eine echte Datenplattform Pflicht ist: Schwellenwerte und Entscheidungskriterien
Spätestens dann, wenn mehrere Abteilungen regelmäßig mit denselben Kennzahlen arbeiten, wenn Entscheidungen mit wirtschaftlicher Tragweite betroffen sind oder wenn regulatorische Anforderungen ins Spiel kommen, reichen Chatbots nicht mehr aus.
Wenn Du Fragen wie „Warum stimmt unser Monatsreport nicht mit dem Vertriebsergebnis überein?“, „Wie sicher ist unsere Forecast-Genauigkeit?“ oder „Wie auditierbar ist unser ESG-Reporting?“ stellst, brauchst Du ein strukturiertes Datenfundament und keine Einzelprompts.
Vergleich: Ad-hoc-Chatbot vs. KI-gestützte Datenplattform
| Kriterium | Ad-hoc-Chatbot (z. B. Excel-Upload in ChatGPT) | KI-gestützte Datenplattform (z. B. bimanu One) |
|---|---|---|
| Datenbasis | Einzelne Dateien, manuell ausgewählt, oft unbereinigt. | Zentrale, automatisiert geladene und bereinigte Daten aus allen relevanten Systemen. |
| Reproduzierbarkeit | Antworten hängen von Prompt, Modellversion und Datei ab. | Kennzahlen und Analysen stammen aus versionierten Pipelines und definierter Logik. |
| Nachvollziehbarkeit | Begrenzte Einsicht in Berechnungen, kaum Audit-Trails. | Transparente Datenflüsse, Dokumentation von Berechnungen und Datenherkunft. |
| Datenschutz & Compliance | Abhängig von Anbieter und Tarif, Speicherort und Datenflüsse oft nicht klar dokumentiert | Datenhaltung und KI-Ausführung innerhalb klar definierter, auditierbarer Infrastruktur. |
| Eignung | Exploration, Prototyping, Lernzwecke, nicht-kritische Analysen. | Steuerungsrelevante Kennzahlen, Prognosen, automatisierte Entscheidungen. |
Checkliste: Bin ich noch im Chatbot-Modus – oder schon im BI-/Datenplattform-Fall?
Wenn Du hauptsächlich einzelne Fragen klären willst („Wie baue ich diese Pivot?“, „Wie interpretiere ich diese Kennzahl?“) und mit kleinen, nicht-sensiblen Datensätzen arbeitest, bist Du im Chatbot-Modus gut aufgehoben. Hier geht es um Unterstützung im Alltag.
Wenn Du hingegen wiederkehrende Reports, cross-funktionale Kennzahlen, Forecasts für Produktion oder Supply Chain und auditierbare ESG-Berichte brauchst, befindest Du Dich im Plattform-Fall. Spätestens dann solltest Du eine Lösung wie bimanu One in Betracht ziehen.
KI-Datenanalyse im Unternehmen verankern: Schritte, Rollen, Governance
Welche Daten und Kompetenzen Du für den Einstieg in KI-Datenanalyse brauchst
Für einen sinnvollen Einstieg brauchst Du keine perfekte Datenwelt, aber eine Mindestbasis: eindeutige IDs, konsistente Zeitachsen und zentrale Stammdaten für Kunden, Produkte und Werke. Ohne diese Basis laufen Modelle ins Leere oder verstärken bestehende Inkonsistenzen.
Auf Kompetenzseite genügen zu Beginn ein datenaffiner Kollege im Controlling oder der IT, Unterstützung durch einen Plattformanbieter und die Bereitschaft der Fachbereiche, Prozesse und Kennzahlen offen zu diskutieren. Spezialistenwissen kann punktuell ergänzt werden.
Rollen im Mittelstand: IT, Fachbereiche, externe Partner und Plattformanbieter
Im Mittelstand ist selten ein voll ausgebautes Data-Team vorhanden. Umso wichtiger ist eine klare Rollenteilung: Die IT verantwortet Infrastruktur und Sicherheit, die Fachbereiche definieren Kennzahlen und Use Cases, und der Plattformanbieter bringt Methoden und Umsetzungskompetenz.
Externe Partner wie bimanu begleiten den Aufbau, Betrieb und die Weiterentwicklung der Datenplattform. So kannst Du KI-Datenanalyse produktiv nutzen, ohne zuerst ein eigenes Team aus Data Engineers, Scientists und Architects aufbauen zu müssen.
Prozesse und Verantwortlichkeiten: Wer prüft Zahlen – und wer entscheidet?
KI-Datenanalyse ändert nichts daran, dass am Ende Menschen Entscheidungen treffen. Wichtig ist daher ein Prozess, in dem Ergebnisse aus Modellen und LLMs geprüft, plausibilisiert und freigegeben werden, bevor sie ins Management-Reporting oder in operative Systeme einfließen.
Ein pragmatischer Ansatz ist ein Vier-Augen-Prinzip für kritische KPIs und definierte Grenzwerte, ab denen KI-Ergebnisse manuell bestätigt werden müssen. So bleiben Geschwindigkeit und Sicherheit in Balance.
Datenschutz, AI Act & Compliance: Was Verantwortliche beachten müssen
Der EU AI Act schreibt für bestimmte Hochrisiko-Anwendungen explizite Anforderungen an Datenqualität, Governance und Transparenz fest. Auch wenn viele klassische BI-Analysen nicht direkt darunterfallen, wird dieser Rahmen zum neuen Normal in datengetriebenen Projekten.
In der Praxis bedeutet das: Dokumentierte Datenherkunft, klar geregelte Zugriffsrechte, Monitoring von Modellen und Prozesse für Korrekturen. Eine Plattform wie bimanu One bringt diese Mechanismen technisch mit, sodass Du nicht alles selbst entwickeln musst.
Best Practices: Wie Unternehmen KI-Datenanalyse schrittweise skalieren
Erfolgreiche Unternehmen starten mit einem klar abgegrenzten Use Case, etwa dem Monatsreporting im Vertrieb oder einer ersten Produktionskennzahl wie OEE. Sie bauen darauf das Datenmodell und die Pipeline auf und bringen dann KI-Funktionen ein.
Erst wenn dieser erste Baustein stabil läuft und akzeptiert ist, folgen weitere Bereiche wie Supply Chain, Service oder ESG. So wächst die Plattform entlang konkreter Geschäftsnutzen – und nicht entlang einer abstrakten Zielarchitektur.
Kostenloses Erstgespräch vereinbaren
Fazit: Gleiche KI-Modelle, andere Basis – so bekommst Du verlässliche Ergebnisse
ChatGPT, Claude & Co sind nicht das Problem – sie sind mächtige Werkzeuge. Der Unterschied liegt in der Basis, auf der sie arbeiten. Mit einzelnen Excel-Uploads bleiben sie ein Experiment, mit einer strukturierten Datenplattform werden sie zum verlässlichen Interface für geprüfte Zahlen.
Wenn Du KI-Datenanalyse im Unternehmen ernsthaft etablieren willst, führt kein Weg an einer sauberen Datenbasis, klaren Kennzahlen und gelebter Governance vorbei. Genau hier setzt bimanu One an: Die Plattform verbindet Deine Systeme, strukturiert Deine Daten und macht KI für Entscheidungen nutzbar, statt nur für beeindruckende Demos.

KI Datenanalyse – Häufige Fragen und Antworten
Was ist KI-Datenanalyse genau – und wie unterscheidet sie sich von klassischer Datenanalyse?
KI-Datenanalyse nutzt Machine-Learning- und KI-Modelle, um Muster, Prognosen und Ursachen in Daten zu erkennen, während klassische Analyse vor allem beschreibend arbeitet. Der Unterschied liegt darin, dass KI Modelle trainiert, die aus Beispielen lernen, statt nur feste Regeln anzuwenden. In der Praxis ergänzen sich beide Ansätze: BI liefert stabile Kennzahlen, KI liefert zusätzliche Tiefe und Vorhersagen.
Welches KI-Tool ist am besten für Datenanalyse geeignet?
Es gibt kein „bestes“ Tool, sondern passende Werkzeuge für verschiedene Aufgaben. ChatGPT und Claude eignen sich gut für Explorationsfragen, Code-Generierung und Erklärungen, aber nicht als Single Source of Truth. Für wiederkehrende, prüfbare Analysen brauchst Du eine Datenplattform wie bimanu One, die BI-Tools und KI-Modelle auf einer gemeinsamen Datenbasis kombiniert.
Gibt es ein kostenloses KI-Tool zur Analyse von Excel-Daten?
Ja, viele LLMs bieten kostenlose oder günstige Varianten, mit denen Du Excel-Dateien hochladen und erste Analysen durchführen kannst. Diese eignen sich für Lernzwecke, Ad-hoc-Fragen und nicht-kritische Datensätze. Für unternehmenskritische Reports, Forecasts oder sensible Daten sind sie jedoch keine ausreichende Lösung, weil Reproduzierbarkeit, Governance und Datenschutz fehlen.
Kann ChatGPT Excel-Daten zuverlässig auswerten?
ChatGPT kann Excel-Daten lesen, zusammenfassen und einfache Berechnungen ausführen, aber es gibt keine Garantie auf korrekte, vollumfängliche Auswertung. Probleme entstehen bei komplexen Tabellen, Formaten, Filtern und fehlendem fachlichen Kontext. Du solltest Ergebnisse deshalb immer mit einem BI-System oder einer Datenplattform gegenprüfen, bevor Du Entscheidungen darauf stützt.
Sind meine Unternehmensdaten bei ChatGPT, Claude & Co wirklich sicher?
Die Anbieter investieren viel in Sicherheit, trotzdem bleiben Fragen zu Datenstandort, Speicherung und Nutzung offen – insbesondere bei kostenlosen oder öffentlich zugänglichen Varianten. Für sensible oder personenbezogene Daten ist es daher meist besser, KI-Modelle innerhalb einer kontrollierten Plattform wie bimanu One zu nutzen, in der Datenhoheit, Speicherort und Zugriffe klar geregelt sind.
Wann reicht ein Chatbot für Datenanalyse – und wann brauche ich eine Datenplattform wie bimanu One?
Ein Chatbot reicht, wenn Du einzelne, nicht-kritische Fragen klären, Formeln verstehen oder kleine Datensätze explorieren willst. Sobald mehrere Bereiche mit denselben Zahlen arbeiten, Reports regelmäßig wiederkehren oder Entscheidungen mit finanzieller Tragweite betroffen sind, brauchst Du eine strukturierte Datenplattform. bimanu One deckt genau diesen Bedarf ab und bindet Chatbots sicher ein.
Wie kann ich Ergebnisse aus KI-Datenanalysen prüfen und validieren?
Idealerweise werden KI-Ergebnisse immer gegen ein definiertes Datenmodell und etablierte Kennzahlen getestet. Das bedeutet: Du vergleichst sie mit BI-Reports, nutzt Testdaten mit bekannten Ergebnissen und etablierst ein Vier-Augen-Prinzip für kritische Entscheidungen. Eine Plattform wie bimanu One unterstützt Dich dabei mit Versionierung, Qualitätsregeln und nachvollziehbaren Datenflüssen.
Welche Datenqualität brauche ich, damit KI-Analysen sinnvoll sind?
Du brauchst keine Perfektion, aber eine verlässliche Mindestbasis: vollständige, eindeutige IDs, konsistente Zeitachsen, saubere Stammdaten und definierte Pflichtfelder für Deine wichtigsten Kennzahlen. Starte mit einem klar abgegrenzten Use Case und stelle sicher, dass die dafür relevanten Daten regelmäßig und reproduzierbar in guter Qualität vorliegen – darauf lässt sich schrittweise aufbauen.
Wie starte ich mit KI-Datenanalyse, wenn ich kein eigenes Data-Team habe?
In diesem Fall ist es sinnvoll, mit einem Plattformansatz und einem erfahrenen Partner zu starten, statt viele Einzellösungen zu kombinieren. Mit bimanu One bekommst Du eine betreute Datenplattform, bei der Integration, Modellierung und Betrieb weitgehend übernommen werden. So kannst Du Dich auf Use Cases und Fachfragen konzentrieren, während die technische Komplexität im Hintergrund bleibt.
Welche KI-Modelle kann ich mit bimanu One für meine Datenanalyse nutzen?
bimanu One setzt auf die Infrastruktur von Snowflake Cortex AI und unterstützt verschiedene moderne KI-Modelle, darunter auch Sprachmodelle wie Claude. Entscheidend ist, dass diese Modelle nicht isoliert laufen, sondern auf Deine zentral harmonisierten Daten zugreifen. Damit erhältst Du die Leistungsfähigkeit aktueller KI, kombiniert mit der Sicherheit und Prüfbarkeit einer professionellen Datenplattform.