
KI-Agenten erstellen für automatisierte Datenanalyse: Eigenbau oder Plattform?
Immer mehr Unternehmen beschäftigen sich mit KI-Agenten, um wiederkehrende Datenanalysen zu automatisieren – vom Monatsreport bis zur Ursachenanalyse in der Produktion. Gerade im Mittelstand wirkt der Eigenbau verlockend: ein Agent, der Kennzahlen erklärt, Auffälligkeiten meldet und Rückfragen in natürlicher Sprache beantwortet. Wenig Budget, schnelle Umsetzung, volle Datenkontrolle.
Die Erfahrung aus vielen Projekten zeigt: KI bringt Produktivitätsgewinne vor allem dort, wo wo Datenbasis, Prozesse und Governance stimmen. Agenten verstärken alles, was vorhanden ist – gute Struktur genauso wie Datenchaos. In diesem Artikel erfährst Du, was ein KI-Agent für Datenanalyse konkret ist, wie Du einen solchen Agenten erstellen kannst, wo Risiken liegen und in welchen Fällen eine Plattform wie bimanu One der vernünftigere Weg ist.
KI-Agenten für Datenanalyse: Was steckt dahinter?
Was ist ein KI-Agent für Datenanalyse? (klare Definition)
Ein KI-Agent für Datenanalyse ist eine Softwarekomponente, die ein Analyseziel entgegennimmt, einen Plan erstellt, Daten abruft, Berechnungen ausführt und ein Ergebnis in verständlicher Form zurückliefert. Im Unterschied zu einem reinen Chat-Modell arbeitet ein Agent mit Tools wie SQL, Python, BI-APIs oder Ticket-Systemen und kann mehrere Schritte sequenziell oder iterativ ausführen.
Gartner spricht in diesem Kontext von „Agentic Analytics“: KI-Agenten, die über verschiedene Datenquellen und Anwendungen hinweg agieren und Analytics- und BI-Prozesse eigenständig anstoßen oder durchlaufen. Für Dich heißt das: Ein Agent beantwortet nicht nur Fragen, sondern erledigt Teile der Analysearbeit – inklusive Datenzugriff, Berechnung und Aufbereitung.
KI-Agent vs. Chatbot: Wo genau liegt der Unterschied?
Ein klassischer Chatbot – auch ein ChatGPT-Interface – antwortet vor allem textbasiert auf Eingaben. Er „erfindet“ Antworten aus dem gelernten Sprachmuster und nutzt externe Daten nur, wenn Du sie im Prompt mitlieferst oder eine spezielle Anbindung gebaut wurde. Er führt in der Regel keine eigenständigen Aktionen auf Deinen Systemen aus.
Ein KI-Agent dagegen hat Zugriff auf definierte Werkzeuge: Er kann SQL-Queries gegen Dein Data Warehouse ausführen, BI-Reports aktualisieren, Datenqualitätschecks starten oder Tickets für Datenfehler erstellen. Er arbeitet zielorientiert, plant Zwischenschritte und prüft Ergebnisse – und genau deshalb braucht er klare Rechte, Guardrails und Protokollierung.
Welche Analyseaufgaben KI-Agenten heute im Mittelstand übernehmen können
In der Praxis übernehmen KI-Agenten vor allem strukturierte, wiederkehrende Analysen, bei denen heute viel manuelle Arbeit anfällt. Typisch sind Abweichungsanalysen im Controlling, Standardreports in Vertrieb oder Produktion und Datenqualitätsprüfungen in heterogenen Systemlandschaften.
Beispiele sind etwa die automatische Erstellung eines kommentierten Monatsberichts, die Identifikation von Ausreißern bei Ausschussquoten oder die tägliche Prüfung, ob alle Schnittstellen für den morgendlichen Reportlauf sauber gelaufen sind. Der Agent liefert damit nicht nur Zahlen, sondern direkt interpretierte Erkenntnisse in natürlicher Sprache.
Typische Einsatzfelder: Reporting, Kennzahlen-Monitoring, Ursachenanalyse, Prognosen
Im Reporting können Agenten Standardkennzahlen abrufen, filtern und in Dashboards einbinden oder Management-Summaries generieren, ohne dass jemand manuell Abfragen formuliert. Beim Kennzahlen-Monitoring überwachen sie Schwellwerte, Trends und Ausreißer und melden Auffälligkeiten proaktiv.
In der Ursachenanalyse verknüpfen Agenten strukturierte Daten aus ERP, MES oder CRM mit Freitextfeldern aus Tickets, Schichtberichten oder Notizen, um wahrscheinliche Treiber für Abweichungen zu benennen. Bei Prognosen unterstützen sie, indem sie vorbereitete Machine-Learning-Modelle ansteuern, Vorhersagen erstellen und deren Ergebnisse verständlich einordnen.
Kostenloses Erstgespräch vereinbaren
Bausteine: Aus welchen Komponenten Du einen KI-Agenten erstellen kannst
Das Sprachmodell: ChatGPT, Claude & Co. als Kern des KI-Agenten
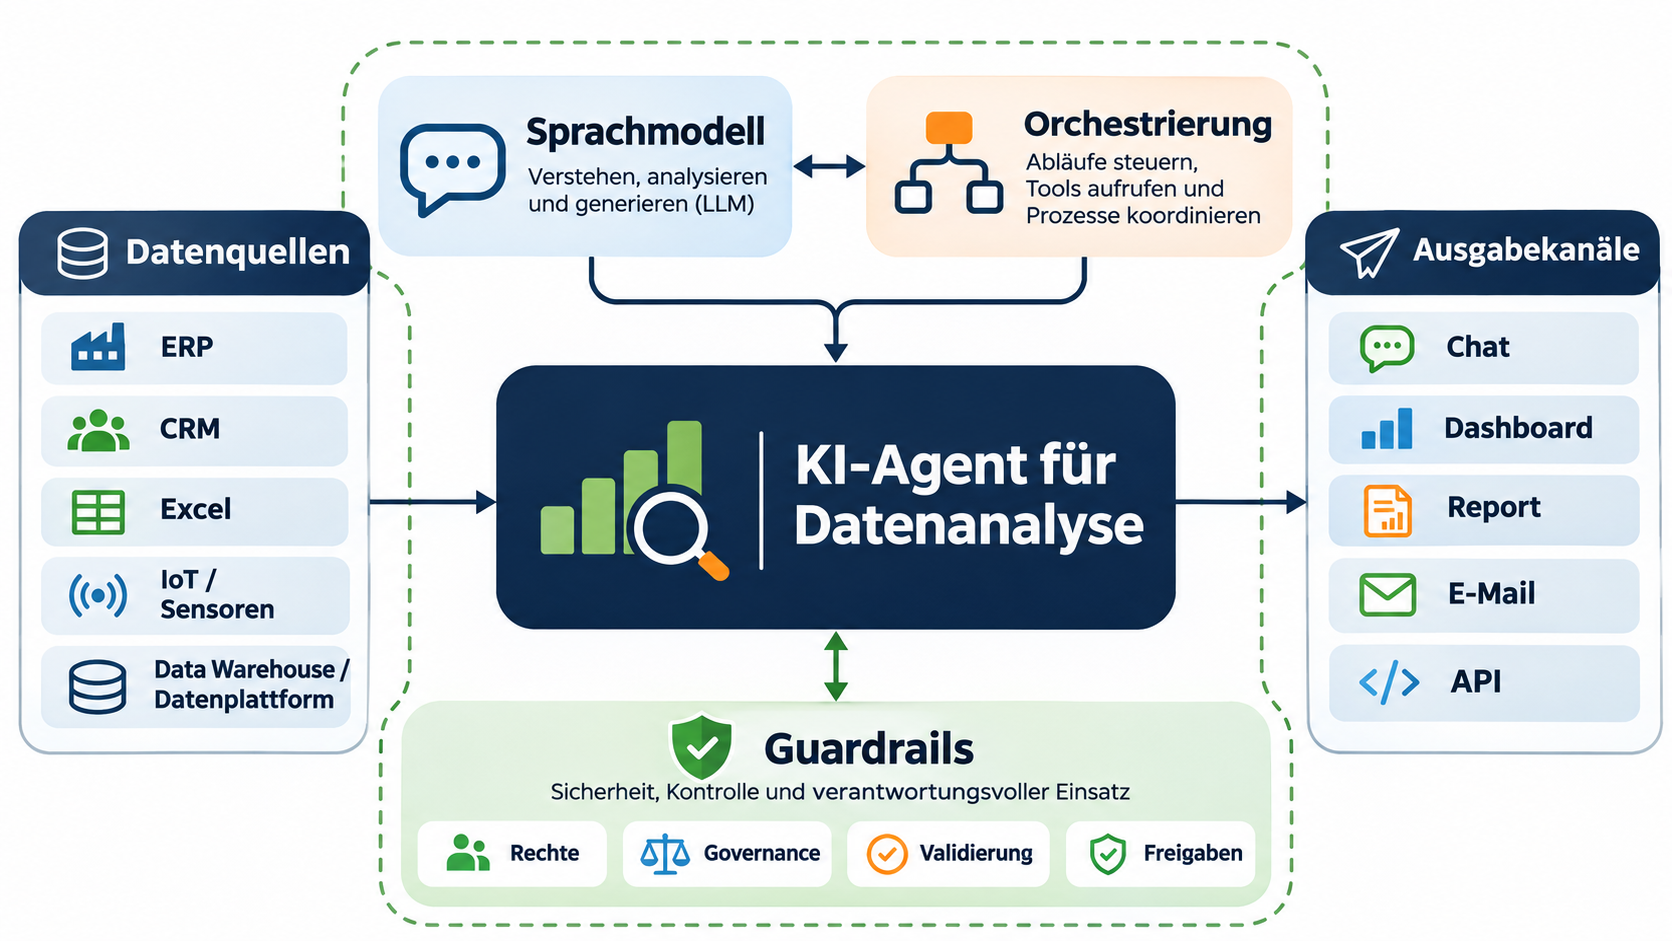
Herzstück jedes KI-Agenten ist ein Sprachmodell (LLM), das Anfragen versteht, Pläne bildet und Textantworten formuliert. Ja, viele Anbieter wie ChatGPT oder Claude bieten heute Funktionen, um Fragen wie „Warum ist der Umsatz im Segment X gesunken?“ in konkrete Analyse-Schritte zu übersetzen.
Wichtig ist dabei weniger, dass das Modell besonders groß oder spektakulär ist, sondern dass es stabil, gut dokumentiert und sicher integriert ist. Für produktive Szenarien brauchst Du garantierte Verfügbarkeit, klare Aussagen zur Datennutzung und die Möglichkeit, interne Geschäftsbegriffe und Regeln als Kontext mitzugeben.
Datenquellen und Schnittstellen: ERP, CRM, MES, IoT, Datenbanken
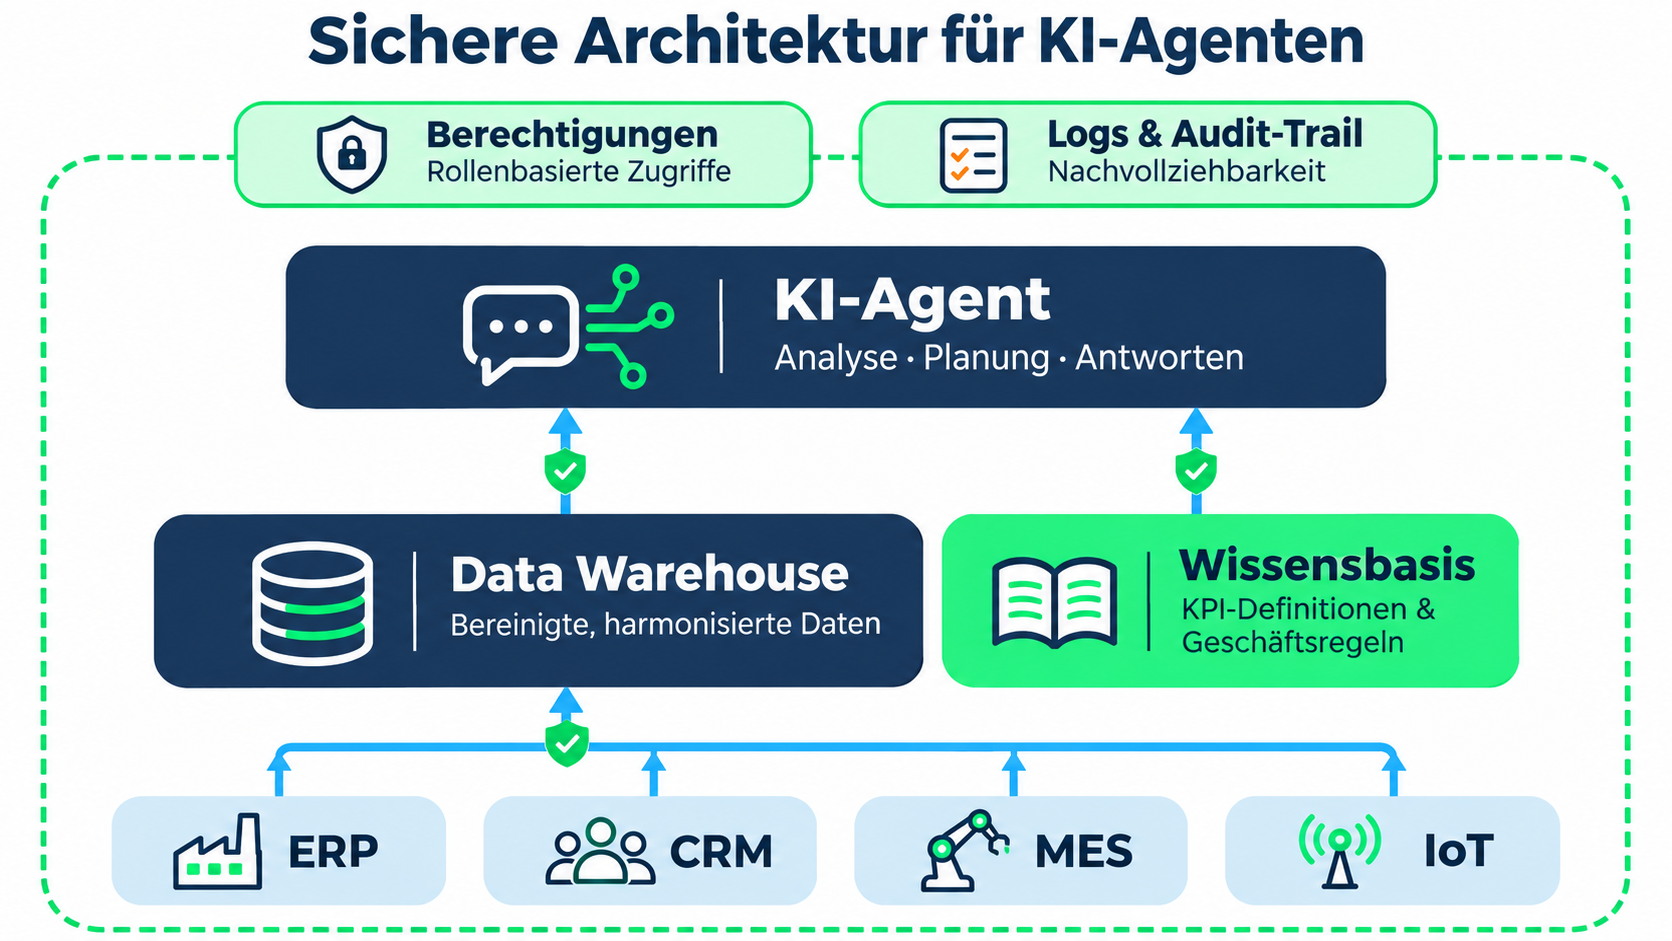
Ein Agent kann nur analysieren, was er sehen darf. In mittelständischen Unternehmen liegen relevante Daten meist verteilt in ERP-Systemen, CRM, MES, BDE, IoT-Plattformen, Data Warehouses und vielen Excel-Dateien. Ein produktiver Agent greift in der Regel nicht direkt auf jedes operative System zu, sondern arbeitet über ein zentrales Datenmodell.
Technisch erfolgt der Zugriff typischerweise über Datenbankverbindungen, APIs, definierte Views im Data Warehouse oder exportierte Dateien. Entscheidend ist, dass Du eine klare Schicht definierst, in der Bereinigung, Harmonisierung und Kennzahlendefinitionen bereits sauber umgesetzt sind – sonst reproduziert der Agent nur Dein bestehendes Datenchaos.
Orchestrierung und Workflows: n8n, Make, LangChain & andere Frameworks
Zwischen Sprachmodell und Datenquellen liegt die Orchestrierung. Hier wird festgelegt, wie der Agent einzelne Aktionen hintereinander ausführt: Query planen, Daten holen, validieren, Bericht erstellen, Ergebnis verschicken. Tools wie n8n oder Make bieten dafür visuelle Workflows, während Frameworks wie LangChain oder ähnliche Bibliotheken stärker entwicklerorientiert sind.
In dieser Schicht definierst Du auch Wiederholfrequenzen, Fehlerbehandlung und Eskalationspfade. Beispielsweise kann ein Agent bei fehlgeschlagener Abfrage die Anfrage erneut ausführen oder automatisch ein Ticket im Service-Tool anlegen, statt einfach eine leere Antwort zu liefern.
Ausgabekanäle: Chat-Interface, E-Mail-Reports, Dashboards, APIs
Das Ergebnis eines Agenten muss dort landen, wo Entscheidungen getroffen werden. Häufig ist das ein Chat-Interface im Browser oder in Teams, in dem Fachanwender Fragen stellen und direkt Antworten erhalten. Ebenso verbreitet sind automatisierte E-Mail-Reports mit erklärten Kennzahlen oder Hinweise in bestehenden Dashboards.
In weiter gereiften Setups liefern Agenten Ergebnisse auch über APIs an andere Systeme, etwa an ein BI-Tool wie Power BI, ein Ticket-System oder eine Produktionsleitwarte. Je weniger Medienbrüche entstehen, desto höher sind Akzeptanz und Nutzen im Alltag.
Guardrails und Berechtigungen: Rollen, Zugriffe, Protokollierung
Weil Agenten automatisiert auf Daten zugreifen, brauchst Du klare Leitplanken. Dazu gehören Rollen- und Rechtekonzepte, die definieren, welche Tabellen, Views oder KPIs ein Agent überhaupt nutzen darf, sowie technische Mechanismen wie Row-Level-Security oder Datenmaskierung.
Ebenso wichtig ist eine lückenlose Protokollierung: Welche Frage wurde gestellt, welche Abfragen wurden ausgeführt, welche Ergebnisse erzeugt? Nur so kannst Du im Fehler- oder Auditfall nachvollziehen, wie eine Zahl zustande kam – eine zentrale Anforderung im Kontext von DSGVO und EU AI Act.
Warum Unternehmen eigene KI-Agenten erstellen wollen
Geringe Einstiegskosten und schnelle Prototypen
Der erste Reiz am Eigenbau ist meist wirtschaftlich: Du kannst mit geringen Lizenzkosten und ein wenig Zeit in der IT oder im BI-Team einen Prototypen aufsetzen, der schon nach wenigen Tagen erste Antworten liefert. Laut Bitkom setzen 2026 erstmals 57 Prozent der Unternehmen ab 20 Beschäftigten KI ein – viele davon starten genau mit solchen Low-Budget-Experimenten.
Gerade wenn Du einzelne, klar begrenzte Fragestellungen testen willst, etwa „Welche Kunden haben ihre Bestellfrequenz stark reduziert?“, lässt sich ein Agent-Prototyp schnell auf Basis bestehender LLM-APIs und Workflows aufbauen. Das mindert Eintrittshürden und hilft, Erfahrungen zu sammeln, ohne direkt ein großes Projekt zu starten.
Passgenaue Lösungen statt Standard-Dashboards
Standard-Dashboards sind oft generisch und beantworten nicht die vielen „Warum“-Fragen aus den Fachbereichen. Ein selbstgebauter KI-Agent lässt sich dagegen genau auf Deine Prozesse, Deinen Datenraum und Deine Terminologie zuschneiden. Er kann etwa Produktionslinien, Produktgruppen oder interne Vertriebsregionen exakt so benennen, wie sie im Alltag genutzt werden.
Damit entsteht ein System, das sich für die Nutzer natürlicher anfühlt als ein generisches Reporting-Tool. Der Agent kann beispielsweise direkt auf interne KPI-Begriffe reagieren („Zeig mir die Entwicklung unseres DB2 im OEM-Geschäft seit Q1“), statt dass der Nutzer sich durch Filterbäume klicken muss.
Kontrolle über Daten, Logik und Betriebsmodell
Viele Unternehmen wollen vermeiden, sensible Kennzahlen in externe, wenig transparente Services zu geben. Ein Eigenbau-Agent, der in der eigenen Infrastruktur oder in einer kontrollierten Umgebung läuft, schafft hier ein Stück Sicherheit: Du definierst, wo Daten liegen, welche Modelle genutzt werden und wie Logs gespeichert werden.
Gleichzeitig behältst Du die Hoheit über fachliche Logiken. Du kannst etwa exakt festlegen, wie Deckungsbeiträge oder Ausschussquoten zu berechnen sind und diese Definitionen als wiederverwendbare Bausteine im Agenten hinterlegen – statt Dich an die KPI-Definitionen eines Standardprodukts anpassen zu müssen.
Entlastung im Alltag: wiederkehrende Datenanalysen automatisieren
In vielen Unternehmen sitzen Controller, Produktionsplaner oder Vertriebsleiter regelmäßig abends noch vor Excel, um denselben Bericht zum x-ten Mal zu aktualisieren. Hier verspricht ein KI-Agent konkrete Entlastung: Er übernimmt Standardabfragen, fasst Ergebnisse zusammen und weist proaktiv auf Auffälligkeiten hin.
Wenn ein Agent beispielsweise täglich die wichtigsten Abweichungen in der OEE, im Auftragseingang oder in der Lieferperformance prüft und mit kurzen Kommentaren versieht, bleibt mehr Zeit für echte Ursachenanalyse und Maßnahmenentwicklung – statt Wochenberichte manuell zu pflegen.
Lerneffekt im Team: Kompetenzen in KI und Daten aufbauen
Der Eigenbau eines KI-Agenten ist auch ein Lernprojekt. Fachbereiche, IT und BI kommen ins Gespräch darüber, welche Daten wo liegen, wie Kennzahlen definiert werden und welche Fragen die Organisation wirklich beantwortet haben möchte. Dieser Lerneffekt ist für viele Teams ein wichtiger Antrieb.
Gerade im Mittelstand, in dem eigene Data-Science-Teams selten sind, hilft ein solches Projekt, internes Verständnis für Datenpipelines, Modellgrenzen und regulatorische Anforderungen aufzubauen. Dieser Kompetenzaufbau ist langfristig wertvoll, unabhängig davon, ob Du später bei Eigenbau, Plattform oder einer Kombination landest.
Die Kehrseite: Risiken und Grenzen beim Eigenbau von KI-Agenten
Halluzinationen, Rechenfehler und falsche Kennzahlen
Sprachmodelle arbeiten probabilistisch. Sie liefern mit hoher Wahrscheinlichkeit plausible, aber nicht zwingend korrekte Antworten. Wenn ein Agent SQL-Queries generiert, kann er zwar syntaktisch richtige Abfragen bauen, aber fachlich falsche Join-Logiken oder Aggregationen wählen – mit direkten Folgen für Deine Kennzahlen.
Fehlender Unternehmenskontext: Die KI kennt Deine Definitionen nicht
Ein generisches LLM weiß nicht, was in Deinem Unternehmen „Deckungsbeitrag 2“, „Auftragsbestand“ oder „Qualitätsfall A“ exakt bedeutet. Selbst wenn der Agent auf Deine Daten zugreifen kann, interpretiert er Felder anhand allgemeiner Muster und nicht anhand Deiner individuellen Logik.
Ohne hinterlegte Kennzahlendefinitionen, einheitliche Begriffe und ein fachliches Datenmodell entsteht eine gefährliche Lücke: Zahlen sehen korrekt formatiert aus, entsprechen aber nicht dem, was Finance, Produktion oder Vertrieb unter diesen Kennzahlen verstehen. Vertrauen ins Reporting kann so sehr schnell Schaden nehmen.
Schlechte Datenqualität, Datensilos und manuelle Exporte
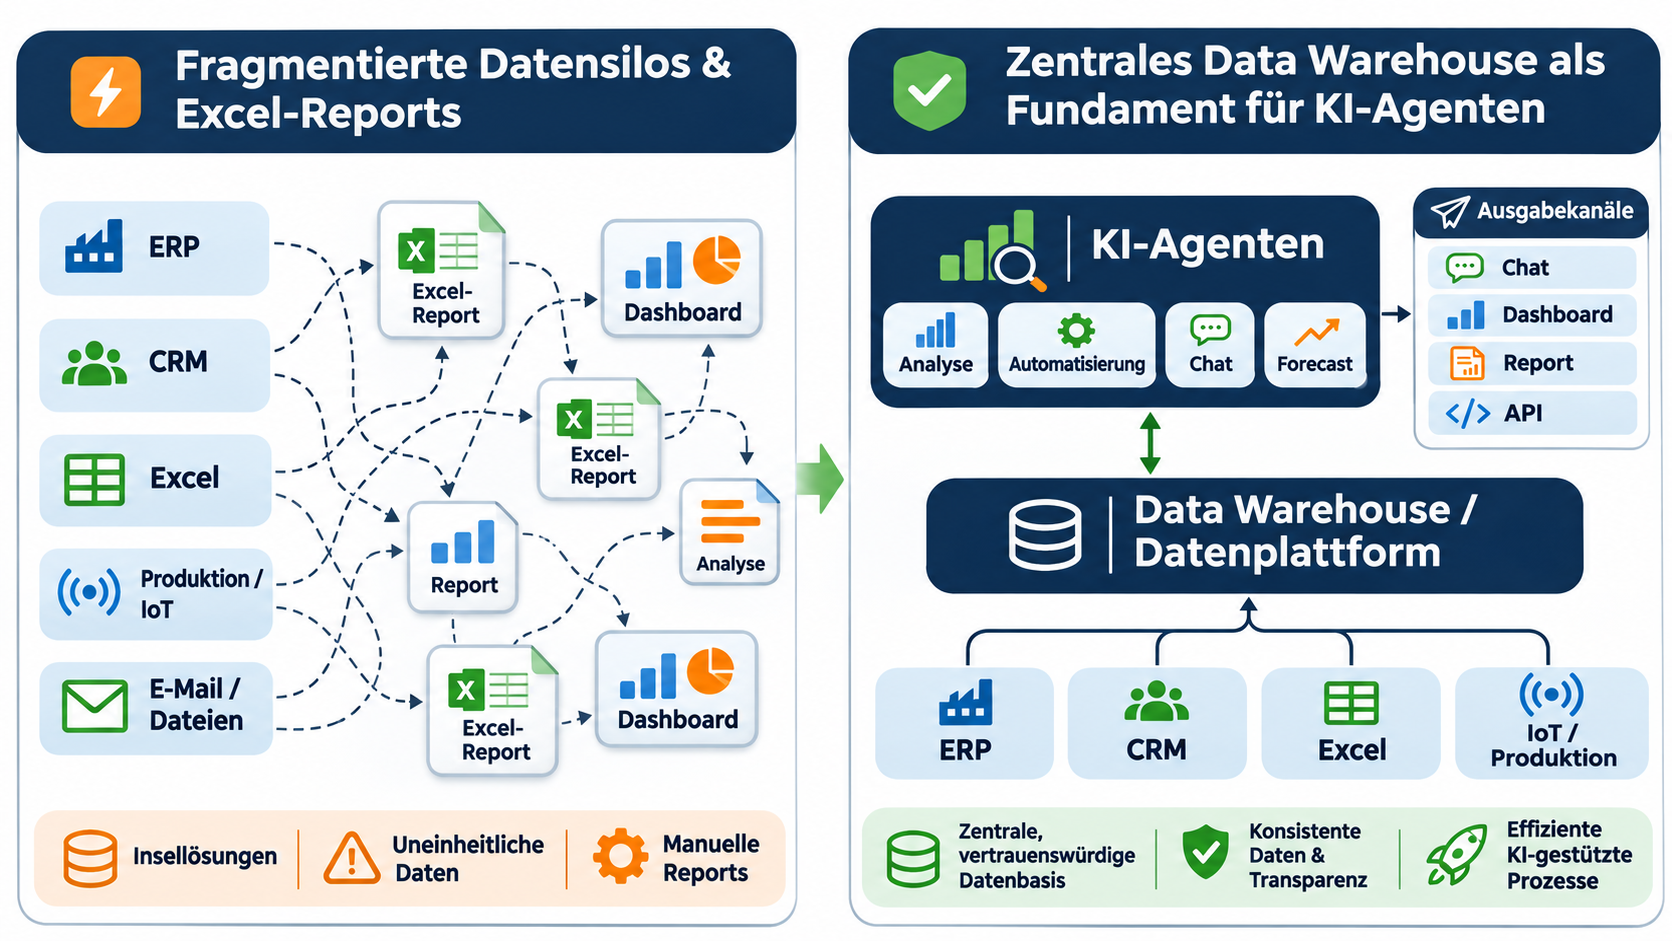
Wenn Deine Datenbasis heute aus vielen isolierten Systemen, manuellen Exporten und Excel-Logiken besteht, verstärkt ein Agent dieses Problem eher, als es zu lösen. Er wird dann auf instabile Datenstände zugreifen, sich auf nicht dokumentierte Feldbedeutungen stützen und Fehler aus Quellsystemen reproduzieren.
Ein KI-Agent ist kein Ersatz für fehlende Datenarchitektur. Er braucht ein solides Fundament aus konsolidierten, bereinigten und dokumentierten Daten. Ohne dieses Fundament verschleißt Du Zeit und Vertrauen, weil jede Agenten-Antwort aufwendig überprüft werden muss.
Datenschutz, DSGVO und EU AI Act: Was beachtet werden muss
Der EU AI Act ist seit 2024 in Kraft und wird schrittweise wirksam. Die KI-Kompetenzpflicht gilt bereits seit Februar 2025, die Pflichten für Hochrisiko-Systeme wurden auf Dezember 2027 verschoben. Transparenz, Governance und Risikomanagement für KI-Systeme rücken damit schon heute in den Fokus. Auch wenn viele Analyse-Agenten nicht automatisch in die High-Risk-Kategorie fallen, müssen Datenflüsse, Zugriffskonzepte und Entscheidungswege dokumentiert und auditierbar sein.
Für Dich bedeutet das: Du musst nachvollziehbar darlegen können, welche Daten der Agent nutzt, ob personenbezogene Daten verarbeitet werden, wie Ergebnisse überprüft werden und wer verantwortlich ist. Ein rasch zusammengesteckter Eigenbau-Agent ohne Governance-Konzept kann hier schnell zur Compliance-Baustelle werden.
Wartungsaufwand, technischer Schuldenberg und Personenabhängigkeit
Was als überschaubares Projekt beginnt, wächst oft zu einer komplexen Lösung: Mehr Datenquellen, mehr Use Cases, mehr Speziallogik. Wenn all das in individuellen Workflows, Prompts und Skripten steckt, die nur eine oder zwei Personen wirklich verstehen, entsteht eine starke Abhängigkeit.
Verlässt diese Person das Unternehmen oder ändert sich Deine Systemlandschaft, wird der Agent schnell zur Blackbox. Änderungen in ERP oder MES schlagen dann auf die Agentenlogik durch, ohne dass jemand diese Abhängigkeiten sauber überblickt – ein klassischer technischer Schuldenberg.
Tipp aus der Praxis: Wenn Du einen Eigenbau-Agenten planst, kalkuliere von Anfang an Zeit für Dokumentation, Tests und Wartung ein. Baue kein System, das nur eine Person versteht. Sonst verlagerst Du lediglich Deine Abhängigkeiten – vom manuellen Excel-Reporting hin zur Agenten-Schatten-IT.
Der zentrale Punkt: Ein KI-Agent ist nur so gut wie seine Datenbasis
Zentrale, saubere, dokumentierte Daten vs. Excel- und Tool-Wildwuchs
In vielen Projekten zeigt sich dieselbe Ursache: Nicht das KI-Modell ist der Engpass, sondern die Daten. Wenn Kennzahlen heute über verschiedene Excel-Dateien, BI-Tools und Fachbereichs-Logiken verteilt sind, kann ein Agent keine stabile Wahrheit herstellen. Er spiegelt nur die Inkonsistenz.
Eine zentrale, automatisiert befüllte Datenbasis – ob als Data Warehouse oder Lakehouse – reduziert diese Komplexität. Sie sorgt dafür, dass alle Analysen auf denselben, bereinigten und historisierten Daten aufsetzen und dass Änderungen an Definitionen an einem Ort gepflegt werden.
Warum Kennzahlen-Definitionen und Geschäftslogiken entscheidend sind
Ein guter Teil des Nutzens von BI- und KI-Systemen entsteht nicht durch Technologie, sondern durch saubere fachliche Modellierung. Wenn klar definiert ist, wie Umsatz, Marge, Ausschuss, OEE oder Lieferperformance zu berechnen sind, kann ein Agent diese Logiken zuverlässig anwenden – egal, wer fragt.
Ohne diese Definitionen bleibt jede Analyse interpretierbar. Der Vertrieb meint mit Umsatz etwas anderes als das Controlling, die Produktion versteht Stillstandsgründe anders als die Instandhaltung. Ein Agent, der diese Unterschiede nicht kennt, verstärkt die Missverständnisse statt sie aufzulösen.
Data Warehouse, Datenmodell und Governance als Fundament für KI-Datenanalyse
Technisch gesehen ist ein Data Warehouse mit klaren Datenmodellen, historisierten Dimensionen und standardisierten Fakten der ideale Unterbau für Analyse-Agenten. Hier sind Datenqualität, Historie und Beziehungen bereits geklärt, und der Agent arbeitet auf stabil definierten Views und Kennzahlen.
Governance-Regeln wie Freigabeprozesse für neue KPIs, Versionierung von Logiken und definierte Zuständigkeiten sorgen dafür, dass der Agent nicht beliebig „an der Wahrheit schrauben“ kann. Er wird damit zu einem Interface auf eine belastbare Datenarchitektur – nicht zu einem freien Interpretationssystem.
Was passiert, wenn Du ohne Datenfundament KI-Agenten erstellst
Wenn Du einen Agenten direkt auf operative Systeme und Excel-Exporte loslässt, sind die ersten Antworten oft beeindruckend – aber schwer reproduzierbar. Schon kleine Änderungen in Datenstrukturen oder Filestrukturen führen zu anderen Ergebnissen, und niemand kann mehr genau nachvollziehen, warum welcher Wert wann galt.
Das führt in der Praxis zu drei Effekten: zusätzliche Kontrollaufwände, sinkendes Vertrauen in KI-Ausgaben und wachsende Zurückhaltung gegenüber weiteren Automatisierungsprojekten. Statt Beschleunigung entsteht Skepsis – oft, obwohl das eigentliche Problem in der Datenbasis lag, nicht in der KI.
Schritt für Schritt: Wie Du einen einfachen KI-Agenten für Datenanalyse erstellst
1. Zweck und Use Case Deines KI-Agenten klar definieren
Starte nicht mit der Technologie, sondern mit einem klar umrissenen Use Case. Beispiel: „Monatliche Vertriebsabweichungen auf Kunden- und Produktgruppenebene erklären“ oder „Tägliche Meldung der fünf größten OEE-Abweichungen pro Linie mit vermuteten Ursachen“.
Je klarer Du Zielgruppe, Datenraum, Kennzahlen und gewünschten Output definierst, desto leichter lässt sich der Agent fokussiert bauen und testen. Ein Agent, der „alles können soll“, bleibt meist nebulös und schwer belastbar.
2. Datenquellen auswählen und anbinden
Im nächsten Schritt klärst Du, auf welche Daten der Agent zugreifen muss, um den definierten Use Case zu bedienen. Idealerweise nutzt Du dazu bestehende Data-Warehouse-Views oder harmonisierte Datentabellen, nicht rohe Exporte aus ERP oder CRM.
Technisch verbindest Du den Agenten über gesicherte Datenbankverbindungen, APIs oder Dateischnittstellen mit diesen Quellen. Wichtig: Zugriffsrechte sollten so granular sein, dass der Agent nur genau die Tabellen und Felder sieht, die für seinen Zweck notwendig sind.
3. Sprachmodell und Agenten-Plattform auswählen
Auf Basis Deiner Sicherheitsanforderungen und Infrastruktur wählst Du ein passendes Sprachmodell und eine Plattform. Für einfache, nicht kritische Use Cases können gehostete Modelle ausreichen, bei sensiblen Daten und Compliance-Anforderungen sind Enterprise-Modelle mit klarer Datentrennung sinnvoller.
Achte bei der Auswahl auf Transparenz zur Datennutzung, Hosting-Standort, Integrationsmöglichkeiten und Kostenstruktur. Das Modell sollte sich später austauschen lassen, ohne dass Du den gesamten Agenten neu entwickeln musst.
4. Orchestrierung und Workflows modellieren (z. B. mit n8n)
Nun definierst Du, wie der Agent seine Arbeitsschritte konkret ausführt. Das kann in einem visuellen Workflow-Tool wie n8n oder Make geschehen oder in einem Entwicklerframework. Typisch sind Schritte wie: Anfrage verstehen, relevante KPI-Definitionen laden, SQL-Query generieren, Ergebnis plausibilisieren, Antwort formulieren.
Hier legst Du auch Wiederholhäufigkeiten, Fehlerpfade und Eskalationen fest. Beispiel: Wenn ein Datenqualitätscheck fehlschlägt, erstellt der Agent automatisch ein Ticket beim BI-Team mit Query, Zeitstempel und Fehlermeldung.
5. Unternehmenskontext und Kennzahlen-Regeln hinterlegen
Damit der Agent nicht nur „irgendwelche“ Kennzahlen liefert, musst Du ihm Dein fachliches Regelwerk beibringen. Das umfasst definierte KPI-Beschreibungen, erlaubte Filter, typische Dimensionen und ggf. Blacklists für Felder oder Berechnungen, die er nicht eigenständig verändern darf.
Dieser Kontext kann in einer eigenen Wissensbasis, in Datenbanktabellen oder in einem semantischen Layer liegen. Wichtig ist, dass der Agent diese Informationen systematisch nutzt und nicht bei jeder Anfrage neu „rät“, wie eine Kennzahl zu interpretieren ist.
6. Testen, validieren und Guardrails einziehen
Bevor Dein Agent in den produktiven Alltag geht, braucht es strukturierte Tests. Lege dafür typische Fragestellungen und erwartete Antworten fest und prüfe, ob der Agent diese reproduzierbar liefert. Achte besonders auf Edge Cases, etwa leere Datenbereiche oder strukturelle Änderungen in den Quellen.
Ergänzend definierst Du Guardrails: Welche Tabellen darf der Agent nicht ansprechen, welche Aktionen benötigen eine menschliche Freigabe, welche Schwellenwerte lösen einen Alarm aus? Erst mit diesen Leitplanken wird aus einem experimentellen Agenten ein verantwortbar einsetzbares System.
7. Rollout, Monitoring und fortlaufende Optimierung
Beim Rollout startest Du sinnvollerweise mit einem kleinen Nutzerkreis und klarer Kommunikation: Was kann der Agent, was nicht, wie wird Feedback gegeben? Parallel etablierst Du ein Monitoring, das Nutzung, Fehlerraten, Laufzeiten und Kosten im Blick behält.
Auf Basis dieses Monitorings verbesserst Du Prompts, Workflows und Kontext schrittweise. So entwickelt sich Dein Agent kontrolliert weiter – statt dass immer neue Funktionen ad hoc hinzukommen und das System unbeherrschbar machen.
Tools und Plattformen: Womit Du KI-Agenten erstellen kannst
Low-Code- und No-Code-Lösungen für den schnellen Einstieg
Für den Einstieg eignen sich Plattformen, die Agenten-Funktionalität bereits integriert anbieten. Viele LLM-Anbieter ermöglichen heute das Konfigurieren von „Assistenten“ oder „Agents“ mit wenigen Klicks, inklusive Toolzugriff und einfachen Workflows. Ergänzend bieten Workflow-Tools wie n8n, Make oder ähnliche Services fertige Bausteine für Datenbankzugriffe und Benachrichtigungen.
Damit kannst Du ohne tiefgreifende Programmierkenntnisse erste Agenten für klar umrissene Aufgaben bauen. Die Grenzen liegen meist dort, wo komplexe Berechtigungsmodelle, ausgefeilte Datenmodelle oder spezielle Compliance-Anforderungen ins Spiel kommen.
Enterprise-Plattformen und Agent-Studios für komplexere Szenarien
Größere Organisationen oder Unternehmen mit hohen Sicherheitsanforderungen setzen häufig auf spezialisierte Enterprise-Plattformen oder „Agent Studios“. Diese bieten integrierte Entwicklungs-, Test- und Betriebsumgebungen mit Features wie Audit-Trails, Rollenmodellen, Kostenmonitoring und Anbindung an Identity-Management-Systeme.
Solche Plattformen sind in der Regel stärker regulierungsfähig, erfordern aber auch mehr initiale Einrichtung und ein erfahrenes Team. Für den Mittelstand sind sie vor allem dann interessant, wenn KI-Agenten unternehmenskritische Entscheidungen unterstützen oder in mehreren Geschäftsbereichen gleichzeitig eingesetzt werden sollen.
Entwickler-Frameworks wie LangChain & Co. im Vergleich
Entwicklerorientierte Frameworks wie LangChain oder ähnliche Bibliotheken richten sich an Teams, die Agentenlogik tief in eigene Anwendungen integrieren wollen. Sie bieten maximale Flexibilität beim Tool-Aufruf, beim Reasoning und bei der Einbettung in bestehende Software.
Diese Freiheit geht jedoch mit höherem Engineering-Aufwand einher: Du brauchst saubere Software-Architektur, Teststrategien und Deployment-Pipelines. Ohne entsprechendes Skillset im Team ist das Risiko hoch, eine schwer wartbare Speziallösung zu bauen.
Was bei der Toolwahl im Mittelstand wirklich wichtig ist
Für mittelständische Unternehmen sind weniger exotische Features entscheidend als Stabilität, Integrationsfähigkeit und klare Verantwortlichkeiten. Wichtige Kriterien sind ein europäischer oder klar regulierter Hosting-Standort, saubere API-Schnittstellen, nachvollziehbares Kostenmodell und die Möglichkeit, mit wachsender Komplexität Schritt zu halten.
Prüfe bei jedem Tool, wie gut es sich in Deine bestehende Daten- und BI-Landschaft einfügt und ob es Governance-Funktionen wie Logging, Rechteverwaltung und Versionierung mitbringt. Ein vermeintlich schneller Einstieg ohne diese Funktionen kann später teuer werden.
| Kategorie | Stärken | Typische Grenzen |
|---|---|---|
| No-Code-/Low-Code-Agenten | Schneller Start, wenig Programmierung, gut für Prototypen und einfache Use Cases. | Begrenzte Anpassbarkeit, eingeschränkte Governance, teils unklare Datenpfade. |
| Enterprise-Agentenplattformen | Integrierte Sicherheit, Auditierbarkeit, Skalierbarkeit, Support. | Höherer Preis, mehr Setup-Aufwand, teils komplex in der Bedienung. |
| Entwickler-Frameworks | Maximale Flexibilität, tiefe Integration in eigene Anwendungen. | Hoher Entwicklungs- und Wartungsaufwand, Bedarf an erfahrenen Entwicklern. |
Ohne Programmierung KI-Agenten erstellen: Was realistisch ist
Welche Schritte sich mit No-Code/Low-Code abbilden lassen
Viele Plattformen ermöglichen es Dir heute, Agentenrollen zu definieren, Tools anzubinden und Basis-Workflows zu konfigurieren, ohne selbst Code zu schreiben. Insbesondere einfache Datenabfragen, Benachrichtigungen oder das Generieren von Textreports lassen sich so weitgehend per Konfiguration aufbauen.
Für klar abgegrenzte Aufgaben – etwa „täglicher Vertriebsbericht auf Basis einer vordefinierten View“ – ist das ein realistisches Szenario. Du kannst damit erste Automatisierungserfolge erzielen, ohne direkt ein Entwicklerteam aufzubauen.
Wo technische Expertise zwingend notwendig bleibt
Spätestens dort, wo es um komplexe Datenmodelle, Performance-Optimierung, Fehlerbehandlung oder Sicherheitsarchitektur geht, reicht No-Code nicht mehr aus. Du brauchst Menschen, die Datenbankabfragen verstehen, Rechtekonzepte entwickeln und Änderungen in Quellsystemen technisch bewerten können.
Auch für die Einhaltung regulatorischer Anforderungen und für die Integration in bestehende CI/CD-Prozesse ist technisches Know-how unverzichtbar. Ein No-Code-Agent ohne professionellen Unterbau kann zwar kurzfristig funktionieren, ist aber langfristig schwer zu kontrollieren.
Rollenverteilung: Fachbereich, IT, externer Partner
In einem sinnvollen Setup definieren Fachbereiche die Use Cases, Kennzahlen und Akzeptanzkriterien, während IT oder BI-Teams für Datenanbindung, Architektur und Sicherheit sorgen. Externe Partner können dort unterstützen, wo internes Wissen oder Kapazität fehlen.
Diese Rollenverteilung vermeidet zwei Extreme: Fachbereiche, die unkontrollierte Agenten-Schatten-IT bauen, und IT-Abteilungen, die den Fachbereichsbedarf nicht verstehen. Ein gemeinsamer Rahmen und klare Zuständigkeiten sind Voraussetzung für stabile Lösungen.
Kostenloses Erstgespräch vereinbaren
KI-Agenten mit internen Daten und Tools verbinden
Anbindung von ERP-, CRM-, MES- und IoT-Systemen
Für wirklich wertvolle Analysen muss Dein Agent auf die Kernsysteme zugreifen, in denen operative und finanzielle Daten liegen. Der direkte Zugriff auf ERP, CRM, MES oder IoT-Plattformen ist allerdings sensibel, weil hier oft personenbezogene Daten und geschäftskritische Informationen verarbeitet werden.
In der Praxis bietet es sich an, nicht jedes System einzeln anzubinden, sondern einen zentralen Datenhub oder ein Data Warehouse zu nutzen. So kontrollierst Du an einer Stelle, welche Daten in welchem Zuschnitt für KI-Anwendungen verfügbar sind, und musst Berechtigungen nicht in jedem System separat pflegen.
API, Datenbankzugriffe und Dateischnittstellen im Überblick
Technisch kommen meistens drei Wege zum Einsatz: direkte Datenbankverbindungen, APIs der Quellsysteme oder Dateiimporte, etwa aus CSV- oder Parquet-Files. Direkte DB-Zugriffe sind performant, erfordern aber saubere Rechtekonzepte; APIs sind oft sicherer, dafür langsamer; Dateischnittstellen sind flexibel, aber wartungsintensiv.
Für Analyse-Agenten ist wichtig, dass die Datenanbindung wiederholbar, dokumentiert und automatisierbar ist. Manuelle Exporte und Uploads mögen im Prototyp reichen, sind aber kein Fundament für eine produktive Lösung.
Kontextdokumente und Wissensbasen: Wie der Agent Dein Unternehmen versteht
Neben strukturierten Daten braucht der Agent Kontext: Prozessbeschreibungen, KPI-Glossare, Richtlinien oder FAQs. Diese Informationen kannst Du in einer Wissensbasis ablegen, auf die der Agent bei Bedarf zugreift, um Antworten zu erklären oder Entscheidungen zu begründen.
So kann der Agent beispielsweise nicht nur melden, dass die OEE auf Linie 3 um 5 Prozentpunkte gesunken ist, sondern direkt auf interne Definitionen verweisen, erläutern, wie OEE berechnet wird, und welche Maßnahmen typischerweise geprüft werden.
Datensicherheit und Berechtigungen beim Zugriff auf operative Systeme
Sobald ein Agent Zugriff auf operative Systeme erhält, musst Du ihn wie einen technischen Nutzer mit klaren Rechten behandeln. Dazu gehören separate Service-Accounts, rollenbasierte Zugriffe, Protokollierung und regelmäßige Reviews der vergebenen Berechtigungen.
Besonders bei personenbezogenen Daten sind DSGVO-Vorgaben zu beachten: Datenminimierung, Zweckbindung, Zugriffskontrolle und Löschkonzepte. Ein Agent darf nicht mehr sehen, als für seine Aufgabe nötig ist, und seine Aktivität muss auditierbar sein.
Qualitätssicherung: Wie Du Deinen KI-Agenten testen und absichern kannst
Testfälle, Benchmarks und Validierung von Kennzahlen
Für Agenten brauchst Du strukturierte Testsets, ähnlich wie für klassische Software. Lege typische und kritische Fragen fest, formuliere erwartete Antworten und prüfe regelmäßig, ob der Agent sie korrekt liefert. Änderungen an Prompts, Modellen oder Datenquellen sollten immer durch diese Tests laufen.
Zusätzlich können automatisierte Validierungen helfen: Der Agent vergleicht seine Ergebnisse mit Referenzkennzahlen aus etablierten Reports oder führt Rechenprüfungen durch (z. B. Summe der Regionen = Gesamtwert). So erkennst Du Regressionsfehler frühzeitig.
Monitoring, Logging und Feedbackschleifen
Neben Funktionstests brauchst Du ein laufendes Monitoring. Das umfasst Nutzungsstatistiken, Antwortzeiten, Fehlerraten, abgebrochene Anfragen und Kosten. Diese Informationen helfen Dir, Engpässe und Fehlkonfigurationen schnell zu erkennen.
Ergänze das durch einfache Feedbackmöglichkeiten für Nutzer, etwa eine Bewertung oder Kommentarfunktion direkt in der Antwort. So sammelst Du qualitative Hinweise, wo der Agent Mehrwert schafft und wo er noch nachjustiert werden muss.
Risikomanagement im Licht von DSGVO und EU AI Act
Der AI Act verlangt – je nach Risikoklasse – Risikobewertungen, Transparenz und menschliche Aufsicht. Für Analyse-Agenten bedeutet das insbesondere, dass ihre Rolle im Entscheidungsprozess klar sein muss: Unterstützt der Agent nur, oder trifft er autonome Entscheidungen mit Außenwirkung?
In der Praxis ist es sinnvoll, Agenten zunächst im „Assistenzmodus“ zu betreiben: Sie liefern Vorschläge, die immer von Menschen geprüft werden. Erst wenn Prozesse, Daten und Governance stabil sind, kannst Du schrittweise mehr Autonomie zulassen.
Change Management: Nutzer einbinden, Vertrauen aufbauen
Ein gut gebauter Agent nützt wenig, wenn ihn niemand nutzt. Nimm Fachbereiche früh in die Konzeption auf, erkläre Grenzen und Stärken offen und schaffe niedrige Einstiegshürden, etwa durch kurze Schulungen und begleitete Pilotphasen.
Wichtig ist, dass Nutzer nicht das Gefühl haben, der Agent nehme ihnen die Kontrolle, sondern dass er sie entlastet. Klare Regeln, wann menschliche Entscheidungen Vorrang haben und wie Fehler korrigiert werden, schaffen Vertrauen.
Eigenbau vs. Plattform: Wann lohnt es sich, KI-Agenten selbst zu erstellen?
Typische Szenarien, in denen DIY sinnvoll ist
Ein selbstgebauter KI-Agent lohnt sich vor allem, wenn Du klar abgegrenzte, nicht geschäftskritische Use Cases hast, eine solide Datenbasis bereits existiert und im Team mindestens ein bis zwei Personen dauerhaft Zeit für Betrieb und Weiterentwicklung investieren können. Beispiele sind interne Analysehelfer für einzelne Teams oder Pilotprojekte zur Abweichungsanalyse.
Auch wenn Dein Hauptziel Lerngewinn ist – also Kompetenzen im Umgang mit KI und Daten aufzubauen – kann ein DIY-Ansatz sinnvoll sein. Wichtig ist, diese Projekte bewusst als Lern- oder Prototypingvorhaben zu labeln und sie nicht ungeplant in die produktive Steuerung „hineinwachsen“ zu lassen.
Wann eine professionelle Plattform für KI-Datenanalyse die bessere Wahl ist
Wenn es um unternehmensweite Steuerungskennzahlen, viele heterogene Quellen, sensible Daten oder knappe interne Ressourcen geht, stoßen selbstgebaute Agenten schnell an Grenzen. Hier ist eine Plattform vorteilhaft, die Datenintegration, Modellierung, Automatisierung und Kontextanreicherung bereits gelöst hat.
Gerade wenn Du innerhalb von wenigen Wochen verlässliche, managementtaugliche Ergebnisse brauchst und kein eigenes Data-Team aufbauen möchtest, reduziert eine spezialisierte Plattform Risiko und Time-to-Value deutlich. Du kaufst dann nicht „nur“ ein Tool, sondern einen betriebenen Daten- und KI-Service.
Vergleich: Kosten, Zeit bis zum Ergebnis, Risiko, Wartung
| Aspekt | Eigenbau KI-Agent | Plattform wie bimanu One |
|---|---|---|
| Initiale Kosten | Geringe Lizenzkosten, aber interner Aufwand für Entwicklung und Setup. | Planbares Paket, Einstieg höher als Experiment, aber inkl. Betrieb und Know-how. |
| Time-to-Value | Schnelle Prototypen, produktive Reife dauert oft länger als geplant. | Erste belastbare Antworten ab wenigen Wochen, mit definiertem Scope. |
| Risiko & Compliance | Stark abhängig von internem Know-how; Gefahr von Schatten-IT. | Architektur, Sicherheit und Auditierbarkeit sind Teil des Angebots. |
| Wartung & Weiterentwicklung | Abhängig von einzelnen Personen; technische Schulden drohen. | Geregelter Betrieb als Service; Updates und Optimierungen integriert. |
| Skalierung | Jeder neue Use Case erfordert zusätzliche Entwicklungsarbeit. | Neue Use Cases nutzen bestehendes Daten- und Kontextfundament mit. |
Checkliste: Passt ein selbstgebauter Agent zu Deiner Situation?
Ein DIY-Ansatz ist realistisch, wenn Du bereits ein zentrales Data Warehouse oder vergleichbares Datenfundament hast, Dein Use Case klar definiert und nicht hochreguliert ist und im Team Kapazitäten für Entwicklung, Tests und Betrieb eingeplant sind. Außerdem solltest Du bereit sein, Struktur in Prompts, Workflows und Dokumentation zu bringen.
Wenn mehrere dieser Punkte nicht erfüllt sind, ist die Wahrscheinlichkeit hoch, dass ein selbstgebauter Agent kurzfristig beeindruckt, aber mittelfristig zum Wartungsproblem wird. In diesem Fall ist ein Pilot mit einer etablierten Plattform meist die nachhaltigere Option.
bimanu One als Fundament und Alternative zum selbstgebauten KI-Agenten
Zentrales Datenfundament: Automatisiertes Data Warehouse mit Unternehmenskontext
bimanu One adressiert genau den Engpass, an dem viele Eigenbau-Agenten scheitern: die Datenbasis. Die Plattform integriert Daten aus ERP, CRM, MES, IoT und weiteren Quellen in ein automatisiertes Data Warehouse und ergänzt sie um Deinen fachlichen Kontext – also Kennzahlendefinitionen, Beziehungen und Governance-Regeln.
Damit entsteht ein „Single Point of Truth“, auf den klassische BI, KI-Analysen und auch eventuelle eigene Agenten zugreifen können. Du musst Dich nicht mehr darum kümmern, wie Du Daten zusammenführst, bereinigst und versionierst – das leistet die Plattform.
Fertige Analyse- und Entscheidungsschicht statt einzelner Agent-Skripte
Anstatt einen einzelnen Agenten um Deine Daten herumzubauen, bietet bimanu One eine fertige Analyse- und Entscheidungsschicht. Nutzer müssen morgens nicht durch zehn Dashboards klicken, sondern erhalten verdichtete Hinweise und Handlungsempfehlungen in natürlicher Sprache.
Die Plattform zeigt, welche Abweichungen relevant sind, welche Ursachen wahrscheinlich sind und welche Optionen es gibt – basierend auf Deinem Datenmodell und Deinen Geschäftsregeln. Damit übernimmt bimanu One viele Aufgaben, für die Unternehmen heute erst mühsam eigene Agenten entwickeln wollen.
Prognosen, Anomalieerkennung und Ursachenanalyse mit bimanu Intelligence
Über das Modul bimanu Intelligence nutzt die Plattform Machine-Learning-Verfahren für Prognosen, Anomalieerkennung und Ursachenanalysen. Diese Modelle werden auf Deinen harmonisierten Daten betrieben und liefern Ergebnisse, die in die Kontext-Engine eingebettet sind.
Für Dich bedeutet das: Statt selbst ML-Pipelines aufzubauen, zu betreiben und in Agenten-Workflows zu integrieren, bekommst Du diese Funktionalitäten als Modul der Plattform. Das verringert Komplexität und verkürzt die Zeit bis zu verwertbaren Ergebnissen.
Freie Modellwahl: LLMs wie Claude sicher und DSGVO-konform nutzen
bimanu One ermöglicht die Nutzung unterschiedlicher LLMs wie Claude, ohne dass Deine Daten das kontrollierte Umfeld verlassen. Die Architektur basiert auf Snowflake Cortex AI: Deine Daten bleiben in Deinem Snowflake-Konto, werden nicht zum Training von Modellen verwendet und sind durch ISO-27001-zertifizierte Prozesse geschützt.
So kannst Du moderne generative KI für Analysen und Erklärungen nutzen, ohne selbst Integrations- und Sicherheitskonzepte auf Modell-Ebene entwerfen zu müssen. Die Plattform stellt sicher, dass Anfragen und Antworten in Deinem Compliance-Rahmen bleiben.
Alles in einer Plattform: BI, ML, Contextual Intelligence ohne Toolkette
Während Eigenbau-Ansätze oft aus einer Kette einzelner Tools bestehen – ETL, Data Warehouse, BI, Agenten-Framework, Monitoring – bündelt bimanu One diese Funktionen in einer integrierten Plattform. Datenintegration, Modellierung, Automatisierung, Visualisierung und Kontext-Engine greifen nahtlos ineinander.
Das reduziert Schnittstellenrisiken, Abstimmungsaufwände und die Notwendigkeit, mehrere Spezialteams aufzubauen. Fachbereiche und IT arbeiten auf derselben Plattform, mit klaren Rollen und reproduzierbaren Prozessen.
Datenschutz, Datenhoheit und AI-Act-Konformität in der Praxis
Durch das Hosting auf Snowflake in der EU, die ISO-27001-Zertifizierung und das „Software made in Germany“-Siegel erfüllt bimanu One hohe Sicherheits- und Compliance-Standards. Daten bleiben unter Deiner Hoheit, werden nicht für fremde Zwecke genutzt und ihre Verarbeitung ist nachvollziehbar dokumentiert.
Damit hast Du eine solide Basis, um Anforderungen aus DSGVO und AI Act pragmatisch zu erfüllen. Transparente Datenflüsse, Audit-Trails und klare Verantwortlichkeiten sind im Plattformdesign angelegt, nicht nachträglich angestückelt.
Planbare Kosten und schneller Start ohne eigenes Data-Team
Ein wesentlicher Unterschied zum Eigenbau liegt im Betriebsmodell: bimanu One wird als Managed Service bereitgestellt. Du brauchst kein eigenes Data-Team, um Pipelines zu warten, Modelle zu aktualisieren oder Systemverfügbarkeit sicherzustellen – das übernimmt das bimanu-Team.
Die Kosten sind über Paketpreise planbar, und erste belastbare Ergebnisse stehen typischerweise ab Woche 5 zur Verfügung. Das reduziert Risiko und Budgetunsicherheit im Vergleich zu offenen Entwicklungsprojekten mit unklarer Laufzeit.

Praxisleitfaden für den Mittelstand: In 4 Schritten zur fundierten Entscheidung
1. Use Cases priorisieren: Wo ein KI-Agent wirklich Mehrwert stiftet
Sammle zunächst alle Ideen für KI-Agenten und bewerte sie entlang dreier Achsen: erwarteter Nutzen, Datenverfügbarkeit und Risiko. Starte mit Use Cases, die klar abgegrenzt, datenseitig gut versorgt und nicht hochsensibel sind – etwa interne Abweichungsanalysen oder Datenqualitätschecks.
Halte dabei fest, welche Kennzahlen betroffen sind, welche Nutzergruppen profitieren und wie Erfolg gemessen werden soll. So verhinderst Du, dass Projekte aus reiner Technologiebegeisterung entstehen, ohne echten Business-Mehrwert.
2. Datenlage und Systemlandschaft ehrlich bewerten
Im zweiten Schritt prüfst Du nüchtern, wie Deine Datenlandschaft heute aussieht. Gibt es ein zentrales Data Warehouse oder zumindest harmonisierte Datamarts, oder dominieren Exporte, manuelle Mappings und Excel? Welche Systeme sind kritisch, welche können später angebunden werden?
Diese Bestandsaufnahme entscheidet darüber, ob ein Eigenbau-Agent kurzfristig tragfähig ist oder ob zuerst am Fundament gearbeitet werden muss. Sie liefert auch Ansatzpunkte, ob eine Plattform wie bimanu One die nötige Integrationsarbeit deutlich abkürzen kann.
3. DIY-Prototyp vs. Plattform-Pilot: den richtigen Einstieg wählen
Auf Basis von Use-Case-Priorisierung und Datenlage kannst Du gezielt entscheiden: Wo lohnt sich ein DIY-Prototyp, um Erfahrungen zu sammeln, und wo ist ein Plattform-Pilot sinnvoller, um schnell zu belastbaren Ergebnissen zu kommen? Beide Wege schließen sich nicht aus, sie können sich ergänzen.
Ein pragmatischer Ansatz ist, einen kleinen, risikoarmen Use Case als Eigenbau zu testen und gleichzeitig mit einer Plattform einen Pilot in einem strategisch wichtigen Bereich zu starten. So gewinnst Du Technologiekompetenz und hast dennoch ein stabiles Rückgrat für zentrale Kennzahlen.
4. Nächste Schritte mit bimanu One planen
Wenn Du erkennst, dass Dein größter Engpass im Datenfundament liegt und Du KI-Agenten eher als Interface auf eine verlässliche Datenplattform siehst, ist bimanu One ein sinnvoller nächster Schritt. In einem Erstgespräch lassen sich Deine Systemlandschaft, Prioritäten und Zeitvorgaben durchgehen.
Auf dieser Basis entsteht ein Fahrplan, wie Datenintegration, Data Warehouse, BI und KI-Analysen in wenigen Wochen produktiv nutzbar werden – inklusive der Option, später eigene Agenten sicher auf dieser Basis aufzusetzen, statt sie ins Leere laufen zu lassen.
KI-Agenten erstellen – Häufige Fragen und Antworten
Was kostet es, einen KI-Agenten für Datenanalyse zu erstellen?
Die Kosten hängen stark von Ansatz und Umfang ab. Ein einfacher Eigenbau-Prototyp auf Basis bestehender LLM-APIs und Low-Code-Workflows kann mit wenigen Tausend Euro interner Zeit und geringen Lizenzkosten realisiert werden, ist aber noch kein produktives System. Für einen stabilen, auditierbaren Agenten musst Du zusätzlich in Datenfundament, Tests, Monitoring und Wartung investieren – häufig über Monate hinweg.
Kann ich mit ChatGPT oder Claude selbst einen KI-Agenten erstellen?
Ja, viele Anbieter wie ChatGPT oder Claude bieten heute Funktionen, um agentenartige Assistenten zu konfigurieren und mit Tools zu verbinden. Damit kannst Du einfache Prototypen bauen, die etwa auf eine Datenbank zugreifen oder Standardreports erstellen. Für produktive Szenarien brauchst Du jedoch ergänzend eine saubere Datenarchitektur, Rechtekonzepte und eigenständige Orchestrierung außerhalb der reinen Chat-Oberfläche.
Welches Tool ist am besten geeignet, um KI-Agenten zu erstellen?
„Das beste Tool“ gibt es nicht pauschal, entscheidend sind Deine Rahmenbedingungen. Für schnelle Experimente sind No-Code-Plattformen und integrierte Agenten-Features in LLM-Tools hilfreich, für komplexe Unternehmensszenarien sind Enterprise-Plattformen oder integrierte Lösungen wie bimanu One geeigneter, weil sie Datenfundament und Governance mitliefern. Wichtig ist, dass sich die Lösung gut in Deine bestehende IT- und BI-Landschaft einfügt und regulatorisch tragfähig ist.
Kann ich KI-Agenten ohne Programmierung erstellen?
Du kannst heute viele Schritte – vom Prompt-Design über einfache Workflows bis hin zu Basis-Reports – ohne klassischen Code umsetzen. Für ernsthafte Produktivsysteme kommst Du aber kaum ohne technische Expertise aus, etwa für Datenbankzugriffe, Sicherheitsarchitektur oder Integration in bestehende Systeme. Ein sinnvolles Modell ist, dass Fachbereiche Use Cases und Inhalte treiben, während IT/BI die technische Umsetzung und Absicherung verantworten.
Wie kann ich einen KI-Agenten mit meinen internen Unternehmensdaten verbinden?
Technisch erfolgt die Anbindung meist über ein Data Warehouse oder eine zentrale Datenplattform, auf die der Agent via Datenbankverbindung oder API zugreift. Du definierst dort Views oder Tabellen mit den relevanten Kennzahlen und Dimensionen und gibst dem Agenten nur Leserechte auf diese Schicht. Direktzugriffe auf ERP oder CRM solltest Du vermeiden, weil sie schwerer abzusichern und zu testen sind als ein zentraler, harmonisierter Datenraum.
Wie teste und überwache ich, ob mein KI-Agent verlässliche Kennzahlen liefert?
Lege dafür Referenzfälle fest: typische Fragestellungen mit bekannten, manuell verifizierten Antworten, gegen die Du den Agenten regelmäßig laufen lässt. Ergänzend richtest Du automatisierte Plausibilitätsprüfungen ein, etwa Summen- und Durchschnittsvergleiche oder Abgleich mit etablierten Reports. Ein Monitoring für Fehlerraten, Antwortzeiten und Nutzerfeedback hilft Dir, Probleme früh zu erkennen und gezielt zu beheben.
Wie kann man mit KI-Agenten im Unternehmen konkret Geld verdienen?
Der wirtschaftliche Hebel entsteht weniger durch den direkten Verkauf eines Agenten, sondern durch Effizienzgewinne und bessere Entscheidungen. Beispiele sind schnellere Monatsabschlüsse, reduzierte Stillstandzeiten durch bessere Ursachenanalyse, optimierte Einkaufskonditionen oder präzisere Vertriebsprognosen. Diese Effekte kannst Du messen, indem Du Vorher-Nachher-Vergleiche bei Durchlaufzeiten, Fehlerraten oder Materialkosten anstellst.
Für welche Use Cases lohnt sich ein selbstgebauter KI-Agent – und wann sollte ich eine Plattform wie bimanu One nutzen?
Ein selbstgebauter Agent lohnt sich für klar begrenzte, nicht hochkritische Aufgaben mit überschaubarem Datenraum, etwa als Analysehilfe für ein einzelnes Team oder als Experiment. Sobald es um unternehmensweite Kennzahlen, viele Datenquellen, hohe Regulatorik oder fehlende interne Kapazitäten geht, ist eine Plattform wie bimanu One sinnvoller, weil sie Datenintegration, Modellierung, BI und KI bereits fertig integriert bereitstellt.
Sind KI-Agenten mit DSGVO und EU AI Act vereinbar?
Ja, wenn sie mit Blick auf Datenschutz und Governance sauber konzipiert werden. Das bedeutet insbesondere: klare Zweckbindung der Daten, Minimierung von personenbezogenen Informationen, transparente Dokumentation der Datenflüsse und menschliche Aufsicht bei kritischen Entscheidungen. Plattformen wie bimanu One, die auf EU-konformer Infrastruktur und zertifizierten Prozessen basieren, erleichtern Dir die Erfüllung dieser Anforderungen erheblich.
Was passiert, wenn die Person, die unseren KI-Agenten gebaut hat, das Unternehmen verlässt?
Wenn Dein Agent stark von einer einzelnen Person abhängt und kaum dokumentiert ist, entsteht ein erhebliches Betriebsrisiko. Im schlimmsten Fall kann das System nach Änderungen an Datenquellen oder Modellen nicht mehr gewartet werden und muss neu aufgebaut werden. Deshalb solltest Du von Anfang an auf Dokumentation, gemeinsame Code- oder Workflow-Repositories, klare Ownership und – wo sinnvoll – auf eine Plattform setzen, die Betrieb und Weiterentwicklung institutionell absichert.