
Data Vault ist nicht nur eine Modellierungstechnik, sondern eine wegweisende Methode, die eine neue Ära in der Arbeit mit Data Warehouses eingeleitet hat. In einer Zeit, in der Unternehmen von Tag zu Tag mit immer größer werdenden Datenmengen konfrontiert werden, spielt Data Vault eine entscheidende Rolle. Es verwandelt komplexe Datenlandschaften in strukturierte, leicht navigierbare Informationsspeicher.
Die Herausforderungen, vor denen Unternehmen heute stehen, sind enorm. Die exponentielle Zunahme der Datenmenge, kombiniert mit der ständigen Nachfrage nach tieferen und gründlicheren Analysen, stellt Unternehmen oft vor scheinbar unüberwindbare Hindernisse. Aber hier kommt diese Art der Modellierung ins Spiel. Sie ist wie ein leistungsstarker, aber sanfter Riese, der bereit ist, diese Herausforderungen mit Ihnen anzugehen und Ihnen dabei zu helfen, die Datenflut zu meistern.
Warum sollte Ihr Unternehmen ein Interesse an Data Vault haben? Nun, diese Technologie bringt eine Vielzahl von Vorteilen mit sich, die weit über die reine Datenverwaltung hinausgehen. Sie ermöglicht eine schnellere Entscheidungsfindung, verbessert die Datensicherheit und ermöglicht es Ihrem Unternehmen, auf Veränderungen in der Geschäftsumgebung schnell und flexibel zu reagieren.
In diesem Beitrag tauchen wir gemeinsam tiefer in die Welt von Data Vault ein. Wir werden die Gründe aufdecken, warum diese Modellierungstechnik zunehmend in den Mittelpunkt der Aufmerksamkeit rückt und warum sie möglicherweise das fehlende Puzzleteil in deinem Unternehmensdatenpuzzle ist. Tauche mit uns in diese faszinierende Welt ein und entdecke, wie du die Kontrolle über deine Daten zurückgewinnen kannst.
Was ist Data Vault?
Data Vault ist ein Modellierungsansatz, zum Aufbau von Business Intelligence Plattformen bzw. im Data Warehousing eingesetzt wird. Wir zeigen dir im Video, warum Data Vault so ein starkes Werkzeug in deinem BI-Toolkit sein sollte. Von der Art und Weise, wie es dir hilft, deine Daten effizienter und zielgerichteter zu managen, bis hin zu den konkreten Schritten, wie du es implementieren kannst, um deine Datenstrategie zu stärken.
Die Herkunft und das Prinzip von Data Vault
Data Vault wurde in den 1990er Jahren von Dan Linstedt entwickelt, einem Pionier auf dem Gebiet der Data Warehousing und Business Intelligence. Linstedt entwickelte den Data Vault-Ansatz, um den Herausforderungen des herkömmlichen Data Warehouse-Designs zu begegnen, das Schwierigkeiten hatte, sich an die dynamische Natur von Geschäftsprozessen und -anforderungen anzupassen.
Das Grundprinzip von Data Vault basiert auf der Idee, dass Information ein Asset ist, das über die Zeit erhalten und nachverfolgt werden muss. Dieses Prinzip führt zu dem einzigartigen Design von Data Vault, bei dem Hubs, Links und Satellites verwendet werden, um Geschäftsobjekte, ihre Beziehungen und historischen Daten zu modellieren.
Schauen wir uns kurz die Hubs, Links und Satellites genauer an:
- Hubs repräsentieren Geschäftsobjekte, wie Kunden, Produkte oder Standorte.
- Links stehen für die Beziehungen zwischen diesen Geschäftsobjekten.
- Satellites speichern die historischen und beschreibenden Daten, die mit den Hubs und Links verbunden sind.
Dieser Ansatz bietet eine hohe Flexibilität und Skalierbarkeit, was es Unternehmen ermöglicht, sich an Veränderungen in den Geschäftsanforderungen anzupassen und gleichzeitig die Datenintegrität zu wahren. Im Zentrum des Data Vault-Modells steht die Fähigkeit, sowohl strukturelle als auch inhaltliche Änderungen zu verfolgen, was es zu einer idealen Lösung für dynamische Geschäftsumgebungen macht.
Warum Data Vault in der heutigen Datenlandschaft relevant ist
In einer Zeit, in der Daten in unglaublichem Tempo generiert und gesammelt werden, spielt Data Vault eine zunehmend wichtige Rolle in der Datenlandschaft. Durch die explosionsartige Zunahme von Datenquellen und die wachsende Komplexität von Geschäftsprozessen sind flexible und robuste Datenmodellierungstechniken wie Data Vault unerlässlich geworden.
Einer der Hauptvorteile besteht darin, dass es Änderungen an Geschäftsregeln und Datenquellen problemlos aufnehmen kann, ohne dass das gesamte Modell überarbeitet werden muss. Dies bedeutet, dass Unternehmen ihr Data Warehouse agil anpassen und verbessern können, ohne die bestehende Datenstruktur zu stören. Die Data Warehouse Software von bimanu kann dabei behilflich sein.
Darüber hinaus ermöglicht die Historisierung von Daten in Data Vault den Unternehmen, eine vollständige Chronik der Geschäftsaktivitäten zu erstellen. Dies ist besonders wertvoll in der heutigen Geschäftswelt, in der Entscheidungsträger oft einen tiefen Einblick in historische Daten benötigen, um fundierte Geschäftsentscheidungen zu treffen.
Zudem ist diese Datenmodellierungsmethode durch seine parallele Laden- und Verarbeitungsfähigkeit sehr gut für moderne, leistungsfähige Data Warehouse-Lösungen geeignet. Dadurch ist es in der Lage, große Datenmengen effizient zu verarbeiten und Unternehmen bei der Nutzung ihrer Daten zu unterstützen.
Kurz gesagt, Data Vault ist aufgrund seiner Flexibilität, Skalierbarkeit und der Fähigkeit, eine vollständige Historie der Daten zu bewahren, besonders relevant in der heutigen sich schnell verändernden und datenintensiven Geschäftswelt.
Data Vault 2.0
Data Vault 2.0 ist eine Weiterentwicklung des ursprünglichen Data Vault-Modells, die eine verbesserte Methodik, Prozessoptimierung und agile Projektmanagementtechniken einführt, um die Effizienz zu steigern und die Einhaltung von Compliance- und Governance-Anforderungen in der modernen Datenlandschaft zu gewährleisten.
Unterschied zwischen Data Vault 1.0 und Data Vault 2.0
Data Vault 1.0 und 2.0 sind beide Modellierungsmethoden für Data Warehouses, die von Dan Linstedt entwickelt wurden. Beide Ansätze verwenden die Konzepte von Hubs, Links und Satellites zur Darstellung von Geschäftsobjekten, ihren Beziehungen und zugehörigen Daten. Trotz ihrer Ähnlichkeiten gibt es jedoch einige wichtige Unterschiede zwischen Data Vault 1.0 und 2.0.
Zeigen wir doch die Kernelemente auf:
- Methodik und Anwendungsbereich: Während die Version 1.0 hauptsächlich ein Datenmodellierungsstandard war, erweitert die Version 2.0 die Methode zu einer vollständigen Systemarchitektur. Data Vault 2.0 beinhaltet Richtlinien für Datenintegration, Geschäftsprozessmodellierung, Governance, Sicherheit und andere Aspekte des Data Warehouse-Systems, die in Data Vault 1.0 nicht ausdrücklich behandelt wurden.
- Hash-Schlüssel: Data Vault 2.0 führt die Verwendung von Hash-Schlüsseln als einheitliche, systemübergreifende Schlüssel für Hubs und Links ein. Dies verbessert die Datenverarbeitungsleistung und unterstützt die parallele Verarbeitung und das Laden von Daten.
- Zeitstempel: Data Vault 2.0 stellt klarere Anforderungen an die Verwendung von Zeitstempeln zur Nachverfolgung der Historie von Daten.
- Agile Entwicklung: Data Vault 2.0 legt einen stärkeren Fokus auf agile Entwicklungsmethoden und fördert iteratives, inkrementelles Design und Entwicklung von Data Warehouses.
- Big Data und NoSQL-Unterstützung: Data Vault 2.0 berücksichtigt auch die Herausforderungen und Chancen von Big Data und nicht-relationalen Datenquellen, die in Data Vault 1.0 noch nicht so relevant waren.
- Bessere Unterstützung für Geschäftsregeln: Data Vault 2.0 bietet verbesserte Möglichkeiten zur Implementierung und Änderung von Geschäftsregeln, was die Flexibilität und Anpassungsfähigkeit des Systems erhöht.
- Systemarchitektur: Im Gegensatz zu Data Vault 1.0, welches hauptsächlich ein Datenmodellierungsstandard war, stellt Data Vault 2.0 eine vollständige Systemarchitektur dar, inklusive Richtlinien für Datenintegration, Geschäftsprozessmodellierung, Governance und Sicherheit.
Zusammenfassend ist Data Vault 2.0 eine Weiterentwicklung von Data Vault 1.0, die neue Praktiken und Techniken einführt, um mit der Entwicklung der Datenlandschaft Schritt zu halten und ein noch effizienteres und anpassungsfähigeres Data Warehouse zu ermöglichen.
Ausgangslage: Die Anforderungen an das Data Warehouse steigen
Die Anforderungen an das Data Warehouse sind heutzutage nicht mehr nur gestiegen, sie haben eine neue Dimension erreicht. Unternehmen, die sich eine agilere Datenarchitektur wünschen, setzen auf Data Vault Modellierung. Diese innovative Technik transformiert Data Warehouses, die zentrale Datenbanksysteme sind, von bloßen Datenaggregatoren zu leistungsstarken Analysemaschinen.
Big Data ist kein Trend mehr, sondern eine Realität. Die Herausforderungen, die sich daraus ergeben, sind beträchtlich, und genau hier kommt die Data Vault Modellierung ins Spiel. Sie hilft Unternehmen, den Big Data-Tsunami zu kontrollieren und wertvolle Erkenntnisse aus den Datenfluten zu gewinnen.
Insgesamt ist das Data Warehousing in die folgenden vier Teilprozesse untergliedert:
- Datenbeschaffung
- Datenhaltung
- Datenversorgung
- Datenauswertung
Die Data Vault Modellierung richtet sich an Unternehmen, die ein solches Data Warehouse mit seinen jeweiligen Teilfunktionen bereits einsetzen und insbesondere in den Bereichen Datenhaltung und Datenauswertung für moderne Analytics-Anforderungen besser aufgestellt sein möchten.
In den letzten Jahren hat der Druck auf die Nutzer von Data Warehouses zugenommen. Systeme müssen ständig angepasst und optimiert werden, um mit der Zunahme von Daten und der steigenden Komplexität der Analysen Schritt zu halten. Traditionelle Data Warehouse Ansätze kommen an ihre Grenzen und die Kosten steigen exponentiell an. Hier eröffnet die Data Vault Modellierung eine neue Perspektive und bietet Unternehmen alternative Konzepte, um mit diesen Herausforderungen umzugehen. Es ist mehr als nur eine Modellierungstechnik – es ist eine Lösung, die den Weg zu einem effizienteren und effektiveren Data Warehouse ebnet.
Was ist ein Datawarehouse? – Kurzer Exkurs
Wie ist die Modellierung aufgebaut?
Die drei Schichten der Modellierung
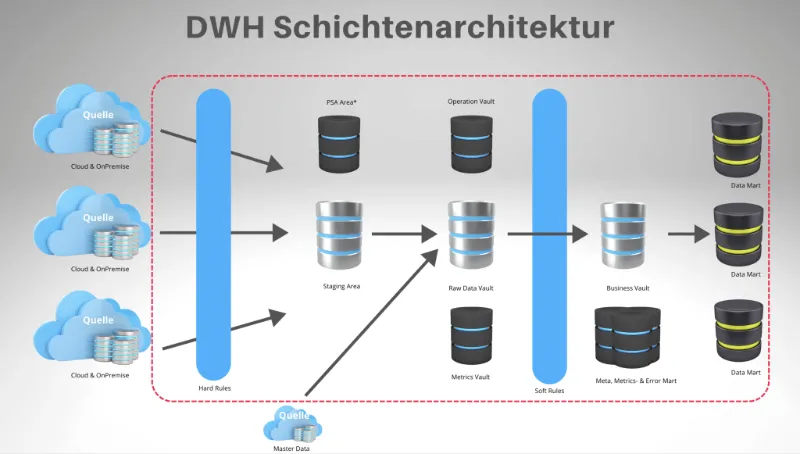
Der Staging Layer fungiert als Initialisierungsphase im Data Vault Modell und stellt die Schnittstelle zu den heterogenen Datenquellen dar. In diesem Prozess werden vielfältige Datenströme konsolidiert und harmonisiert, um eine Basis für die fortlaufende Datenintegration zu schaffen. Dieser Schritt ist von entscheidender Bedeutung, da er die Datenqualität sichert und die Daten auf eine geeignete Form für die nachfolgenden Transformations- und Modellierungsprozesse vorbereitet.
Im Zentrum des Data Vault Modells befindet sich der Data Warehouse Layer. In diesem Layer wird zunächst das Raw Vault Modell implementiert, das aus Hubs, Links und Satellites besteht. Diese Architektur ermöglicht eine flexible und skalierbare Datenspeicherung, die Anpassungen an veränderte Geschäftsanforderungen ermöglicht und gleichzeitig eine konsistente Darstellung der Daten über die Zeit beibehält. Das Modell legt den Grundstein für eine robuste Dateninfrastruktur, die sowohl historische als auch aktuelle Daten in einer effizienten und nachvollziehbaren Weise speichert. Alle fachliche Überführungen oder Berechnungen werden im Business Vault gebildet.
Der Information Mart Layer (basierend auf dem Business Vault) ist der finale Schritt in der dieser DWH-Architektur, in dem die Daten für den Endbenutzer aufbereitet und bereitgestellt werden. Hier werden die Daten in einer benutzerfreundlichen Form, wie zum Beispiel einem Sternschema, modelliert, das für den Benutzer intuitiv verständlich ist und es ihm ermöglicht, ad-hoc Berichte zu erstellen und datengestützte Analysen durchzuführen. Dieser Layer stellt sicher, dass die Daten in einer zugänglichen und einsatzbereiten Form bereitgestellt werden, die für datengetriebene Entscheidungsfindung und fortgeschrittene Analytik unerlässlich ist.
Die Data Vault Methode
Zunächst haben wir die Hubs. Sie sind das Fundament des Modells und beinhalten die Primärschlüssel oder Business Keys, die zur Identifizierung von Hauptgeschäftselementen wie Kunden, Produkten oder Verkäufern dienen. Beachten Sie, dass Hubs ausschließlich Identifikationsinformationen enthalten und keine beschreibenden Informationen speichern.
Dann kommen die Links ins Spiel. Sie repräsentieren die Fremdschlüssel, die Beziehungen zwischen den verschiedenen Business Keys oder Hubs herstellen. Ihre Hauptaufgabe ist es, die Verbindungen und Interaktionen zwischen verschiedenen Geschäftselementen zu modellieren. Durch ihre Flexibilität können sie sich schnell an Änderungen in der Geschäftslogik anpassen, was sie zu einem entscheidenden Bestandteil der Modellierung macht.
Schließlich sind da die Satelliten. Sie enthalten die fachlichen Felder oder beschreibenden Informationen, die Kontext und zusätzliche Details zu den Business Keys liefern. Ein Satellit ist an einen bestimmten Schlüssel gebunden, aber mehrere Satelliten können einen einzelnen Schlüssel beschreiben, um eine reiche und vielschichtige Darstellung der Geschäftsinformationen zu ermöglichen.
Durch die Kombination dieser drei Elemente bietet die Data Vault Modellierung ein robustes und flexibles Modell, das in der Lage ist, die Komplexität der Geschäftsinformationen eines Unternehmens effizient zu handhaben.

Welche Vorteile bietet die Data Vault Modellierung?
Data Vault Modellierung bringt eine Vielzahl von Vorteilen mit sich, die sie zu einer attraktiven Technologie für Unternehmen machen, welche eine effiziente und flexible Handhabung ihrer Data Warehouses benötigen.
Einer der Schlüsselvorteile von Data Vault ist die verbesserte Time-to-Market. Durch die Reduzierung der Entwicklungszeiten können Geschäftsanforderungen schneller umgesetzt werden. Dies ist besonders wertvoll für Unternehmen mit hohem Datenaufkommen, die eine effiziente Lösung für ihre Datenverwaltung benötigen.
Darüber hinaus ist Data Vault in der Lage, Ihr Data Warehouse zu skalieren. Dies bedeutet, dass das System wachsen und sich an das steigende Datenaufkommen anpassen kann, ohne dass die Leistung beeinträchtigt wird.
Es werden auch technische Vorteile mitgebracht, einschließlich der Unterstützung für klassische Batch-Verarbeitung. Darüber hinaus bietet es die Möglichkeit, NoSQL-Datenbanken anzubinden, was besonders nützlich ist, wenn Sie mit unstrukturierten Daten arbeiten.
Schließlich macht Data Vault die Umsetzung einfach und erfordert kein Neuaufsetzen der Architektur. Dies ermöglicht eine nahtlose Integration in Ihre bestehenden Systeme und Prozesse, was den Übergang zu dieser Modellierungstechnik erleichtert.
Zusammengefasst ergeben sich folg. Vorteile:
- Verbesserte Time-to-Market: Durch kürzere Entwicklungszeiten können Geschäftsanforderungen schneller umgesetzt werden.
- Skalierbarkeit: Das System kann mit steigendem Datenaufkommen wachsen und sich anpassen, ohne dass die Leistung beeinträchtigt wird.
- Technische Flexibilität: Unterstützt sowohl klassische Batch-Verarbeitung als auch die Anbindung von NoSQL-Datenbanken, was besonders nützlich ist für den Umgang mit unstrukturierten Daten.
- Einfache Implementierung: Kein Neuaufsetzen der Architektur notwendig, was eine nahtlose Integration in bestehende Systeme und Prozesse ermöglicht und den Übergang zur Data Vault-Modellierung erleichtert.
- Effizienz: Für Unternehmen mit hohem Datenaufkommen stellt Data Vault eine effiziente Lösung für ihre Datenverwaltung dar.
Data Vault vs. traditionelle Datenmodelle: Wer gewinnt?
In der Welt der Business Intelligence und Data Warehousing gibt es verschiedene Datenmodellierungsansätze, die je nach spezifischen Geschäftsanforderungen und technologischen Rahmenbedingungen ihre Stärken haben. In diesem Abschnitt betrachten wir die Unterschiede und Ähnlichkeiten zwischen den Modellierungsformen von Kimball (Star-Schemata), Inmon (Corporate Information Factory) und Data Vault.
| Modell | Vorteile | Nachteile |
|---|---|---|
| Kimball (Star-Schemata) |
|
|
| Inmon (Corporate Information Factory) |
|
|
| Data Vault |
|
|
Fazit bzw. unsere Meinung
Das Inmon Modell hat ausgedient, viel zu komplex und unflexibel in der Anwendung. Die meisten BI/DWH Projekte scheitern daran. Hier ist viel Know-How gefragt.
Unsere Meinung, die Kombination zwischen Data Vault und dem Kimbal Ansatz (Star Schema) ist der beste und praktmatische Ansatz. Wenn dieser Kombiniert wird mit einer LowCode Variante steht einem Analytics-Anforderungsfall innerhalb von 14 Tage nichts im Wege.
Hier wollt wissen, wie es geht? Dann schaut Euch einfach unsere kostenlose Gratis Business Intelligence Akademie an. Dort werden diese Konzepte sehr ausführlich erklärt.
Data Vault von der Theorie zur Praxis?
Kurze Pause? Dann haben wir was für Euch.
Wertgeschätzt – der #1 Business Intelligence Podcast
Graue Theorie ist das eine, aber wie führt man erfolgreich Business Intelligence Projekte ein? Das zeigen wir Euch an Culligan – Philipp Nowack, Finanzdirektor erklärt, wie wir gemeinsam eine erfolgreiche Business Intelligence Plattform eingeführt haben. Und dort ist die Data Vault Methode implementiert.
Viel Spass beim reinhören?
Was ist ein Data Vault Generator?
Ein Data Vault Generator ist ein leistungsstarkes Werkzeug, das den Prozess der Data Vault-Modellierung automatisiert. Diese Automatisierung bringt erhebliche Effizienzgewinne mit sich, da sie die manuellen Aufgaben der Modellierung von Data Vault-Schemas beseitigt, die oft zeitaufwendig und fehleranfällig sein können. Anstatt sich auf die Mikrodetails der Modellierung zu konzentrieren, können Sie sich mit einem Data Vault Generator auf die wichtigsten Aspekte Ihrer Daten konzentrieren und sicherstellen, dass Sie die besten Einblicke und Erkenntnisse aus Ihren Daten gewinnen.
Data Vault, eine etablierte Modellierungstechnik für Data Warehouses, integriert Daten aus verschiedenen und heterogenen Quellen in einem zentralen Data Warehouse. Es nutzt die Vorteile der Parallelisierung der Datenladeprozesse und bietet eine flexible und optimierte Umgebung für Datenanalysen. Ein Data Vault Generator automatisiert diesen Modellierungsprozess, indem er Quelldaten nimmt und ein optimiertes Data Vault-Modell erstellt.
In diesem Kontext möchten wir, als Softwarehaus, auf die wegweisenden Entwicklungen der bimanu Cloud Solutions GmbH aufmerksam machen. Wir nehmen in diesem Bereich eine führende Position ein. Bimanu bietet die innovative Plattform „bimanu cloud“ an, die auf einem Low-Code-Ansatz basiert und hochentwickelte automatisierte Datenintegration und -analyse ermöglicht.
Bei uns erhältst du alles aus einer Hand – nicht nur unsere Software, sondern auch den Betrieb als Managed Service, einschließlich unseres einzigartigen Coaching-Ansatzes für Bereiche wie Business Intelligence, Datenstrategie und datengetriebene Geschäftsmodelle.
Diese Plattform bietet ähnliche Funktionalitäten wie ein Data Vault Generator und ist äußerst effizient im Umgang mit Data Vault. Sie kann maßgeblich dazu beitragen, den Prozess der Data Vault-Modellierung zu optimieren. Darüber hinaus generieren wir ein zentrales Data Value Warehouse, das die verschiedenen Datensilos von kaufmännischen Datenbereichen bis hin zu Sensordaten aus der Produktion auflöst.
Mit der bimanu cloud kannst du die Vorteile dieser Datenmodellierungsmethode voll ausschöpfen, ohne dich in den technischen Details zu verlieren. Sie ermöglicht dir, den Fokus auf das Wesentliche zu legen – die Daten selbst und die wertvollen Erkenntnisse, die sie liefern können. Durch die Verbesserung der Geschwindigkeit und Genauigkeit deiner Datenmodellierung kann die bimanu cloud dazu beitragen, deine Datenanalysefähigkeiten zu verbessern und letztendlich fundiertere Geschäftsentscheidungen zu treffen. Das wichtigste am Schluss – es wird keine Business Intelligence Expertise benötigt!

Was ist mit dem Beladungsprozess-Prozess (ETL)
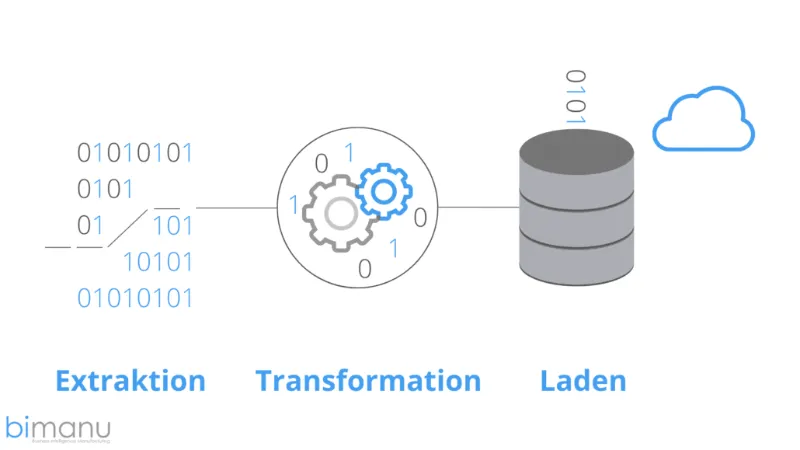
ETL steht für Extract, Transform, Load und beschreibt einen grundlegenden Prozess in der Datenverarbeitung, insbesondere in Bezug auf Data Warehouses und Data Vault.
- Extract: In dieser Phase werden Daten aus verschiedenen Quellen extrahiert. Diese Quellen können strukturierte Datenbanken, unstrukturierte Daten oder semi-strukturierte Daten sein.
- Transform: Hier werden die extrahierten Daten umgewandelt und gereinigt, um konsistente und qualitativ hochwertige Informationen sicherzustellen. Die Transformation kann verschiedene Formen annehmen, einschließlich der Normalisierung von Daten, dem Umgang mit fehlenden Werten oder der Kombination von Daten aus verschiedenen Quellen.
- Load: In der letzten Phase werden die transformierten Daten in das Data Warehouse oder in den Data Vault geladen. Dieser Schritt macht die Daten für Analysen und Berichterstattung zugänglich.
Der ETL-Prozess spielt eine zentrale Rolle im Data Vault. Beim Data Vault handelt es sich um eine Modellierungstechnik, die auf der Idee basiert, dass Daten aus verschiedenen Quellen in einem zentralisierten Data Warehouse gesammelt und gespeichert werden. Der ETL-Prozess ist die Methode, mit der diese Daten extrahiert, transformiert und geladen werden.
In Data Vault 2.0 wird der ETL-Prozess noch weiter verfeinert, indem Best Practices und detaillierte Anleitungen für den Datenladungsprozess bereitgestellt werden. Dies ermöglicht eine noch effizientere und effektivere Verarbeitung der Daten, was zu verbesserten Analysefähigkeiten und letztendlich zu fundierteren Geschäftsentscheidungen führt.
Data Vault – Revolution in der Datenspeicherung oder nur ein vorübergehender Trend?
Data Vault ist eine transformative Modellierungstechnik, die für ihre Flexibilität und Skalierbarkeit in der Welt der Data Warehouses bekannt ist. Angesichts der steigenden Anforderungen und der zunehmenden Komplexität von Daten, die Unternehmen heute bewältigen müssen, bietet Data Vault eine effektive und effiziente Lösung.
Wir haben gesehen, wie sich die Data Vault-Modellierung in drei Schichten aufbaut: den Staging Layer, den Data Warehouse Layer (Raw Vault) und den Information Mart Layer (Business Vault). Jede dieser Schichten spielt eine entscheidende Rolle im Datenverarbeitungsprozess. Wir haben auch die drei Hauptkomponenten der Modellierung untersucht: Hubs, Links und Satelliten, die zusammen ein dynamisches und flexibles Modell bilden.
Die Evolution von 1.0 zu 2.0 hat die Anpassungsfähigkeit und Effizienz dieser Modellierungstechnik weiter verbessert. Mit fortschrittlichen Konzepten wie dem ETL-Prozess und Tools wie dem Data Vault Generator hat Data Vault 2.0 den Weg für eine noch agilere und reaktionsschnellere Datenverarbeitung geebnet.
Die Vorteile sind vielfältig und bedeutend, darunter eine reduzierte Time-to-Market, eine verbesserte Skalierbarkeit des Data Warehouses und eine effizientere Umsetzung von Geschäftsanforderungen. All dies führt zu verbesserten Analysefähigkeiten und letztlich zu fundierteren Geschäftsentscheidungen.
Schließlich sollte betont werden, dass trotz aller technischen Fortschritte und Vorteile, die Data Vault bietet, der wahre Wert in der Anwendung liegt. Es geht darum, die Macht der Daten zu nutzen, um Erkenntnisse zu gewinnen, Entscheidungen zu treffen und letztlich das Geschäft zu transformieren. In diesem Sinne laden wir Sie ein, über die Möglichkeiten nachzudenken, wie Ihr Unternehmen von der Implementierung von Data Vault profitieren könnte.
Data Vault – die wichtigsten FAQ’s
Was ist Data Vault?
Data Vault ist ein Modell zur Datenmodellierung und -speicherung, das entwickelt wurde, um langfristige Datenverlässlichkeit und Nachvollziehbarkeit zu gewährleisten. Es basiert auf der Idee, Daten in einem „Tresor“ zu speichern, sodass sie sicher sind und leicht abgerufen werden können.
Warum sollte ich Data Vault nutzen?
Data Vault bietet mehrere Vorteile, darunter eine hohe Flexibilität bei Änderungen der Geschäftsanforderungen, eine verbesserte Auditierbarkeit und Rückverfolgbarkeit der Daten, sowie eine bessere Unterstützung für parallele Entwicklung und Ladevorgänge.
Wie unterscheidet sich Data Vault von herkömmlichen Datenbankmodellen?
Im Gegensatz zu traditionellen Datenbankmodellen, die oft auf bestimmte Anwendungen oder Geschäftsprozesse zugeschnitten sind, ist Data Vault flexibler und robuster gegenüber Änderungen. Es ermöglicht eine effizientere und umfassendere Datenintegration und -speicherung.
Was sind Hubs, Links und Satelliten in Data Vault?
Hubs, Links und Satelliten sind die drei Hauptkomponenten von Data Vault. Hubs speichern eindeutige Geschäftsschlüssel, Links repräsentieren die Beziehungen zwischen Hubs und Satelliten speichern kontextbezogene Daten oder Attribute zu den Hubs und Links.
Ist Data Vault für jedes Unternehmen geeignet?
Obwohl Data Vault viele Vorteile bietet, ist es nicht unbedingt für jedes Unternehmen geeignet. Unternehmen müssen ihre spezifischen Anforderungen und Ziele in Bezug auf Datenmanagement und -analyse berücksichtigen. Für Unternehmen, die sich mit großen, komplexen Datenmengen auseinandersetzen, kann Data Vault jedoch eine effektive Lösung sein.
Wie implementiere ich Data Vault in meinem Unternehmen?
Die Implementierung von Data Vault erfordert in der Regel einen methodischen Ansatz, einschließlich der Identifizierung relevanter Datenquellen, der Gestaltung der Data Vault-Architektur und der Entwicklung von ETL-Prozessen (Extract, Transform, Load). Es ist oft empfehlenswert, auf Experten im Bereich Datenmanagement zurückzugreifen, um die Implementierung effizient und erfolgreich zu gestalten.